En septembre 2026, un H100 coûte environ 6,90 $ de l’heure chez AWS ou Azure, 11,06 $ par GPU chez Google Cloud, 3,99 $ chez Lambda, de 2,69 $ à 3,49 $ chez RunPod et à partir d’environ 1,50 $ sur Vast.ai. Les cartes grand public ne se trouvent que sur les places de marché : une RTX 4090 coûte de 0,31 $ à 0,34 $ de l’heure en bas de la fourchette, et 0,74 $ sur l’offre datacenter de RunPod. Pour le même H100, l’heure à la demande la plus chère vaut environ sept fois et demie la moins chère.
La suite de l’article montre d’où vient chaque chiffre, ce que recouvre le prix horaire et ce que coûtent de bout en bout trois tâches typiques. Tous les prix sont à la demande sauf mention contraire, en régions américaines (us-east-1 chez AWS, East US chez Azure, us-central1 chez Google Cloud), sous Linux, relevés en septembre 2026. Les prix bougent tous les mois : prenez-les comme un instantané et vérifiez la source avant d’engager de l’argent.
Les prix en un coup d’œil
GPU de datacenter, en dollars par GPU et par heure :
| Fournisseur | L4 24 Go | A10G / A10 24 Go | A100 80 Go | H100 |
|---|---|---|---|---|
| AWS | 0,81 $ (g6.xlarge) | 1,01 $ (g5.xlarge, A10G) | 3,43 $ (p4de à 8 GPU uniquement) | 6,88 $ (p5.4xlarge) |
| Google Cloud | 0,71 $ (g2-standard-4) | n.d. | 5,07 $ (a2-ultragpu-1g) | 11,06 $ (A3 à 8 GPU, ÷ 8) |
| Azure | n.d. | 3,20 $ (NV36ads A10 v5) | 3,67 $ (NC24ads A100 v4) | 6,98 $ (NC40ads H100 v5, NVL 94 Go) |
| Lambda | n.d. | n.d. | 2,79 $ | 3,99 $ |
| RunPod Community / Secure | n.d. / 0,49 $ | n.d. | 1,39 $ / 1,59 $ | 2,69 $ / 3,49 $ |
| Vast.ai | à partir d’environ 0,27 $ | n.d. | à partir d’environ 0,43 $ | à partir d’environ 1,47 $ |
n.d. signifie que nous n’avons trouvé aucune option mono-GPU correspondante dans la grille tarifaire du fournisseur. Cartes grand public, en dollars par heure :
| GPU | Vast.ai (offre la moins chère) | RunPod Community / Secure | Fourchette courante sur les sites de location |
|---|---|---|---|
| RTX 3090 24 Go | 0,11 – 0,13 $ | 0,22 $ / 0,50 $ | 0,11 – 0,31 $ |
| RTX 4090 24 Go | 0,31 – 0,33 $ | 0,34 $ / 0,74 $ | 0,30 – 0,46 $ |
| RTX 5090 32 Go | 0,41 – 0,47 $ | 0,69 $ / 0,99 $ | 0,41 – 0,69 $ |
AWS, Google Cloud, Azure et Lambda ne proposent pas de cartes RTX grand public. Les chiffres de Vast.ai sont des fourchettes parce que deux relevés de getdeploying.com le même jour donnaient des minimums légèrement différents, ce qui en dit long sur les prix d’une place de marché. La dernière colonne reprend la fourchette que le guide de tarification pour les fournisseurs GPUFlow a relevée sur Vast.ai, RunPod, Salad, SimplePod, TensorDock, Hyperstack et Lambda en septembre 2026.
Ce que recouvre le prix horaire
Ces chiffres ne désignent pas tout à fait le même produit, et cela compte plus que la deuxième décimale.
Une instance d’hyperscaler inclut bien plus que le GPU. La p5.4xlarge d’AWS est livrée avec 16 vCPU, 256 Gio de RAM et 3,84 To de NVMe local. La NC24ads A100 v4 d’Azure a 24 vCPU et 220 Gio de RAM. La NV36ads A10 v5, la taille d’Azure avec une A10 complète, a 36 vCPU, 440 Gio de RAM et une licence GRID pour postes de travail virtuels, ce qui explique en partie qu’elle coûte trois fois ce qu’AWS demande pour une carte comparable. Si seul le GPU vous intéresse, vous payez tout le reste quand même.
Certains GPU ne sont vendus que dans de grosses machines. Chez AWS, l’A100 80 Go est vendue en p4de.24xlarge : huit GPU, 27,45 $ de l’heure, sans taille plus petite. La machine H100 A3 High de Google Cloud de notre tableau est l’a3-highgpu-8g à 8 GPU, à 88,49 $ de l’heure. La grille de Lambda affiche un prix par GPU, mais les caractéristiques indiquées à côté du H100 (208 vCPU, 1 800 Gio de RAM) décrivent un système multi-GPU : vérifiez les tailles réellement disponibles avant de bâtir un budget sur 3,99 $.
Sur une place de marché, c’est le propriétaire de la machine qui fixe le prix. Sur Vast.ai, chaque hôte fixe son tarif, et le stockage comme la bande passante sont facturés à part, offre par offre. Le Community Cloud de RunPod met en relation des fournisseurs indépendants ; son Secure Cloud tourne dans des datacenters Tier 3 et Tier 4. La même RTX 4090 coûte 0,34 $ dans le premier et 0,74 $ dans le second.
Ce que le prix horaire laisse de côté (disque, transfert de données, temps de mise en route, temps d’inactivité) est traité dans le coût réel de la location d’un GPU. Sur une petite tâche, ces extras peuvent dépasser le coût du temps GPU.
Les prix du H100 côte à côte
Le graphique est à l’échelle. Deux choses sautent aux yeux. Les trois grands clouds se regroupent autour de 7 $ par GPU, Google Cloud nettement au-dessus pour sa machine A3 à 8 GPU. Et l’écart entre AWS et l’offre Vast.ai la moins chère dépasse un facteur quatre, pour une carte qui fait exactement les mêmes calculs.
Ce que vous achetez avec la différence est bien réel : un SLA, la paperasse de conformité, le reste de votre infrastructure à côté, et un contrat de support. Ce à quoi vous renoncez sur une place de marché l’est tout autant : l’hôte peut être un petit opérateur, la fiabilité varie d’une offre à l’autre, et il n’y a pas de SLA. Pour une expérience le temps d’un week-end, la place de marché l’emporte sans discussion. Pour un système de production réglementé, ce n’est souvent même pas une option.
Prix spot et interruptibles
Chaque fournisseur de ce comparatif vend sa capacité inutilisée moins cher, avec le risque qu’elle vous soit reprise.
| Instance | À la demande | Spot | Économie |
|---|---|---|---|
| AWS g6.xlarge (1× L4) | 0,805 $ | 0,605 $ | 25 % |
| AWS g5.xlarge (1× A10G) | 1,006 $ | 0,469 $ | 53 % |
| AWS p5.4xlarge (1× H100) | 6,88 $ | 2,623 $ | 62 % |
| Google Cloud g2-standard-4 (1× L4) | 0,707 $ | 0,403 $ | 43 % |
| Google Cloud a3-highgpu-8g (8× H100) | 88,49 $ | 41,60 $ | 53 % |
| Azure NC24ads A100 v4 (1× A100 80 Go) | 3,673 $ | 0,679 $ | 82 % |
| Azure NC40ads H100 v5 (1× H100 NVL) | 6,98 $ | 1,29 $ | 82 % |
Les prix spot d’Azure viennent de son API de prix de détail, où les tarifs spot de l’A100 et du H100 sont entrés en vigueur en juillet et août 2026. Le tarif spot du H100 était inférieur à l’offre H100 à la demande la moins chère que nous ayons trouvée sur les places de marché. Les prix spot changent souvent et la disponibilité n’est pas garantie : prenez-le comme un instantané.
Sur Vast.ai, les instances interruptibles sont « souvent 50 % moins chères, voire plus, que les instances à la demande » selon sa documentation ; getdeploying.com affichait des offres interruptibles de RTX 3090 à partir de 0,08 $. Le spot ne fait économiser que si votre tâche écrit des checkpoints et peut reprendre là où elle s’est arrêtée. Sinon, une interruption revient à payer deux fois les mêmes heures.
La place de GPUFlow
GPUFlow est aussi une place de marché, mais ce qu’on y loue est plus restreint. Les fournisseurs font tourner des modèles d’IA (généralement avec Ollama) sur leurs propres machines Linux, et vous louez l’un de ces GPU à l’heure pour obtenir une clé API compatible OpenAI (URL de base https://gpuflow.app/v1, avec /v1/chat/completions et /v1/models). Il n’y a ni SSH, ni shell, ni accès aux fichiers : impossible d’entraîner, de fine-tuner ou d’exécuter votre propre code. Pour appeler un modèle ouvert depuis un script ou une application, vous sautez toute l’installation : le modèle est déjà en place sur la machine du fournisseur.
GPUFlow ne fixe pas les prix : il n’y a donc pas de prix GPUFlow à mettre dans les tableaux. Voici plutôt comment fonctionne la tarification :
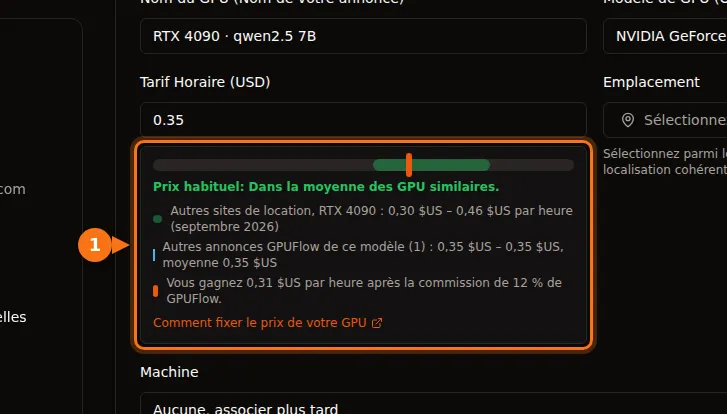
- Chaque fournisseur fixe un prix horaire en dollars américains pour son offre. Au moment de le saisir, le formulaire d’annonce lui montre où il se situe par rapport à la fourchette pratiquée sur les autres sites de location, et ce qu’il touchera après les frais.
- Vous réservez des heures entières, de 1 à 168 par défaut. Le montant total réservé est bloqué sur vos crédits au démarrage de la location.
- Vous payez à la seconde, avec un minimum d’une minute, arrondi au cent supérieur (facturation à la seconde ou à l’heure détaille les calculs). Si vous terminez plus tôt ou que le temps s’écoule, la partie non utilisée du montant bloqué revient directement dans vos crédits.
- Si la machine du fournisseur ne répond plus pendant 10 minutes, la location se termine et vous ne payez que jusqu’au dernier signal de présence (heartbeat) de la machine.
- Les tokens sont comptés mais pas facturés. Pas de ligne disque ni transfert de données sur la facture, puisque vous n’obtenez jamais de machine où stocker des fichiers.
- Les crédits s’achètent par carte via Stripe, de 10 $ à 500 $ par recharge, sans frais. 1 crédit vaut 0,01 $ et les crédits n’expirent pas. Les fournisseurs gardent 88 % de chaque montant facturé et GPUFlow 12 %.
Pour une comparaison plus complète entre louer une clé API et louer un conteneur, voir GPUFlow, Vast.ai, RunPod et SaladCloud comparés. Si vous comparez des prix de GPU à l’heure avec des API facturées au token, le calcul est ici.
Exemple 1 : un traitement par lots de 3 heures sur une carte de 24 Go
Disons que vous voulez passer une pile de documents dans un modèle ouvert de 7 à 8 milliards de paramètres pendant environ trois heures. N’importe quelle carte de 24 Go fera l’affaire.
| Option | Calcul | Coût GPU |
|---|---|---|
| Vast.ai RTX 4090 | 3 × 0,31 $ | 0,93 $ |
| RunPod Community RTX 4090 | 3 × 0,34 $ | 1,02 $ |
| Google Cloud L4 (g2-standard-4) | 3 × 0,707 $ | 2,12 $ |
| RunPod Secure RTX 4090 | 3 × 0,74 $ | 2,22 $ |
| AWS L4 (g6.xlarge) | 3 × 0,805 $ | 2,42 $ |
| AWS A10G (g5.xlarge) | 3 × 1,006 $ | 3,02 $ |
Sur chacune de ces options, vous payez aussi la mise en route : installer un serveur d’inférence et télécharger le modèle, sur du temps facturé. Vingt minutes de ce travail ajoutent 0,10 $ sur la carte Vast.ai et 0,27 $ sur la L4 d’AWS.
Sur GPUFlow, prenons pour exemple une offre à 0,35 $ de l’heure (c’est le prix de notre capture d’écran, pas un devis). Vous réservez 3 heures : 1,05 $ sont bloqués. La tâche se termine au bout de 2 heures 10 minutes (7 800 secondes) et vous mettez fin à la location. Le montant facturé est de 7 800 × 35 ÷ 3 600 = 75,8 cents, arrondi à 0,76 $, et 0,29 $ reviennent dans vos crédits. Cela suppose qu’un fournisseur fasse tourner le modèle qu’il vous faut.
Exemple 2 : 8 heures de fine-tuning sur une A100 80 Go
Le fine-tuning demande une machine que vous contrôlez : GPUFlow est donc hors jeu ici.
| Option | Calcul | Coût |
|---|---|---|
| Vast.ai, offre A100 la moins chère | 8 × 0,43 $ | 3,44 $ |
| RunPod Community A100 SXM | 8 × 1,39 $ | 11,12 $ |
| RunPod Secure A100 SXM | 8 × 1,59 $ | 12,72 $ |
| Lambda A100 SXM 80 Go | 8 × 2,79 $ | 22,32 $ |
| Azure NC24ads A100 v4 | 8 × 3,673 $ | 29,38 $ |
| Google Cloud a2-ultragpu-1g | 8 × 5,069 $ | 40,55 $ |
| AWS p4de.24xlarge (8 GPU) | 8 × 27,45 $ | 219,60 $ |
La ligne Vast.ai correspond à l’offre A100 la moins chère relevée par getdeploying.com (une carte SXM dans une machine à 2 GPU ; la quantité de mémoire n’était pas indiquée) : vérifiez l’offre avant de compter sur ce prix. La ligne AWS n’est pas une coquille : s’il vous faut une A100 80 Go chez AWS, vous en louez huit. La ligne Lambda suppose une taille réellement disponible, voir la remarque plus haut.
Si votre boucle d’entraînement enregistre des checkpoints toutes les 15 à 30 minutes, le prix spot d’Azure à 0,679 $ de l’heure ramène cette tâche à 5,43 $, à condition d’obtenir la capacité.
Exemple 3 : une L4 qui sert des requêtes jour et nuit
Un petit endpoint d’inférence qui tourne pendant un mois de 720 heures :
| Option | Calcul | Par mois |
|---|---|---|
| Vast.ai L4, offre la moins chère | 720 × 0,27 $ | 194,40 $ |
| RunPod Secure L4 | 720 × 0,49 $ | 352,80 $ |
| AWS g6.xlarge, réservée 1 an | 720 × 0,524 $ | 377,28 $ |
| Google Cloud g2-standard-4 | 720 × 0,707 $ | 509,04 $ |
| AWS g6.xlarge, à la demande | 720 × 0,805 $ | 579,60 $ |
Sur cette durée, les remises d’engagement commencent à peser : le tarif réservé 1 an d’AWS pour la même instance est 35 % sous le tarif à la demande. La place de marché reste la moins chère, mais un hôte unique est un point de défaillance unique. Si l’endpoint a des utilisateurs, vous voudrez sans doute deux machines, ce qui double la ligne de la place de marché et rend l’écart plus faible qu’il n’y paraît.
Comment je choisirais
Pour les expériences, la génération d’images, l’entraînement de LoRA et tout ce qui peut redémarrer : une RTX 3090 ou 4090 sur une place de marché. Le bas de la fourchette va de 0,11 $ à 0,34 $ de l’heure, et rien chez les grands clouds n’en approche.
Pour un gros modèle qui demande une A100 ou un H100, sans contrainte réglementaire : RunPod ou Lambda d’abord, Vast.ai si vous acceptez de vérifier le score de fiabilité de chaque hôte. Regardez les prix spot d’Azure et de Google Cloud avant de trancher ; en septembre 2026, ils étaient étonnamment compétitifs.
Pour des données réglementées, une entreprise qui tourne déjà sur AWS, Azure ou Google Cloud, ou tout ce qui exige un SLA : restez sur votre cloud et achetez des engagements ou de la capacité spot pour faire baisser le prix. Payer 7 $ de l’heure pour un H100 revient souvent moins cher que l’audit de sécurité d’un nouveau fournisseur.
Pour appeler un modèle ouvert depuis du code sans faire tourner de serveur : une API. Soit une API facturée au token si l’une d’elles héberge le modèle voulu, soit une location à l’heure sur GPUFlow si vous voulez un prix horaire fixe sur le modèle d’un fournisseur précis. Ce qu’il vous faut pour louer un GPU couvre la partie compte.
Sources
- AWS : tarification EC2 à la demande, instances P5, instances P4. Prix horaires lus dans la copie de la grille AWS tenue par Vantage : g6.xlarge, g5.xlarge, p5.4xlarge, p5.48xlarge, p4de.24xlarge
- Google Cloud : tarification des VM optimisées pour les accélérateurs, tarification des instances de VM
- Azure : tarification des VM Linux, API des prix de détail Azure, tailles : NC A100 v4, NCads H100 v5, NVads A10 v5
- Lambda : tarifs
- RunPod : tarifs, RTX 3090, RTX 4090, RTX 5090, A100 SXM, H100 SXM, présentation des pods
- Vast.ai : documentation tarifaire. Prix de la place de marché relevés sur getdeploying.com : Vast.ai, RTX 3090, RTX 4090, RTX 5090, A100, H100
- GPUFlow : fixer le prix de votre GPU, facturation, démarrage rapide de l’API, place de marché
Tous vérifiés en septembre 2026.