सितंबर 2026 में एक H100 AWS या Azure पर लगभग $6.90 प्रति घंटा, Google Cloud पर $11.06 प्रति GPU, Lambda पर $3.99, RunPod पर $2.69 से $3.49 और Vast.ai पर लगभग $1.50 से शुरू होता है। consumer कार्ड सिर्फ़ मार्केटप्लेस पर मिलते हैं: RTX 4090 सस्ते सिरे पर $0.31 से $0.34 प्रति घंटा और RunPod के data-center tier पर $0.74 का है। उसी H100 के लिए सबसे महँगा on-demand घंटा सबसे सस्ते से लगभग साढ़े सात गुना है।
बाक़ी पोस्ट में बताया गया है कि हर आँकड़ा कहाँ से आया, प्रति घंटा कीमत में क्या शामिल है, और तीन आम जॉब की शुरू से आख़िर तक लागत कितनी है। जब तक अलग से न लिखा हो, हर कीमत on-demand है, US regions (AWS पर us-east-1, Azure पर East US, Google Cloud पर us-central1), Linux, और सितंबर 2026 में जाँची गई है। कीमतें हर महीने बदलती हैं, इसलिए इन्हें एक snapshot मानें और पैसा लगाने से पहले स्रोत देख लें।
कीमतें एक नज़र में
data-center GPU, डॉलर प्रति GPU प्रति घंटा:
| Provider | L4 24 GB | A10G / A10 24 GB | A100 80 GB | H100 |
|---|---|---|---|---|
| AWS | $0.81 (g6.xlarge) | $1.01 (g5.xlarge, A10G) | $3.43 (सिर्फ़ 8-GPU p4de) | $6.88 (p5.4xlarge) |
| Google Cloud | $0.71 (g2-standard-4) | n/a | $5.07 (a2-ultragpu-1g) | $11.06 (8-GPU A3, ÷ 8) |
| Azure | n/a | $3.20 (NV36ads A10 v5) | $3.67 (NC24ads A100 v4) | $6.98 (NC40ads H100 v5, NVL 94 GB) |
| Lambda | n/a | n/a | $2.79 | $3.99 |
| RunPod Community / Secure | n/a / $0.49 | n/a | $1.39 / $1.59 | $2.69 / $3.49 |
| Vast.ai | लगभग $0.27 से | n/a | लगभग $0.43 से | लगभग $1.47 से |
n/a का मतलब है कि उस provider की price list में हमें कोई मेल खाता single-GPU विकल्प नहीं मिला। consumer कार्ड, डॉलर प्रति घंटा:
| GPU | Vast.ai (सबसे सस्ती लिस्टिंग) | RunPod Community / Secure | किराये की साइटों पर आम दायरा |
|---|---|---|---|
| RTX 3090 24 GB | $0.11 – $0.13 | $0.22 / $0.50 | $0.11 – $0.31 |
| RTX 4090 24 GB | $0.31 – $0.33 | $0.34 / $0.74 | $0.30 – $0.46 |
| RTX 5090 32 GB | $0.41 – $0.47 | $0.69 / $0.99 | $0.41 – $0.69 |
AWS, Google Cloud, Azure और Lambda consumer RTX कार्ड लिस्ट नहीं करते। Vast.ai के आँकड़े दायरे में हैं क्योंकि उसी दिन getdeploying.com के दो snapshots में न्यूनतम कीमत थोड़ी अलग थी, और यह ख़ुद मार्केटप्लेस की कीमतों के बारे में कुछ बताता है। आख़िरी कॉलम वह दायरा है जो GPUFlow provider pricing guide ने सितंबर 2026 में Vast.ai, RunPod, Salad, SimplePod, TensorDock, Hyperstack और Lambda से इकट्ठा किया।
प्रति घंटा कीमत में क्या शामिल है
ये आँकड़े पूरी तरह एक ही चीज़ के नहीं हैं, और यह बात दशमलव के दूसरे अंक से ज़्यादा मायने रखती है।
hyperscaler का instance GPU के अलावा बहुत कुछ साथ देता है। AWS के p5.4xlarge में 16 vCPUs, 256 GiB RAM और 3.84 TB local NVMe आता है। Azure के NC24ads A100 v4 में 24 vCPUs और 220 GiB RAM है। Azure का पूरे A10 वाला size NV36ads A10 v5 36 vCPUs, 440 GiB RAM और virtual workstations के लिए GRID license के साथ आता है, जो कुछ हद तक बताता है कि यह मिलते-जुलते कार्ड के लिए AWS से तीन गुना क्यों है। अगर आपको सिर्फ़ GPU चाहिए, तब भी पैसा इन सबका लगता है।
कुछ GPU सिर्फ़ बड़े डिब्बों में आते हैं। AWS पर A100 80 GB p4de.24xlarge के रूप में बिकता है: आठ GPU, $27.45 प्रति घंटा, इससे छोटा कोई size नहीं। हमारी तालिका में Google Cloud की A3 High H100 मशीन 8-GPU वाली a3-highgpu-8g है, $88.49 प्रति घंटा। Lambda की price list प्रति GPU कीमत दिखाती है, लेकिन H100 के बगल में लिखी मशीन की specs (208 vCPUs, 1,800 GiB RAM) एक multi-GPU सिस्टम की हैं, इसलिए $3.99 के भरोसे योजना बनाने से पहले देख लें कि असल में कौन-से size उपलब्ध हैं।
मार्केटप्लेस पर कीमत मशीन का मालिक तय करता है। Vast.ai पर हर host अपनी दर रखता है, और storage व bandwidth की कीमत हर लिस्टिंग में अलग से होती है। RunPod का Community Cloud स्वतंत्र providers को जोड़ता है; उसका Secure Cloud Tier 3 और Tier 4 data centers में चलता है। वही RTX 4090 पहले में $0.34 का है और दूसरे में $0.74 का।
प्रति घंटा कीमत जो छोड़ देती है (डिस्क, data transfer, setup का समय, idle समय), उस पर GPU किराये पर लेने की असली लागत में बात की गई है। छोटे जॉब पर ये अतिरिक्त ख़र्च GPU समय से बड़े हो सकते हैं।
H100 की कीमतें साथ-साथ
चार्ट स्केल पर बना है। दो बातें साफ़ दिखती हैं। तीन बड़े क्लाउड प्रति GPU लगभग $7 के आसपास हैं, और 8-GPU A3 मशीन की वजह से Google Cloud उससे काफ़ी ऊपर है। और AWS और Vast.ai की सबसे सस्ती लिस्टिंग के बीच चार गुना से ज़्यादा का अंतर है, उस कार्ड के लिए जो बिल्कुल वही गणना करता है।
अतिरिक्त पैसे से जो मिलता है, वह असली है: SLA, compliance के काग़ज़ात, आपका बाक़ी infrastructure बगल में, और support contract। मार्केटप्लेस पर जो छोड़ना पड़ता है, वह भी असली है: host कोई छोटा ऑपरेटर हो सकता है, भरोसेमंदी हर लिस्टिंग में अलग होती है, और कोई SLA नहीं मिलता। वीकेंड के प्रयोग के लिए मार्केटप्लेस आसानी से जीतता है। regulated production सिस्टम के लिए वह अक्सर विकल्प ही नहीं होता।
Spot और interruptible कीमतें
इस तुलना का हर provider अपनी बची हुई क्षमता सस्ते में बेचता है, इस जोखिम के साथ कि वह वापस ली जा सकती है।
| Instance | On-demand | Spot | बचत |
|---|---|---|---|
| AWS g6.xlarge (1× L4) | $0.805 | $0.605 | 25% |
| AWS g5.xlarge (1× A10G) | $1.006 | $0.469 | 53% |
| AWS p5.4xlarge (1× H100) | $6.88 | $2.623 | 62% |
| Google Cloud g2-standard-4 (1× L4) | $0.707 | $0.403 | 43% |
| Google Cloud a3-highgpu-8g (8× H100) | $88.49 | $41.60 | 53% |
| Azure NC24ads A100 v4 (1× A100 80 GB) | $3.673 | $0.679 | 82% |
| Azure NC40ads H100 v5 (1× H100 NVL) | $6.98 | $1.29 | 82% |
Azure की spot कीमतें उसके retail price API से ली गई हैं, जहाँ A100 और H100 की spot दरें जुलाई और अगस्त 2026 में लागू हुईं। H100 की spot दर मार्केटप्लेस पर मिली सबसे सस्ती on-demand H100 लिस्टिंग से भी कम थी। spot कीमतें अक्सर बदलती हैं और उपलब्धता की कोई गारंटी नहीं है, इसलिए इसे एक snapshot ही मानें।
Vast.ai के docs के मुताबिक़ उसके interruptible instances “अक्सर on-demand से 50%+ सस्ते” होते हैं; getdeploying.com पर RTX 3090 के interruptible ऑफ़र $0.08 से शुरू थे। spot से पैसा तभी बचता है जब आपका जॉब checkpoints लिखता हो और जहाँ रुका वहीं से आगे बढ़ सके। वरना एक रुकावट का मतलब है उन्हीं घंटों का दो बार भुगतान।
GPUFlow कहाँ फ़िट होता है
GPUFlow भी एक मार्केटप्लेस है, लेकिन वह एक सीमित चीज़ किराये पर देता है। providers अपनी Linux मशीनों पर AI मॉडल चलाते हैं (आमतौर पर Ollama के साथ), और आप उनमें से किसी GPU को घंटे के हिसाब से किराये पर लेकर OpenAI-compatible API key पाते हैं (base URL https://gpuflow.app/v1, /v1/chat/completions और /v1/models के साथ)। न SSH है, न shell, न फ़ाइलों तक पहुँच, इसलिए आप train, fine-tune या अपना code नहीं चला सकते। किसी script या app से open मॉडल कॉल करने के लिए setup पूरी तरह छूट जाता है: मॉडल provider की मशीन पर पहले से installed है।
GPUFlow कीमतें तय नहीं करता, इसलिए तालिकाओं में डालने के लिए कोई GPUFlow कीमत नहीं है। इसकी जगह यह है कि कीमतें कैसे काम करती हैं:
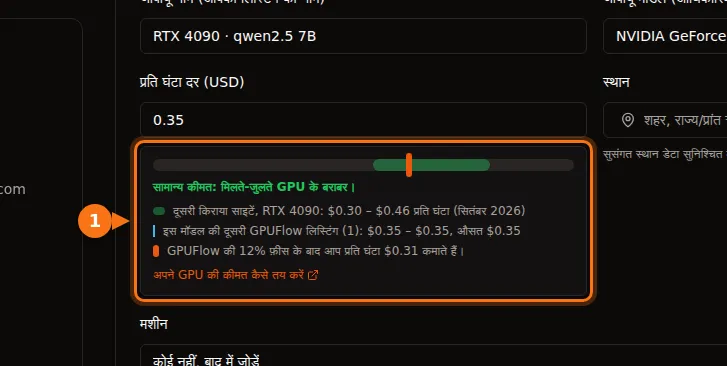
- हर provider अपनी लिस्टिंग के लिए US डॉलर में प्रति घंटा कीमत तय करता है। कीमत रखते समय लिस्टिंग फ़ॉर्म दिखाता है कि वह दूसरी किराये की साइटों के दायरे में कहाँ है और फ़ीस के बाद provider कितना कमाएगा।
- आप पूरे घंटे बुक करते हैं, डिफ़ॉल्ट रूप से 1 से 168। किराया शुरू होते ही बुक की गई पूरी राशि आपके क्रेडिट से रोक ली जाती है।
- आप प्रति सेकंड भुगतान करते हैं, 1 मिनट न्यूनतम के साथ, अगले सेंट तक ऊपर राउंड करके (प्रति सेकंड बनाम प्रति घंटा बिलिंग में पूरा हिसाब है)। जब आप जल्दी ख़त्म करते हैं या समय पूरा हो जाता है, तो रोकी गई राशि का इस्तेमाल न हुआ हिस्सा सीधे आपके क्रेडिट में लौट आता है।
- अगर provider की मशीन 10 मिनट तक जवाब नहीं देती, तो किराया ख़त्म हो जाता है और आप सिर्फ़ मशीन की आख़िरी heartbeat तक का पैसा देते हैं।
- tokens गिने जाते हैं, लेकिन उनका बिल नहीं बनता। बिल में डिस्क या data transfer की कोई पंक्ति नहीं होती, क्योंकि आपको फ़ाइलें रखने के लिए कोई मशीन मिलती ही नहीं।
- क्रेडिट Stripe के ज़रिए कार्ड से ख़रीदे जाते हैं, हर top-up $10 से $500, बिना फ़ीस। 1 क्रेडिट $0.01 है और क्रेडिट की कोई expiry नहीं है। providers हर शुल्क का 88% रखते हैं और GPUFlow 12%।
API key किराये पर लेने और container किराये पर लेने की लंबी तुलना के लिए GPUFlow vs Vast.ai vs RunPod vs SaladCloud देखें। अगर आप प्रति घंटा GPU कीमतों की तुलना प्रति token API से कर रहे हैं, तो उसका हिसाब यहाँ है।
उदाहरण 1: 24 GB कार्ड पर 3 घंटे का batch जॉब
मान लीजिए आप ढेर सारे दस्तावेज़ों पर लगभग तीन घंटे 7B से 8B का कोई open मॉडल चलाना चाहते हैं। कोई भी 24 GB कार्ड चलेगा।
| विकल्प | हिसाब | GPU लागत |
|---|---|---|
| Vast.ai RTX 4090 | 3 × $0.31 | $0.93 |
| RunPod Community RTX 4090 | 3 × $0.34 | $1.02 |
| Google Cloud L4 (g2-standard-4) | 3 × $0.707 | $2.12 |
| RunPod Secure RTX 4090 | 3 × $0.74 | $2.22 |
| AWS L4 (g6.xlarge) | 3 × $0.805 | $2.42 |
| AWS A10G (g5.xlarge) | 3 × $1.006 | $3.02 |
इनमें से हर एक पर आप setup का भी पैसा देते हैं: inference server install करना और मॉडल डाउनलोड करना, सब पैसे वाले समय में। इसके बीस मिनट Vast.ai कार्ड पर $0.10 और AWS L4 पर $0.27 जोड़ते हैं।
GPUFlow पर उदाहरण के लिए $0.35 प्रति घंटा की एक लिस्टिंग लें (यह हमारे screenshot की कीमत है, कोई quote नहीं)। आप 3 घंटे बुक करते हैं, तो $1.05 रोके जाते हैं। जॉब 2 घंटे 10 मिनट (7,800 सेकंड) में पूरा होता है और आप किराया ख़त्म कर देते हैं। शुल्क 7,800 × 35 ÷ 3,600 = 75.8 सेंट है, ऊपर राउंड होकर $0.76, और $0.29 आपके क्रेडिट में लौट आते हैं। यह तभी काम करता है जब कोई provider वह मॉडल चला रहा हो जो आपको चाहिए।
उदाहरण 2: A100 80 GB पर 8 घंटे की fine-tuning
fine-tuning के लिए ऐसी मशीन चाहिए जो आपके नियंत्रण में हो, इसलिए GPUFlow यहाँ बाहर है।
| विकल्प | हिसाब | लागत |
|---|---|---|
| Vast.ai, सबसे सस्ती A100 लिस्टिंग | 8 × $0.43 | $3.44 |
| RunPod Community A100 SXM | 8 × $1.39 | $11.12 |
| RunPod Secure A100 SXM | 8 × $1.59 | $12.72 |
| Lambda A100 SXM 80 GB | 8 × $2.79 | $22.32 |
| Azure NC24ads A100 v4 | 8 × $3.673 | $29.38 |
| Google Cloud a2-ultragpu-1g | 8 × $5.069 | $40.55 |
| AWS p4de.24xlarge (8 GPU) | 8 × $27.45 | $219.60 |
Vast.ai वाली पंक्ति getdeploying.com पर दर्ज सबसे सस्ती A100 लिस्टिंग है (2-GPU मशीन में एक SXM कार्ड; मेमोरी का size नहीं दिखाया गया था), इसलिए उस कीमत पर भरोसा करने से पहले लिस्टिंग देख लें। AWS वाली पंक्ति में कोई ग़लती नहीं है: अगर आपको AWS पर एक A100 80 GB चाहिए, तो आप आठ किराये पर लेते हैं। Lambda वाली पंक्ति मानती है कि आपको कोई ऐसा size मिल जाए जो सच में उपलब्ध हो, ऊपर का नोट देखें।
अगर आपका training loop हर 15 से 30 मिनट में checkpoint सेव करता है, तो Azure की $0.679 प्रति घंटा की spot कीमत पर यह जॉब $5.43 का पड़ता है, लेकिन तभी जब क्षमता मिल जाए।
उदाहरण 3: चौबीसों घंटे serve करता एक L4
720 घंटे के महीने भर चलने वाला एक छोटा inference endpoint:
| विकल्प | हिसाब | प्रति माह |
|---|---|---|
| Vast.ai L4, सबसे सस्ती लिस्टिंग | 720 × $0.27 | $194.40 |
| RunPod Secure L4 | 720 × $0.49 | $352.80 |
| AWS g6.xlarge, 1 साल reserved | 720 × $0.524 | $377.28 |
| Google Cloud g2-standard-4 | 720 × $0.707 | $509.04 |
| AWS g6.xlarge, on-demand | 720 × $0.805 | $579.60 |
इतनी अवधि पर commitment वाली छूट मायने रखने लगती है: उसी instance के लिए AWS की 1 साल की reserved दर on-demand से 35% कम है। मार्केटप्लेस अब भी सबसे सस्ता है, लेकिन एक अकेला host failure का अकेला बिंदु है। अगर endpoint के यूज़र हैं, तो शायद आप दो मशीनें चाहेंगे, जिससे मार्केटप्लेस वाली पंक्ति दोगुनी हो जाती है और अंतर जितना दिखता है उससे छोटा रह जाता है।
मैं कैसे चुनूँगा
प्रयोग, image generation, LoRA training और जो कुछ भी दोबारा शुरू किया जा सके: मार्केटप्लेस पर RTX 3090 या 4090। सस्ता सिरा $0.11 से $0.34 प्रति घंटा है, और बड़े क्लाउड पर कुछ भी इसके आसपास नहीं है।
किसी बड़े मॉडल के लिए जिसे A100 या H100 चाहिए और जो regulated नहीं है: पहले RunPod या Lambda, और Vast.ai अगर आप हर host का reliability score जाँचने को तैयार हैं। फ़ैसला करने से पहले Azure और Google Cloud की spot कीमतें देख लें; सितंबर 2026 में वे चौंकाने लायक प्रतिस्पर्धी थीं।
regulated डेटा, पहले से AWS, Azure या Google Cloud पर चल रही कंपनी, या जिसे भी SLA चाहिए: अपने क्लाउड पर ही रहें और कीमत घटाने के लिए commitments या spot क्षमता ख़रीदें। H100 के लिए $7 प्रति घंटा देना अक्सर किसी नए vendor की security review से सस्ता पड़ता है।
server चलाए बिना code से open मॉडल कॉल करने के लिए: एक API। या तो प्रति token API, अगर कोई आपका चाहा मॉडल host करता है, या GPUFlow पर घंटे के हिसाब से किराया, अगर आप किसी ख़ास provider के मॉडल पर तय प्रति घंटा कीमत चाहते हैं। GPU किराये पर लेने के लिए क्या चाहिए खाते वाला पक्ष बताता है।
स्रोत
- AWS: EC2 on-demand pricing, P5 instances, P4 instances। प्रति घंटा कीमतें AWS price list की Vantage वाली कॉपी से ली गईं: g6.xlarge, g5.xlarge, p5.4xlarge, p5.48xlarge, p4de.24xlarge
- Google Cloud: accelerator-optimized VM की कीमतें, VM instance की कीमतें
- Azure: Linux VM की कीमतें, Azure retail prices API, sizes: NC A100 v4, NCads H100 v5, NVads A10 v5
- Lambda: कीमतें
- RunPod: कीमतें, RTX 3090, RTX 4090, RTX 5090, A100 SXM, H100 SXM, pods का परिचय
- Vast.ai: कीमतों के docs। मार्केटप्लेस की कीमतें getdeploying.com से: Vast.ai, RTX 3090, RTX 4090, RTX 5090, A100, H100
- GPUFlow: अपने GPU की कीमत कैसे तय करें, बिलिंग, API quickstart, मार्केटप्लेस
सभी की जाँच सितंबर 2026 में की गई।