按每小时 $0.40 计算,一次 90 秒的测试,如果按秒计费、最低 60 秒,要 1¢;按分钟计费要 1.3¢;按整小时计费要 40¢。短任务的关键就在这 40 倍的差距上。任务一旦超过几分钟,按秒和按分钟计费的差别就不到 1 分钱,账单的大头取决于空闲时间、准备时间和存储费用。
下文包括:各平台公布的规则、带完整算式的示例、按比例绘制的图表,以及 GPUFlow 的“先预留、再退还”模式最终如何变成一笔扣费。规则和价格截至 2026 年 9 月,出处附在文末。
计算 GPU 时间的三种方式
每种 GPU 租用都有一个小时价。区别在于,用掉的时间在乘以小时价之前,要怎样换算成计费时间。
- 按秒计费,设最低收费。 按秒计数。如果总时长低于最低值(通常是 60 秒),按最低值收费。费用 = max(60, 秒数) × 小时价 / 3,600。
- 按分钟计费。 按分钟计数。各平台对不满一分钟的部分处理不同:有的向上取整,Azure 直接舍去。下面的示例中我都向上取整,这对你来说是更不利的情况。费用 = 分钟数 × 小时价 / 60。
- 按整小时计费。 只要开始了一个小时,就按整小时算。61 分钟的任务算两小时。费用 = ceil(秒数 / 3,600) × 小时价。
最低收费比大多数人想象的更重要。对于一分钟以内的任务,最低 60 秒的按秒计费和按分钟计费完全一样。计费粒度只影响任务结束时多出来的零头,所以每次会话多付的钱绝不会超过一个计费单位:按每小时 $0.40 的整小时计费,每次会话最多多付将近 40¢;同样价格下按分钟计费,每次会话多付不到 0.7¢(59 秒 × 40 / 3,600 = 0.66¢)。
各平台采用的规则
以下是按需实例的公开规则,均于 2026 年 9 月对照各厂商自己的文档核实。
| 平台 | 计费粒度 | 最低收费 | 文档中的说明 |
|---|---|---|---|
| AWS EC2 按需实例 | 按秒 | 60 秒 | 适用于 Linux、Windows、RHEL 和 Ubuntu Pro。SUSE Linux Enterprise Server 按整小时计费。 |
| Google Cloud Compute Engine | 按秒 | 1 分钟 | “所有 vCPU、GPU 和内存(GB)至少按 1 分钟收费。” |
| Azure 虚拟机 | 按分钟 | 未说明 | 按“完整分钟数”计费;运行 6 分 45 秒的虚拟机按 6 分钟计费。 |
| Lambda(按需云) | 按分钟 | 未说明 | 从实例通过健康检查开始,到你终止实例为止,“以一分钟为单位”计费。 |
| RunPod Pods | 按秒 | 未说明 | 计算和存储都按秒计费。 |
| Vast.ai | 按秒 | 未说明 | 活跃租用按秒计费;只要实例存在且未离线,存储也按秒计费。 |
| GPUFlow | 按秒 | 60 秒 | 按整秒计,向上取整到分,最高不超过预留金额。 |
读这张表时注意两点。Azure 的规则实际上是向下取整:它的 FAQ 写明“多出的秒数不计费”。Lambda 的文档只说以一分钟为单位,没说不满一分钟的部分怎么处理,所以我没有做任何假设。“未说明”就是字面意思:我读过的文档里没有提到最低收费,这和文档明确写着“零”不是一回事。
对于上面这些实例类型,没有哪个平台把 GPU 计算时间取整到整小时。但按小时取整仍会出现在细则里,比如 AWS 上的 SUSE,所以在新平台上跑大量短任务之前,先看一下计费页面。
每小时 $0.40 下的五个任务
下面用同一个价格,每小时 $0.40,套到五种任务时长上。也就是每 3,600 秒 40¢,每秒 1/90 分。
一次 90 秒的测试。 按秒:90 × 40 / 3,600 = 1.0¢。按分钟:2 分钟 × 40 / 60 = 1.33¢。按整小时:40¢。按小时的账单是按秒的 40 倍。
7 分 30 秒。 按秒:450 × 40 / 3,600 = 5.0¢。按分钟:8 分钟 × 40 / 60 = 5.33¢。按整小时:40¢,是按秒的 8 倍。
38 分 20 秒。 按秒:2,300 × 40 / 3,600 = 25.56¢。按分钟:39 分钟 × 40 / 60 = 26.0¢。按整小时:40¢,约为按秒的 1.57 倍。
61 分钟。 按秒:3,660 × 40 / 3,600 = 40.67¢。按分钟:61 × 40 / 60 = 40.67¢(任务正好在整分钟结束,所以两者一致)。按整小时:两小时,80¢。多出一分钟,按小时的账单就几乎翻倍。
| 任务时长 | 按秒(最低 60 秒) | 按分钟(向上取整) | 按整小时 | GPUFlow 扣费 |
|---|---|---|---|---|
| 1 分 30 秒 | 1.00¢ | 1.33¢ | 40¢ | 1¢ |
| 7 分 30 秒 | 5.00¢ | 5.33¢ | 40¢ | 5¢ |
| 38 分 20 秒 | 25.56¢ | 26.00¢ | 40¢ | 26¢ |
| 61 分 | 40.67¢ | 40.67¢ | 80¢ | 41¢ |
| 20 个 2 分 30 秒的任务 | 33.33¢ | 40.00¢ | $8.00 | 40¢(20 次租用) |
GPUFlow 一列是把按秒计费的结果按每次租用向上取整到整分,这正是它的计费代码的做法。最后一行在后面第二节解释。
费用与任务时长:按比例绘制
第一张图的横轴从 0 到 150 分钟。按分钟计费的阶梯每级宽 1 分钟、高 0.67¢,所以在这个比例下,它几乎和按秒计费的线重合。真正要看的是按整小时计费的阶梯:它在 0、60 和 120 分钟处各跳 40¢。
橙色阶梯和蓝色线之间的差距,就是每个任务因按小时取整多付的钱:在每一级刚跳上去时最大,在整点时为零。
放大到前十分钟,按分钟计费的阶梯就显现出来了,60 秒的最低收费则表现为按秒计费线开头那段平台。按整小时计费在这里是一条 40¢ 的水平线,比这张图的顶端高出五倍。
一天的短任务
短任务很少只跑一个。假设你一个工作日跑 20 个任务,每个 2 分 30 秒,每次都新开一个实例。
- 按秒: 20 × 150 秒 = 3,000 秒,3,000 × 40 / 3,600 = 33.33¢。
- 按分钟,向上取整: 每个任务算 3 分钟,合计 60 分钟:40¢。
- 按整小时: 每个任务都算一个已开始的小时:20 × 40¢ = $8.00。
同样 50 分钟的 GPU 工作,按小时计费要花 24 倍的钱。显而易见的变通办法是让一台机器开一整天。8 小时 × $0.40 = $3.20,比 $8.00 便宜,但仍是按秒账单的 9.6 倍,因为现在你要为任务之间的空档付钱。
不过这个例子对“每次新开实例”的做法有些美化,因为它假设机器一启动任务就开始。实际并非如此。举个例子,假设每次启动要花 3 分钟开机、拉取镜像、加载模型,然后才开始干活(你的实际数字会不同)。那么按秒计费要收 20 × 330 秒 = 6,600 秒,也就是 73.33¢,是实际工作 33.33¢ 的两倍多。计费粒度没变,浪费转移到了准备阶段。
在 GPUFlow 上,同样的一天略有不同,因为租用按整小时预订、按秒计费。分别开 20 次、每次 150 秒的租用,每次费用为 ceil(150 × 40 / 3,600) = ceil(1.67) = 2¢,合计 40¢。每次租用向上取整到整分,在这里每个任务多出 0.33¢,比按秒总额多出的 6.67¢ 就是这么来的。如果任务集中在一起跑,要注意每位用户每小时最多新开 10 次租用的限制。开一次租用挂一整天,则要按全部实际时长付费,8 小时 = $3.20,因为 GPUFlow 按时间计费,不按 token 收费。
比计费粒度更重要的事
任务一旦超过十分钟左右,按秒还是按分钟就只是个舍入误差了。下面三件事可不是。更详细的讨论见GPU 租用的真实成本。
空闲时间
所有按秒计费的平台,只要实例在运行就收费,不管 GPU 有没有在干活。Lambda 的文档说得很直接:实例“无论是否在实际使用”都会计费。上面那一天的短任务就能说明量级:50 分钟的工作,如果机器开 8 小时,就是 $3.20。忘了关的机器,什么计费粒度都救不回来。
准备时间
开机、拉取镜像和下载模型都在计费期间进行。Lambda 在实例通过健康检查后就开始计费,这时你的代码还什么都没做。按秒计费消除不了这部分成本;每次启动你都要付一遍。
停机期间的存储
停掉机器通常会停止 GPU 计费,但磁盘会继续收费。RunPod 对已停止 pod 的卷磁盘按每 GB 每月 $0.20 收费,是运行时价格的两倍,其文档还提醒“已停止的 Pod 会继续产生存储费用”。Vast.ai 也直说“停止实例并不能免除存储费用”。一个 100 GB 的卷留在已停止的 RunPod pod 上,每月要 100 × $0.20 = $20,相当于每小时 $0.40 的 GPU 用上 50 小时。
如果你的工作负载是调用某个模型,而不是在机器上跑自己的代码,那还应该和按 token 计费比较一下:按小时租 GPU 还是按 token 调 API一文分析了两者各自什么时候更便宜。
GPUFlow 如何计费:先预留,再退还余额
GPUFlow 出租的是推理服务:你拿到的是一个 OpenAI 兼容 API 密钥,对应某人 GPU 上运行的模型,而不是一台机器。没有 shell、磁盘或镜像需要付费,所以上一节的存储和准备时间都不适用。空闲时间则适用:租用从开始到结束都计费,不管忙不忙。
步骤如下:
- 你选择一条上架信息和一个整数小时数(默认 1 到 168 小时)。提供商的小时价会换算成整数分。
- 开始时,从你的额度中预留全部预订金额:每小时价格(分)× 小时数。这是全额,而且是预先扣下的。
- 租用结束时,一次性计算扣费:实际使用的整秒数(至少 60 秒)乘以每小时价格(分),除以 3,600,向上取整到分,且绝不超过预留金额。
- 预留金额剩下的部分在同一步退回你的可用额度。
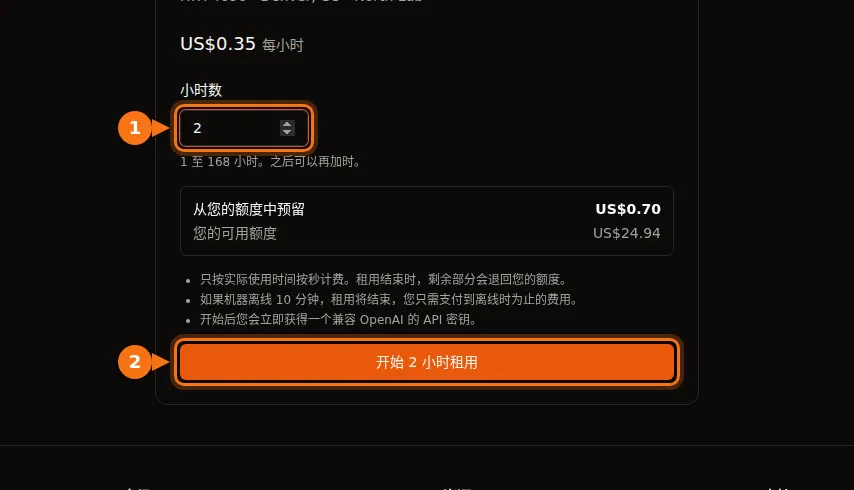
租用表单在开始前就会显示预留金额:每小时 $0.35 租 2 小时,预留 $0.70。
算例
以每小时 $0.40 预订 3 小时。预留金额为 40¢ × 3 = 120¢($1.20)。38 分 20 秒后你点击 立即结束,也就是 2,300 秒。
- 扣费:ceil(2,300 × 40 / 3,600) = ceil(25.56) = 26¢。
- 退回你的额度:120 − 26 = 94¢。
- 平台手续费是扣费的 12%,每次租用四舍五入到分:round(26 × 0.12) = round(3.12) = 3¢。提供商得到 26 − 3 = 23¢,占这笔扣费的 88.5%,而不是正好 88%。扣费金额越大,舍入的影响越小。
你不操作时租用如何结束
如果预订的时长用完,一个每分钟运行一次的后台任务会结算这次租用。扣费计算到预订的结束时间为止,所以后台任务运行前的延迟不会让你多付钱。API 密钥在结束时间失效。想要更多时间,可以点 加时,这会再预留一些额度,密钥保持不变。
如果提供商的机器没了动静,租用也会结束。提供商机器上的代理每 15 秒发送一次心跳。10 分钟收不到心跳,租用就会结束,并只计费到最后一次心跳为止。按每小时 $0.40 计算,一台机器在 3 小时预订的第 25 分钟掉线,费用为 ceil(1,500 × 40 / 3,600) = 17¢,120¢ 预留金额中另外的 103¢ 会退回。
按整小时预订和 61 分钟的任务之间有个坑。如果你预订了 1 小时,又忘了在用完前点 加时,密钥会在 60 分钟时失效,你要为一个没跑完的任务付 40¢。预订 2 小时(预留 80¢),在 61 分钟时结束,你付 41¢,退回 39¢。拿不准时就订长一点、提前结束;没用完的时间不花钱。
按任务形态选择计费方式
- 大量 10 分钟以内的任务: 选按秒或按分钟计费,并查一下最低收费。任何按小时取整的方式都不适合这种场景。
- 30 到 90 分钟的任务: 避开按整小时取整(61 分钟的任务要付两小时的钱)。按秒和按分钟的差别每个任务不到 1 分钱。
- 长达数小时的运行: 计费粒度几乎没有影响。要看的是空闲时间、准备时间和存储。
- 全天断断续续地调用同一个模型: 每次调用高峰都新开机器,每次都要付准备时间;一直开着一台机器,则要为空档付钱。租用一个始终加载好模型的推理服务,是避开准备时间的一种办法,但调用之间计时照样在走,所以预订时长要和你实际工作的时间对上。
如果想试一试,GPUFlow 市场列出了每块 GPU 的小时价,租用 GPU 需要准备什么介绍了账户和付款方面的事项。
资料来源
- AWS,Amazon EC2 按需实例价格(计费详情):aws.amazon.com/ec2/pricing/on-demand
- Google Cloud,虚拟机实例价格(计费模式):cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure,Linux 虚拟机价格(FAQ):azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda,计费概览:docs.lambda.ai/public-cloud/billing
- RunPod,Pod 价格:docs.runpod.io/pods/pricing
- Vast.ai,计费参考:docs.vast.ai/documentation/reference/billing
- GPUFlow 文档,额度、计费和退款:docs.gpuflow.app/zh-cn/renters/billing
均于 2026 年 9 月核实。