В сентябре 2026 года один H100 стоит около $6,90 в час в AWS или Azure, $11,06 за GPU в Google Cloud, $3,99 в Lambda, от $2,69 до $3,49 на RunPod и примерно от $1,50 на Vast.ai. Потребительские карты есть только на маркетплейсах: RTX 4090 стоит $0,31–0,34 в час в дешёвом сегменте и $0,74 в дата-центровом тарифе RunPod. Самый дорогой час H100 по требованию обходится примерно в семь с половиной раз дороже самого дешёвого.
Дальше — откуда взялась каждая цифра, что входит в почасовую цену и сколько от начала до конца стоят три типичные задачи. Все цены — по требованию, если не указано иное, регионы США (us-east-1 в AWS, East US в Azure, us-central1 в Google Cloud), Linux, проверено в сентябре 2026 года. Цены меняются каждый месяц, так что считайте это снимком и сверяйтесь с источником, прежде чем тратить деньги.
Цены коротко
Дата-центровые GPU, доллары за GPU в час:
| Провайдер | L4 24 ГБ | A10G / A10 24 ГБ | A100 80 ГБ | H100 |
|---|---|---|---|---|
| AWS | $0,81 (g6.xlarge) | $1,01 (g5.xlarge, A10G) | $3,43 (только 8-GPU p4de) | $6,88 (p5.4xlarge) |
| Google Cloud | $0,71 (g2-standard-4) | нет | $5,07 (a2-ultragpu-1g) | $11,06 (8-GPU A3, ÷ 8) |
| Azure | нет | $3,20 (NV36ads A10 v5) | $3,67 (NC24ads A100 v4) | $6,98 (NC40ads H100 v5, NVL 94 ГБ) |
| Lambda | нет | нет | $2,79 | $3,99 |
| RunPod Community / Secure | нет / $0,49 | нет | $1,39 / $1,59 | $2,69 / $3,49 |
| Vast.ai | примерно от $0,27 | нет | примерно от $0,43 | примерно от $1,47 |
«Нет» значит, что в прайс-листе провайдера мы не нашли подходящего варианта с одним GPU. Потребительские карты, доллары в час:
| GPU | Vast.ai (самое дешёвое предложение) | RunPod Community / Secure | Обычный диапазон на сайтах аренды |
|---|---|---|---|
| RTX 3090 24 ГБ | $0,11 – $0,13 | $0,22 / $0,50 | $0,11 – $0,31 |
| RTX 4090 24 ГБ | $0,31 – $0,33 | $0,34 / $0,74 | $0,30 – $0,46 |
| RTX 5090 32 ГБ | $0,41 – $0,47 | $0,69 / $0,99 | $0,41 – $0,69 |
AWS, Google Cloud, Azure и Lambda потребительские карты RTX не предлагают. Цифры Vast.ai даны диапазонами, потому что два снимка getdeploying.com в один и тот же день показали немного разные минимумы, — это само по себе многое говорит о ценах на маркетплейсах. Последний столбец — диапазон, который руководство по ценам для провайдеров GPUFlow собрало в сентябре 2026 года по Vast.ai, RunPod, Salad, SimplePod, TensorDock, Hyperstack и Lambda.
Что входит в почасовую цену
Эти цифры описывают не совсем одинаковый товар, и это важнее второго знака после запятой.
Инстанс у гиперскейлера включает много всего помимо GPU. p5.4xlarge в AWS — это 16 vCPU, 256 ГиБ оперативной памяти и 3,84 ТБ локального NVMe. NC24ads A100 v4 в Azure — 24 vCPU и 220 ГиБ памяти. Размер NV36ads A10 v5 с целой A10 в Azure даёт 36 vCPU, 440 ГиБ памяти и лицензию GRID для виртуальных рабочих станций — отчасти поэтому он стоит втрое дороже, чем AWS берёт за похожую карту. Если вам нужен только GPU, за всё остальное вы всё равно платите.
Некоторые GPU продаются только в больших машинах. В AWS A100 80 ГБ доступен как p4de.24xlarge: восемь GPU, $27,45 в час, меньших размеров нет. Машина A3 High с H100 в Google Cloud из нашей таблицы — это 8-GPU a3-highgpu-8g за $88,49 в час. В прайс-листе Lambda указана цена за GPU, но характеристики машины рядом с H100 (208 vCPU, 1800 ГиБ памяти) описывают систему с несколькими GPU, так что проверьте, какие размеры реально доступны, прежде чем рассчитывать на $3,99.
На маркетплейсах цену назначает владелец машины. На Vast.ai каждый хост сам ставит тариф, а хранилище и трафик оцениваются отдельно в каждом предложении. RunPod Community Cloud объединяет независимых провайдеров, а Secure Cloud работает в дата-центрах уровня Tier 3 и Tier 4. Одна и та же RTX 4090 стоит $0,34 в первом и $0,74 во втором.
То, что в почасовую цену не входит (диск, трафик, время на подготовку, простой), разобрано в статье сколько на самом деле стоит аренда GPU. На маленькой задаче эти расходы могут превысить стоимость самого GPU.
Цены на H100 рядом
График построен в масштабе. Бросаются в глаза две вещи. Три крупнейших облака держатся около $7 за GPU, а Google Cloud с 8-GPU машиной A3 заметно выше. И разница между AWS и самым дешёвым предложением на Vast.ai — больше чем в четыре раза за карту, которая считает то же самое.
За лишние деньги вы получаете вполне реальные вещи: SLA, документы для комплаенса, остальную инфраструктуру по соседству и договор на поддержку. От чего вы отказываетесь на маркетплейсе — тоже вполне реально: хостом может быть небольшой частник, надёжность зависит от конкретного предложения, SLA нет. Для эксперимента на выходных маркетплейс легко выигрывает. Для регулируемой продакшен-системы он часто вообще не вариант.
Цены на spot и прерываемые инстансы
Каждый провайдер из этого сравнения продаёт свободные мощности дешевле — с риском, что их заберут.
| Инстанс | По требованию | Spot | Экономия |
|---|---|---|---|
| AWS g6.xlarge (1× L4) | $0,805 | $0,605 | 25% |
| AWS g5.xlarge (1× A10G) | $1,006 | $0,469 | 53% |
| AWS p5.4xlarge (1× H100) | $6,88 | $2,623 | 62% |
| Google Cloud g2-standard-4 (1× L4) | $0,707 | $0,403 | 43% |
| Google Cloud a3-highgpu-8g (8× H100) | $88,49 | $41,60 | 53% |
| Azure NC24ads A100 v4 (1× A100 80 ГБ) | $3,673 | $0,679 | 82% |
| Azure NC40ads H100 v5 (1× H100 NVL) | $6,98 | $1,29 | 82% |
Spot-цены Azure взяты из его API розничных цен, где ставки spot для A100 и H100 вступили в силу в июле и августе 2026 года. Spot-цена H100 оказалась ниже самого дешёвого предложения H100 по требованию, которое мы нашли на маркетплейсах. Spot-цены часто меняются, а доступность не гарантирована, так что это тоже снимок.
На Vast.ai прерываемые инстансы, по словам документации, «часто на 50% и более дешевле, чем по требованию»; getdeploying.com показывал прерываемые предложения RTX 3090 от $0,08. Spot экономит деньги, только если ваша задача пишет контрольные точки и может продолжить с места остановки. Иначе прерывание означает, что за одни и те же часы вы платите дважды.
Где здесь GPUFlow
GPUFlow — тоже маркетплейс, но сдаёт он более узкую вещь. Провайдеры запускают AI-модели (обычно через Ollama) на своих Linux-машинах, а вы арендуете такой GPU почасово и получаете OpenAI-совместимый API-ключ (base URL https://gpuflow.app/v1, эндпоинты /v1/chat/completions и /v1/models). Нет ни SSH, ни командной оболочки, ни доступа к файлам, поэтому обучать, дообучать или запускать свой код нельзя. Зато если нужно обращаться к открытой модели из скрипта или приложения, подготовка не нужна вовсе: модель уже установлена на машине провайдера.
Цены GPUFlow не назначает, поэтому цены GPUFlow в таблицах нет. Вместо неё — как устроено ценообразование:
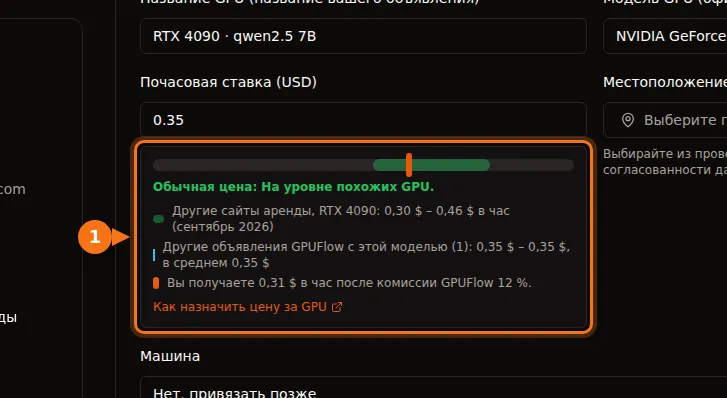
- Каждый провайдер сам назначает почасовую цену своего объявления в долларах США. При этом форма объявления показывает, где эта цена находится относительно диапазона на других сайтах аренды и сколько провайдер получит после комиссии.
- Вы бронируете целые часы, по умолчанию от 1 до 168. Вся забронированная сумма резервируется из ваших кредитов при старте аренды.
- Оплата посекундная, с минимумом 1 минута и округлением вверх до цента (расчёты — в статье посекундная или почасовая оплата). Если вы завершаете аренду раньше или время истекает, неиспользованная часть резерва сразу возвращается в кредиты.
- Если машина провайдера 10 минут не отвечает, аренда завершается, а вы платите только до последнего heartbeat-сигнала машины.
- Токены считаются, но не оплачиваются. Строк за диск или трафик в счёте нет, потому что машины для хранения файлов вы не получаете.
- Кредиты покупаются картой через Stripe, от $10 до $500 за пополнение, без комиссии. 1 кредит — это $0,01, срок действия у кредитов не ограничен. Провайдеры получают 88% каждого списания, GPUFlow — 12%.
Подробное сравнение аренды API-ключа и аренды контейнера — в статье GPUFlow против Vast.ai, RunPod и SaladCloud. Если сравниваете почасовые цены на GPU с API с оплатой за токены, расчёт здесь.
Пример 1: пакетная задача на 3 часа на карте с 24 ГБ
Допустим, нужно прогнать открытую модель на 7–8B по пачке документов примерно за три часа. Подойдёт любая карта с 24 ГБ.
| Вариант | Расчёт | Стоимость GPU |
|---|---|---|
| Vast.ai RTX 4090 | 3 × $0,31 | $0,93 |
| RunPod Community RTX 4090 | 3 × $0,34 | $1,02 |
| Google Cloud L4 (g2-standard-4) | 3 × $0,707 | $2,12 |
| RunPod Secure RTX 4090 | 3 × $0,74 | $2,22 |
| AWS L4 (g6.xlarge) | 3 × $0,805 | $2,42 |
| AWS A10G (g5.xlarge) | 3 × $1,006 | $3,02 |
Везде здесь вы платите ещё и за подготовку: установка сервера инференса и скачивание модели идут в оплачиваемое время. Двадцать минут на это добавляют $0,10 на карте с Vast.ai и $0,27 на L4 в AWS.
На GPUFlow возьмём для примера объявление за $0,35 в час (это цена с нашего скриншота, а не предложение). Вы бронируете 3 часа, резервируется $1,05. Задача заканчивается через 2 часа 10 минут (7800 секунд), и вы завершаете аренду. Списание — 7800 × 35 ÷ 3600 = 75,8 цента с округлением вверх до $0,76, а $0,29 возвращается в кредиты. Это работает, только если у какого-то провайдера запущена нужная вам модель.
Пример 2: 8 часов дообучения на A100 80 ГБ
Для дообучения нужна машина под вашим контролем, так что GPUFlow здесь не подходит.
| Вариант | Расчёт | Стоимость |
|---|---|---|
| Vast.ai, самое дешёвое предложение A100 | 8 × $0,43 | $3,44 |
| RunPod Community A100 SXM | 8 × $1,39 | $11,12 |
| RunPod Secure A100 SXM | 8 × $1,59 | $12,72 |
| Lambda A100 SXM 80 ГБ | 8 × $2,79 | $22,32 |
| Azure NC24ads A100 v4 | 8 × $3,673 | $29,38 |
| Google Cloud a2-ultragpu-1g | 8 × $5,069 | $40,55 |
| AWS p4de.24xlarge (8 GPU) | 8 × $27,45 | $219,60 |
Строка Vast.ai — самое дешёвое предложение A100, которое показал getdeploying.com (карта SXM в машине с 2 GPU; объём памяти не указан), так что проверьте предложение, прежде чем рассчитывать на эту цену. Строка AWS — не опечатка: если в AWS нужен один A100 80 ГБ, вы арендуете восемь. Строка Lambda предполагает размер, который реально можно получить, — см. замечание выше.
Если ваш цикл обучения сохраняет контрольные точки каждые 15–30 минут, spot-цена Azure $0,679 в час снижает стоимость этой задачи до $5,43 — но только если удастся получить мощности.
Пример 3: L4, которая обслуживает запросы круглосуточно
Небольшой эндпоинт инференса, работающий весь месяц — 720 часов:
| Вариант | Расчёт | В месяц |
|---|---|---|
| Vast.ai L4, самое дешёвое предложение | 720 × $0,27 | $194,40 |
| RunPod Secure L4 | 720 × $0,49 | $352,80 |
| AWS g6.xlarge, резерв на 1 год | 720 × $0,524 | $377,28 |
| Google Cloud g2-standard-4 | 720 × $0,707 | $509,04 |
| AWS g6.xlarge, по требованию | 720 × $0,805 | $579,60 |
На таком сроке начинают играть роль скидки за обязательства: годовой резерв AWS для того же инстанса на 35% дешевле цены по требованию. Маркетплейс по-прежнему дешевле всех, но один хост — это единая точка отказа. Если у эндпоинта есть пользователи, вам, скорее всего, нужны две машины, а это удваивает строку маркетплейса, и разрыв оказывается меньше, чем кажется.
Как выбирал бы я
Для экспериментов, генерации изображений, обучения LoRA и всего, что можно перезапустить, — RTX 3090 или 4090 на маркетплейсе. Дешёвый сегмент — $0,11–0,34 в час, и ничего в больших облаках даже близко не стоит.
Для большой модели, которой нужен A100 или H100, без регуляторных требований — сначала RunPod или Lambda, Vast.ai — если готовы проверять рейтинг надёжности каждого хоста. Прежде чем решать, посмотрите spot-цены в Azure и Google Cloud: в сентябре 2026 года они были на удивление конкурентными.
Для регулируемых данных, для компании, которая уже работает в AWS, Azure или Google Cloud, или для всего, где нужен SLA, — оставайтесь в своём облаке и снижайте цену за счёт обязательств или spot-мощностей. Платить $7 в час за H100 часто дешевле, чем проходить проверку безопасности нового поставщика.
Чтобы обращаться к открытой модели из кода, не поднимая сервер, — API. Либо API с оплатой за токены, если нужная модель там есть, либо почасовая аренда на GPUFlow, если хотите фиксированную почасовую цену на модель конкретного провайдера. Про аккаунт и оплату — в статье что нужно для аренды GPU.
Источники
- AWS: цены EC2 по требованию, инстансы P5, инстансы P4. Почасовые цены взяты из копии прайс-листа AWS на Vantage: g6.xlarge, g5.xlarge, p5.4xlarge, p5.48xlarge, p4de.24xlarge
- Google Cloud: цены на ВМ, оптимизированные под ускорители, цены на инстансы ВМ
- Azure: цены на ВМ Linux, API розничных цен Azure, размеры: NC A100 v4, NCads H100 v5, NVads A10 v5
- Lambda: цены
- RunPod: цены, RTX 3090, RTX 4090, RTX 5090, A100 SXM, H100 SXM, обзор подов
- Vast.ai: документация по ценам. Цены маркетплейса по данным getdeploying.com: Vast.ai, RTX 3090, RTX 4090, RTX 5090, A100, H100
- GPUFlow: как назначить цену на свой GPU, оплата, быстрый старт с API, каталог
Всё проверено в сентябре 2026 года.