بتكميم 4-bit الذي يأتي به Ollama افتراضياً، يحتاج نموذج 7B أو 8B إلى بطاقة 8 GB، وتحتاج نماذج 12B إلى 14B إلى 12 GB (أو 16 GB إذا أردت موجّهات طويلة)، وتحتاج نماذج 27B إلى 32B إلى 24 GB. أما نموذج 70B بتكميم 4-bit فحجمه 43 GB، أي أنه يحتاج إلى 48 GB من VRAM أو أكثر.
التفاصيل مهمة لأن حجم التنزيل ليس كل الحساب. السياق الذي تستخدمه يستهلك ذاكرة أيضاً، والنموذج الذي يبدو أنه يتسع قد ينتهي به الأمر نصفه على المعالج المركزي وأبطأ بعدة مرات. فيما يلي المعادلة التي أستخدمها، ومعنى تسميات التكميم، وجدول بالنماذج المفتوحة الحالية وأحجام تنزيلها الحقيقية من مكتبة Ollama. راجعت الأحجام والمواصفات في سبتمبر 2026، والمصادر في آخر المقال.
الإجابة السريعة حسب حجم VRAM
| VRAM | بطاقات نموذجية | ما يعمل بالكامل على GPU (4-bit) |
|---|---|---|
| 8 GB | RTX 4060، RTX 5060، RTX 3070 | نماذج 7B إلى 8B: Llama 3.1 8B وQwen3 8B وMistral 7B |
| 12 GB | RTX 3060 12 GB، RTX 4070، RTX 5070 | نماذج 12B إلى 14B بسياق قصير؛ و7B إلى 8B بصيغة Q8_0 |
| 16 GB | RTX 4060 Ti 16 GB، RTX 4080، RTX 5080 | 14B بسياق طويل، وgpt-oss 20B |
| 24 GB | RTX 3090، RTX 4090 | من 24B إلى 32B: Mistral Small 3.2 وGemma 3 27B وQwen3 32B |
| 32 GB | RTX 5090 | 32B بسياق طويل، ونماذج مزيج الخبراء (MoE) بحجم 35B |
| 48 إلى 80 GB | L40S (48 GB)، H100 (80 GB) | 70B بتكميم 4-bit، وgpt-oss 120B على 80 GB |
أحجام ذاكرة البطاقات مأخوذة من صفحات المواصفات لدى NVIDIA. بعض البطاقات تأتي بنسختين: RTX 3060 موجودة بذاكرة 12 GB و8 GB، وRTX 4060 Ti وRTX 5060 Ti بذاكرة 16 GB و8 GB. تأكد من النسخة التي تشتريها أو تستأجرها.
كيف تقدّر مقدار VRAM الذي يحتاجه النموذج
ثلاثة أشياء تشغل ذاكرة GPU بينما يجيبك النموذج:
- الأوزان. عدد المعاملات × البتات لكل وزن ÷ 8 = عدد البايتات.
- ذاكرة KV المؤقتة (KV cache). يحتفظ النموذج بالمفاتيح والقيم لكل توكن في المحادثة حتى لا يعيد حسابها. لكل توكن يساوي ذلك 2 × عدد الطبقات × عدد رؤوس KV × حجم الرأس × 2 بايت (مع الذاكرة الافتراضية بدقة 16 بت). اضرب الناتج في طول السياق.
- الحمل الإضافي. سياق CUDA ومخازن العمل المؤقتة وبيئة التشغيل نفسها. أحسب له نحو 1 GB. يختلف حسب المحرك والإعدادات، فاعتبره قاعدة تقريبية لا مواصفة.
تجد عدد الطبقات والرؤوس في ملف config.json لكل نموذج على Hugging Face.
مثال محسوب: Qwen 2.5 14B على بطاقة 16 GB
لدى Qwen 2.5 14B 14.7 مليار معامل، و48 طبقة، و8 رؤوس KV، وحجم رأس 128 (حجم مخفي 5,120 ÷ 40 رأس انتباه).
- الأوزان بصيغة Q4_K_M: يذكر llama.cpp أن Q4_K_M يستخدم نحو 4.89 بت لكل وزن. 14.7 مليار × 4.89 ÷ 8 = 8.99 GB. حجم تنزيل
qwen2.5:14bفي Ollama هو 9.0 GB، فالحساب يطابق الملف الحقيقي. - ذاكرة KV لكل توكن: 2 × 48 × 8 × 128 × 2 بايت = 196,608 بايت، أي نحو 0.2 MB.
- ذاكرة KV للسياق كله: 4,096 توكن = 0.8 GB. 16,384 توكن = 3.2 GB. 32,768 توكن = 6.4 GB.
- المجموع: 9.0 + 0.8 + 1 = 10.8 GB بسياق 4K. 9.0 + 3.2 + 1 = 13.2 GB بسياق 16K. 9.0 + 6.4 + 1 = 16.4 GB بسياق 32K، وهذا لم يعد يتسع في بطاقة 16 GB.
ينتج عن ذلك أمران. الأول أن السياق الذي تحدده قد يكلّف من الذاكرة بقدر ما يكلّف النموذج نفسه. يحتاج Llama 3.1 8B (32 طبقة، و8 رؤوس KV، وحجم رأس 128) إلى 131,072 بايت من ذاكرة KV لكل توكن، فسياقه الكامل البالغ 128K يحتاج إلى 17.2 GB لذاكرة KV وحدها، أي نحو ثلاثة أضعاف ونصف حجم تنزيله البالغ 4.9 GB. والثاني أن حجم ذاكرة KV لكل توكن يختلف كثيراً من نموذج إلى آخر. لدى Qwen 2.5 7B أربعة رؤوس KV فقط و28 طبقة، فيحتاج إلى 57,344 بايت لكل توكن، أي أقل من نصف ما يحتاجه Llama 3.1 8B. راجع ملف الإعدادات قبل أن تفترض شيئاً.
ما يفعله Ollama بالسياق افتراضياً
يختار Ollama طول السياق الافتراضي حسب VRAM الذي يجده: 4K توكن تحت 24 GiB، و32K توكن من 24 إلى 48 GiB، و256K من 48 GiB فما فوق. يمكنك تغييره بمتغير البيئة OLLAMA_CONTEXT_LENGTH، ويعرض ollama ps السياق المخصص فعلاً في عمود CONTEXT. وهناك إعدادان آخران يغيّران الحساب:
OLLAMA_NUM_PARALLEL(القيمة الافتراضية 1): تقول وثائق Ollama إن الطلبات المتوازية تزيد حجم السياق بعدد الطلبات المتوازية. أربع خانات متوازية تعني أربعة أضعاف ذاكرة KV.OLLAMA_KV_CACHE_TYPE: q8_0يستخدم نحو نصف ذاكرة الإعداد الافتراضيf16، وq4_0نحو الربع. ويتطلب ذلك تفعيل flash attention.
ماذا تعني مستويات التكميم
تُنشر النماذج المفتوحة بدقة 16 بت (ملفات الإعدادات المذكورة أدناه تذكر bfloat16)، أي بايتان لكل معامل. التكميم يخزّن الأوزان بعدد أقل من البتات. في ملفات GGUF، وهي الصيغة التي يستخدمها Ollama وllama.cpp، تعني التسميات تقريباً ما يلي:
| التسمية | بت لكل وزن | حجم Llama 3.1 8B | الحيرة على Llama 3 8B (الأقل أفضل) |
|---|---|---|---|
| F16 | 16.0 | 14.96 GiB | 6.233 |
| Q8_0 | 8.50 | 7.95 GiB | 6.234 |
| Q6_K | 6.56 | 6.14 GiB | 6.253 |
| Q5_K_M | 5.70 | 5.33 GiB | 6.289 |
| Q4_K_M | 4.89 | 4.58 GiB | 6.407 |
| Q3_K_M | 4.00 | 3.74 GiB | 6.888 |
| Q2_K_S / Q2_K | 2.97 | 2.78 GiB | 9.752 (Q2_K) |
البتات لكل وزن والأحجام مأخوذة من ملف README الخاص بأداة quantize في llama.cpp (Llama 3.1 8B). والحيرة مأخوذة من ملف README الخاص بأداة perplexity في llama.cpp (Llama 3 8B، على Wikitext). أنواع “K” هي k-quants في llama.cpp، وهي تمزج بين مستويات دقة مختلفة داخل النموذج؛ و_S و_M و_L تعني مزيجاً صغيراً ومتوسطاً وكبيراً.
ما تقوله الأرقام: Q8_0 بلا خسارة عملياً (حيرة 6.234 مقابل 6.233). Q4_K_M يكلّف نحو 3% في الحيرة، ويذكر ملف README نفسه أن التوكن التالي الأرجح لديه يطابق النموذج بالدقة الكاملة في 91.9% من الحالات. Q3 أسوأ بشكل ملحوظ، وQ2 ينهار.
الحيرة ليست هي نفسها الفائدة العملية، ولذلك من المفيد أن دراسة نشرها Uygar Kurt في يناير 2026 أخضعت Llama 3.1 8B Instruct لاختبارات في الاستدلال والمعرفة واتباع التعليمات والصدق عند كل مستوى من مستويات llama.cpp. كان المتوسط غير الموزون 69.47 عند F16، و69.41 عند Q8_0، و69.36 عند Q5_K_M، و69.15 عند Q4_K_M. لهذا السبب يعتمد الجميع تقريباً، ومنهم Ollama، على Q4_K_M افتراضياً: الملف أقل من ثلث حجم FP16، مقابل خسارة نادراً ما تلاحظها. في Ollama، الوسم المختصر هو نسخة 4-bit هذه: qwen3:8b وqwen3:8b-q4_K_M كلاهما 5.2 GB، وphi4:14b وphi4:14b-q4_K_M كلاهما 9.1 GB.
قاعدتي: اختر أكبر نموذج يتسع بصيغة Q4_K_M قبل أن تختار نموذجاً أصغر بصيغة Q8_0. نموذج 14B بصيغة Q4 يتفوق عادةً على نموذج 7B بصيغة Q8، والملفان متقاربان في الحجم. انتقل إلى Q5 أو Q8 عندما تتبقى لديك ذاكرة وتكون المهمة حساسة للأخطاء الصغيرة، مثل كتابة الكود أو الاستخراج الدقيق.
تتضمن وسوم Ollama الأحدث أيضاً صيغاً مثل qat (نسخ Gemma المدرَّبة مع مراعاة التكميم) وnvfp4 وmxfp8. أما gpt-oss فتنشره OpenAI نفسها بصيغة MXFP4، بمعدل 4.25 بت لكل معامل لأوزان مزيج الخبراء.
أي النماذج تتسع: الأحجام وفئات VRAM
يعرض الجدول النماذج المفتوحة الحالية في مكتبة Ollama حتى سبتمبر 2026 مع أحجام تنزيلها. عمود “4-bit” هو حجم الوسم الافتراضي. في معظم النماذج هو الملف نفسه الذي يحمل الوسم q4_K_M؛ وحيث يكون الافتراضي نسخة مختلفة، يذكر الجدول الحجمين (الافتراضي في Mistral Nemo حجمه 7.1 GB، وq4_K_M حجمه 7.5 GB). “أصغر بطاقة” تعني أن النموذج مع نحو 1 GB من الحمل الإضافي وسياق من 4K إلى 8K يتسع بالكامل على GPU. تريد سياقاً طويلاً؟ اصعد فئة واحدة.
| النموذج | وسم Ollama | الحجم بـ 4-bit | الحجم بـ Q8_0 | أصغر بطاقة (4-bit / Q8_0) |
|---|---|---|---|---|
| Mistral 7B v0.3 | mistral:7b | 4.4 GB | 7.7 GB | 8 GB / 12 GB |
| Qwen 2.5 7B | qwen2.5:7b | 4.7 GB | 8.1 GB | 8 GB / 12 GB |
| DeepSeek-R1 المقطَّر 7B (Qwen 2.5) | deepseek-r1:7b | 4.7 GB | لم نتحقق منه | 8 GB |
| Llama 3.1 8B | llama3.1:8b | 4.9 GB | 8.5 GB | 8 GB / 12 GB |
| Qwen3 8B | qwen3:8b | 5.2 GB | 8.9 GB | 8 GB / 12 GB |
| DeepSeek-R1-0528 (Qwen3 8B) | deepseek-r1:8b | 5.2 GB | لم نتحقق منه | 8 GB |
| Qwen3.5 9B | qwen3.5:9b | 6.6 GB | 11 GB | 8 GB بسياق قصير فقط / 16 GB |
| Mistral Nemo 12B | mistral-nemo:12b | 7.1 GB (q4_K_M: 7.5 GB) | 13 GB | 12 GB / 16 GB |
| Gemma 4 12B | gemma4:12b | 7.6 GB | 13 GB | 12 GB / 16 GB |
| Gemma 3 12B | gemma3:12b | 8.1 GB | 13 GB | 12 GB / 16 GB |
| Qwen 2.5 14B | qwen2.5:14b | 9.0 GB | 16 GB | 12 GB / 24 GB |
| DeepSeek-R1 المقطَّر 14B (Qwen 2.5) | deepseek-r1:14b | 9.0 GB | لم نتحقق منه | 12 GB |
| Phi-4 14B | phi4:14b | 9.1 GB | 16 GB | 12 GB / 24 GB |
| Qwen3 14B | qwen3:14b | 9.3 GB | 16 GB | 12 GB / 24 GB |
| gpt-oss 20B (MoE) | gpt-oss:20b | 14 GB (MXFP4) | لا ينطبق | 16 GB |
| Mistral Small 3.2 24B | mistral-small3.2:24b | 15 GB | 26 GB | 24 GB / 32 GB |
| Gemma 3 27B | gemma3:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.5 27B | qwen3.5:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.6 27B | qwen3.6:27b | 18 GB (q4_K_M: 17 GB) | 30 GB | 24 GB / 48 GB |
| Gemma 4 26B (MoE، 3.8B نشطة) | gemma4:26b | 19 GB (q4_K_M: 18 GB) | 28 GB | 24 GB / 32 GB |
| Qwen3 30B-A3B (MoE) | qwen3:30b | 19 GB | لم نتحقق منه | 24 GB |
| Gemma 4 31B | gemma4:31b | 20 GB | 34 GB | 24 GB / 48 GB |
| Qwen3 32B | qwen3:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| Qwen 2.5 32B | qwen2.5:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| DeepSeek-R1 المقطَّر 32B (Qwen 2.5) | deepseek-r1:32b | 20 GB | لم نتحقق منه | 24 GB |
| Qwen3.6 35B-A3B (MoE) | qwen3.6:35b | 23 GB (q4_K_M: 24 GB) | 39 GB | 32 GB / 48 GB |
| Qwen3.5 35B-A3B (MoE) | qwen3.5:35b | 24 GB | 39 GB | 32 GB / 48 GB |
| Llama 3.3 70B | llama3.3:70b | 43 GB | 75 GB | 48 GB بالكاد / 80 GB بالكاد |
| Qwen 2.5 72B | qwen2.5:72b | 47 GB | لم نتحقق منه | 80 GB |
| gpt-oss 120B (MoE) | gpt-oss:120b | 65 GB (MXFP4) | لا ينطبق | 80 GB |
اعتمدت حجم الوسم الافتراضي لتحديد الفئة، لأنه ما ينزّله ollama pull عند استخدام الاسم المختصر.
في فئتي 24 GB و32 GB نقطة يجب الانتباه إليها. يقفز السياق الافتراضي في Ollama من 4K إلى 32K عند 24 GiB، فقد يحصل نموذج بحجم 20 GB على RTX 4090 على ذاكرة KV لسياق 32K لا تتسع بجانبه. إذا أظهر ollama ps حصة للمعالج المركزي، فاضبط سياقاً أصغر. ولا تحكم على النموذج من الرقم في اسمه: نموذج Gemma 4 المخصص للأجهزة الطرفية gemma4:e4b (4.5B معامل فعلي) حجم تنزيله 9.6 GB، أكبر من gemma4:12b البالغ 7.6 GB. تحقق من الحجم.
نماذج مزيج الخبراء تغيّر الصورة قليلاً
gpt-oss وGemma 4 26B ونماذج Qwen من نوع “A3B” هي نماذج مزيج خبراء (MoE). مع كل توكن، لا يعمل إلا عدد قليل من الخبراء: لدى Gemma 4 26B 25.2B معامل، لكن 3.8B منها فقط نشطة. قاعدة الذاكرة لا تتغير، لأن كل الأوزان يجب أن تُحمَّل في مكان ما. ما يتغير هو السرعة عندما لا تتسع كلها. لأن كل توكن لا يمر إلا بجزء من الأوزان، يتباطأ نموذج MoE الذي يفيض إلى ذاكرة النظام أقل بكثير من نموذج كثيف بالحجم نفسه. تبيّن القياسات في القسم التالي حجم هذا الفرق.
ماذا يحدث عندما لا يتسع النموذج
لا يرفض Ollama تحميل نموذج أكبر من اللازم. يضع على GPU أكبر عدد ممكن من الطبقات، ويشغّل الباقي على المعالج المركزي من ذاكرة النظام. يخبرك ollama ps بالحالة التي أنت فيها: 100% GPU تعني أن كل شيء يتسع، و100% CPU تعني أن لا شيء يتسع، ومزيج مثل 48%/52% CPU/GPU يعني تقسيماً.
التقسيم مكلف، لأن توليد كل توكن يتطلب قراءة كل وزن نشط، وذاكرة النظام أبطأ بكثير من VRAM. مجموعة من تشغيلات llama.cpp على بطاقة RTX 4080 بذاكرة 16 GB، نشرها Rost على DEV Community في أبريل 2026، تُظهر ذلك بوضوح:
| النموذج (التكميم، حجم الملف) | السياق | حمل GPU / CPU | توكن في الثانية |
|---|---|---|---|
| Qwen3.5 27B كثيف (IQ3_XXS، 11.5 GB) | 32K | 98% / 100% | 45.1 |
| Qwen3.5 27B كثيف | 64K | 45% / 410% | 22.7 |
| Qwen3.5 27B كثيف | 128K | 16% / 625% | 9.6 |
| Qwen3.5 35B-A3B MoE (IQ3_S، 13.6 GB) | 64K | 88% / 115% | 136.8 |
| Qwen3.5 122B-A10B MoE (IQ3_XXS، 44.7 GB) | 32K | 30% / 480% | 21.8 |
رقم CPU مرتفع مع رقم GPU منخفض يعني أن معظم العمل انتقل إلى المعالج المركزي؛ والكاتب يقرأ الأرقام بالطريقة نفسها.
فقد النموذج الكثيف نفسه نصف سرعته عند الانتقال من سياق 32K إلى 64K، فقط لأن ذاكرة KV الأكبر أخرجت طبقات من GPU، وفقد نحو 80% منها عند 128K. أما نموذج MoE بحجم 122B، وهو ملف بحجم 44.7 GB على بطاقة 16 GB، فبقي يعمل بنحو 22 توكن في الثانية لأن 10B معامل فقط نشطة لكل توكن. في النماذج الكثيفة، اعتبر “جزئياً على المعالج المركزي” مرادفاً لـ “أبطأ بعدة مرات”. أما في نماذج MoE فقد يكون ذلك مقايضة مقبولة.
إذا وقعت في التقسيم، فهذه الحلول مرتبة حسب تكلفتها: خفّض السياق، أو كمّم ذاكرة KV إلى q8_0، أو اختر تكميماً أصغر للنموذج نفسه (Q4_K_M بدلاً من Q5)، أو اختر نموذجاً أصغر، أو انتقل إلى بطاقة بذاكرة أكبر.
بطاقات 32 GB وبطاقات مراكز البيانات
لدى RTX 5090 ذاكرة 32 GB. يتيح لك ذلك تشغيل نموذج 32B بتكميم 4-bit مع سياق طويل، أو نماذج MoE من نوع 35B-A3B بحجم 23 إلى 24 GB مع مساحة لذاكرة KV. لكنه لا يوصلك إلى 70B: llama3.3:70b حجمه 43 GB حتى بتكميم 4-bit.
لنماذج 70B تحتاج إلى 48 GB أو أكثر. لدى L40S ذاكرة 48 GB، تتسع للملف البالغ 43 GB مع مساحة صغيرة للسياق. ولدى H100 SXM ذاكرة 80 GB (ولدى H100 NVL 94 GB)، تتسع لـ Llama 3.3 70B بتكميم 4-bit مع سياق طويل، أو لـ gpt-oss 120B (65 GB، وتقول صفحته في Ollama إنه يتسع في GPU واحد بذاكرة 80 GB)، أو لـ Llama 3.3 70B بصيغة Q8_0 (75 GB) مع سياق قصير. أما Qwen3.5 122B بحجم 81 GB فيتجاوز بالفعل بطاقة واحدة بذاكرة 80 GB.
الاستئجار بدلاً من الشراء: كيف تفحص إعلاناً على GPUFlow
إذا استأجرت GPU على GPUFlow، فإن المزوّد يقدّم النماذج من جهازه (عبر Ollama، الذي يثبّته برنامج تثبيت GPUFlow افتراضياً) ويختار النماذج المثبتة. لا تنزّل النماذج بنفسك: تحصل على مفتاح API متوافق مع OpenAI لتلك الوحدة، لا على سطر أوامر. يستخدم برنامج تثبيت GPUFlow qwen2.5:7b افتراضياً، والوسوم المذكورة في برنامج التثبيت والوثائق هي qwen2.5:0.5b وdeepseek-r1:1.5b وqwen2.5:7b وdeepseek-r1:7b وllama3.1:8b وqwen2.5:14b. ويستطيع المزوّدون تثبيت نماذج أخرى.
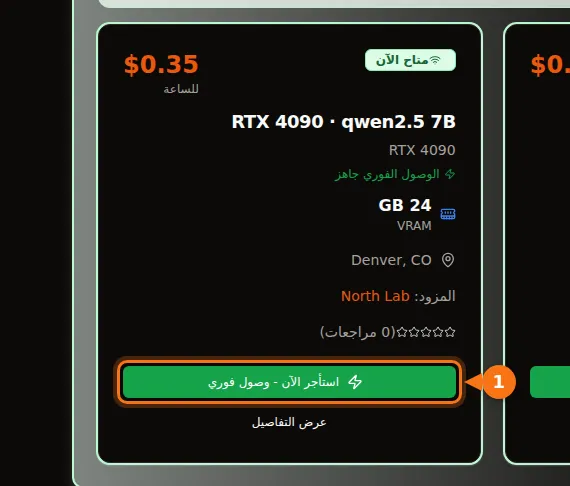
في السوق، تعرض كل بطاقة وحدة GPU ومقدار VRAM والسعر بالساعة، ويذكر وصف المزوّد النماذج التي يقدّمها. تعطي وثائق GPUFlow صيغة أكثر حذراً قليلاً للقاعدة نفسها: نموذج 7B يعمل جيداً على 8 GB أو أكثر، ونموذج 14B على 16 GB أو أكثر. بعد أن تحصل على مفتاح، يعيد GET /v1/models اسم نموذج واحد؛ وإذا ذكر الوصف نماذج أخرى، يمكنك استخدام أسمائها في الحقل model أيضاً.
أمران يجب أن تعرفهما. لا يفرض GPUFlow حداً خاصاً به للسياق، فتسري إعدادات Ollama الافتراضية على جهاز المزوّد ما لم يغيّرها. والنموذج الذي لم يثبّته المزوّد غير متاح لك، فاختر الإعلان حسب النموذج الذي تحتاج إليه أولاً، ثم حسب GPU. ربط المفتاح بـ Open WebUI أو Continue أو LangChain يتم بالطريقة نفسها كما مع أي API على نمط OpenAI.
مقالات ذات صلة
- كيف تستخدم مفتاح API متوافقاً مع OpenAI في Open WebUI وContinue وLangChain وغيرها
- GPU بالساعة أم API بالتوكن؟ التكلفة الحقيقية لتشغيل نموذج 7B–8B
- Ollama أم vLLM أم TGI: اختبار أداء الاستدلال على RTX 4090
- مقارنة أسعار استئجار GPU لعام 2026
المصادر
راجعناها كلها في سبتمبر 2026.
- أحجام التنزيل في مكتبة Ollama: mistral، qwen2.5، qwen3، qwen3.5، qwen3.6، llama3.1، llama3.3، deepseek-r1، صفحة نموذج DeepSeek-R1 (النماذج الأساسية للنسخ المقطَّرة)، gemma3، gemma4، صفحة نموذج Gemma 4 (MoE والمعاملات النشطة)، mistral-nemo، mistral-small3.2، phi4، gpt-oss، صفحة نموذج gpt-oss (MXFP4، الذاكرة)، فهرس مكتبة Ollama
- بنية النماذج: بطاقة نموذج Qwen2.5-14B-Instruct، ملف config.json لـ Qwen2.5-14B-Instruct، ملف config.json لـ Qwen2.5-7B-Instruct، ملف config.json لـ Llama-3.1-8B-Instruct (نسخة unsloth)
- إعدادات السياق والذاكرة في Ollama: وثائق Ollama، طول السياق، الأسئلة الشائعة في Ollama
- أحجام التكميم والبتات لكل وزن: ملف README لأداة quantize في llama.cpp
- الحيرة حسب التكميم: ملف README لأداة perplexity في llama.cpp
- دراسة قياس أداء التكميم: Uygar Kurt، أي تكميم يجب أن أستخدم؟ (arXiv 2601.14277)
- قياسات التفريغ إلى المعالج المركزي: Rost، قياسات أداء نماذج اللغة على 16 GB من VRAM مع llama.cpp (DEV Community، أبريل 2026)
- أحجام ذاكرة GPU: مقارنة سلسلة NVIDIA RTX 50، سلسلة RTX 40، سلسلة RTX 30، L40S، H100
- GPUFlow: استئجار GPU خطوة بخطوة، البدء السريع مع API، البدء للمزوّدين