시간당 $0.40일 때 90초짜리 테스트는 최소 60초의 초 단위 과금이면 1¢, 분 단위 과금이면 1.3¢, 1시간 단위 과금이면 40¢입니다. 짧은 작업에서는 이 40배 차이가 전부입니다. 작업이 몇 분을 넘기면 초 단위와 분 단위 과금의 차이는 1센트도 안 되고, 청구액은 유휴 시간, 준비 시간, 스토리지가 결정합니다.
아래에서 각 플랫폼이 공개한 규칙, 계산 과정을 보여 주는 예시, 축척에 맞춘 차트, 그리고 GPUFlow의 확보 후 환불 방식이 실제 청구액으로 바뀌는 과정을 다룹니다. 규칙과 가격은 2026년 9월 기준이며, 출처는 글 끝에 있습니다.
GPU 시간을 세는 세 가지 방법
모든 GPU 대여에는 시간당 가격이 있습니다. 차이는 사용한 시간을 그 가격에 곱하기 전에 청구 시간으로 어떻게 바꾸느냐입니다.
- 최소 시간이 있는 초 단위. 초를 셉니다. 합계가 최소 시간(보통 60초)보다 짧으면 최소 시간만큼 청구합니다. 비용 = max(60, 초) × 시간당 요금 / 3,600.
- 분 단위. 분을 셉니다. 1분이 안 되는 자투리를 어떻게 처리하는지는 플랫폼마다 다릅니다. 올림하는 곳도 있고, Azure는 버립니다. 아래 예시에서는 올림으로 계산했습니다. 이용자에게 더 불리한 쪽입니다. 비용 = 분 × 시간당 요금 / 60.
- 1시간 단위. 시작한 시간은 모두 한 시간으로 칩니다. 61분 작업은 2시간입니다. 비용 = ceil(초 / 3,600) × 시간당 요금.
최소 청구 시간은 생각보다 중요합니다. 최소 60초의 초 단위 과금과 분 단위 과금은 1분 미만 작업에서 똑같습니다. 과금 단위는 작업 끝의 자투리에만 영향을 주므로, 세션당 한 단위 이상 더 내게 만들 수는 없습니다. 시간당 $0.40이라면 1시간 단위 과금에서는 세션당 40¢ 조금 못 되게, 같은 요금의 분 단위 과금에서는 세션당 0.7¢ 미만입니다(59초 × 40 / 3,600 = 0.66¢).
플랫폼별 과금 방식
온디맨드 인스턴스에 대해 공개된 규칙이며, 2026년 9월에 각 업체의 공식 문서로 확인했습니다.
| 플랫폼 | 과금 단위 | 최소 청구 시간 | 문서 내용 |
|---|---|---|---|
| AWS EC2 온디맨드 | 초 단위 | 60초 | Linux, Windows, RHEL, Ubuntu Pro에 적용. SUSE Linux Enterprise Server는 1시간 단위로 청구. |
| Google Cloud Compute Engine | 초 단위 | 1분 | ”모든 vCPU, GPU, 메모리 GB는 최소 1분이 청구됩니다.” |
| Azure Virtual Machines | 분 단위 | 명시되지 않음 | ”온전한 분 수”만큼 청구. 6분 45초 실행한 VM은 6분으로 청구. |
| Lambda(온디맨드 클라우드) | 분 단위 | 명시되지 않음 | 인스턴스가 상태 검사를 통과한 시점부터 종료할 때까지 “1분 단위”로 청구. |
| RunPod Pods | 초 단위 | 명시되지 않음 | 컴퓨팅과 스토리지 모두 초 단위로 청구. |
| Vast.ai | 초 단위 | 명시되지 않음 | 활성 대여는 매초 청구. 스토리지는 인스턴스가 오프라인이 아닌 한 존재하는 동안 매초 청구. |
| GPUFlow | 초 단위 | 60초 | 온전한 초 단위, 센트로 올림, 확보된 금액이 상한. |
표를 읽을 때 두 가지를 기억하세요. Azure 규칙은 사실상 내림입니다. FAQ에 “추가된 초는 청구되지 않는다”고 나와 있습니다. Lambda 문서는 1분 단위라고만 하고 자투리를 어느 쪽으로 처리하는지는 밝히지 않으므로, 어느 쪽으로도 가정하지 않았습니다. 그리고 “명시되지 않음”은 말 그대로입니다. 제가 읽은 문서에 최소 청구 시간이 나오지 않는다는 뜻이지, 최소 시간이 0이라고 문서화되어 있다는 뜻이 아닙니다.
위 인스턴스 유형에서 GPU 컴퓨팅을 1시간 단위로 올림하는 플랫폼은 없습니다. 하지만 AWS의 SUSE처럼 1시간 단위 올림은 세부 조항에 여전히 남아 있으니, 새로운 곳에서 짧은 작업을 많이 돌리기 전에 과금 페이지를 확인하세요.
시간당 $0.40으로 계산한 다섯 가지 작업
요금 하나, 시간당 $0.40을 다섯 가지 작업 길이에 적용합니다. 3,600초에 40¢, 즉 1초에 1/90센트입니다.
90초 테스트. 초 단위: 90 × 40 / 3,600 = 1.0¢. 분 단위: 2분 × 40 / 60 = 1.33¢. 1시간 단위: 40¢. 1시간 단위 청구액이 초 단위의 40배입니다.
7분 30초. 초 단위: 450 × 40 / 3,600 = 5.0¢. 분 단위: 8분 × 40 / 60 = 5.33¢. 1시간 단위: 40¢로 8배입니다.
38분 20초. 초 단위: 2,300 × 40 / 3,600 = 25.56¢. 분 단위: 39분 × 40 / 60 = 26.0¢. 1시간 단위: 40¢로 약 1.57배입니다.
61분. 초 단위: 3,660 × 40 / 3,600 = 40.67¢. 분 단위: 61 × 40 / 60 = 40.67¢(작업이 정확히 분 단위로 끝나므로 둘이 같습니다). 1시간 단위: 2시간, 80¢. 1분 더 돌았을 뿐인데 1시간 단위 청구액은 거의 두 배가 됩니다.
| 작업 길이 | 초 단위(최소 60초) | 분 단위(올림) | 1시간 단위 | GPUFlow 청구액 |
|---|---|---|---|---|
| 1분 30초 | 1.00¢ | 1.33¢ | 40¢ | 1¢ |
| 7분 30초 | 5.00¢ | 5.33¢ | 40¢ | 5¢ |
| 38분 20초 | 25.56¢ | 26.00¢ | 40¢ | 26¢ |
| 61분 | 40.67¢ | 40.67¢ | 80¢ | 41¢ |
| 2분 30초 작업 20건 | 33.33¢ | 40.00¢ | $8.00 | 40¢(대여 20건) |
GPUFlow 열은 초 단위 결과를 대여마다 온전한 센트로 올림한 값으로, 실제 과금 코드가 하는 계산입니다. 마지막 행은 두 섹션 뒤에서 설명합니다.
작업 길이별 비용, 축척대로
첫 번째 차트는 0분부터 150분까지입니다. 분 단위 계단은 폭 1분, 높이 0.67¢라서 이 축척에서는 초 단위 선과 겹쳐 보입니다. 중요한 계단은 1시간 단위 선입니다. 0분, 60분, 120분에서 40¢씩 뜁니다.
주황색 계단과 파란색 선 사이의 간격이 작업 하나당 1시간 단위 올림이 치르게 하는 비용입니다. 각 계단 직후에 가장 크고, 정확히 시간 단위로 끝나면 0입니다.
처음 10분을 확대하면 분 단위 과금의 계단이 보이고, 60초 최소 청구 시간은 초 단위 선의 평평한 시작 부분으로 나타납니다. 1시간 단위 과금은 40¢에서 평평한 선이 되는데, 이 차트 맨 위의 다섯 배 높이입니다.
짧은 작업으로 채운 하루
짧은 작업은 혼자 오는 경우가 드뭅니다. 하루 업무 시간에 2분 30초짜리 작업을 20건 돌리고, 작업마다 새 인스턴스를 띄운다고 해 봅시다.
- 초 단위: 20 × 150초 = 3,000초, 3,000 × 40 / 3,600 = 33.33¢.
- 분 단위, 올림: 작업마다 3분이므로 합계 60분, 40¢.
- 1시간 단위: 작업마다 시작한 한 시간: 20 × 40¢ = $8.00.
같은 50분의 GPU 작업에 1시간 단위 과금은 24배를 받습니다. 뻔한 해결책은 머신 하나를 하루 종일 켜 두는 것입니다. $0.40로 8시간이면 $3.20으로 $8.00보다는 낫지만, 여전히 초 단위 청구액의 9.6배입니다. 이제는 작업 사이의 빈 시간에 돈을 내기 때문입니다.
그런데 이 예시는 새 인스턴스를 띄우는 방식에 유리하게 짜여 있습니다. 머신이 켜지는 순간 작업이 시작된다고 가정했기 때문입니다. 실제로는 그렇지 않습니다. 예를 들어 인스턴스를 띄울 때마다 부팅, 이미지 받기, 모델 로딩에 3분이 걸린 뒤에야 작업이 시작된다고 해 봅시다(실제 수치는 환경마다 다릅니다). 그러면 초 단위 과금으로 20 × 330초 = 6,600초, 73.33¢를 내게 되어, 실제 작업분 33.33¢의 두 배가 넘습니다. 과금 단위는 같습니다. 낭비가 준비 과정으로 옮겨 갔을 뿐입니다.
GPUFlow에서는 같은 하루가 조금 다르게 계산됩니다. 대여는 시간 단위로 예약하고 초 단위로 청구하기 때문입니다. 150초짜리 대여를 따로 20건 시작하면 건당 ceil(150 × 40 / 3,600) = ceil(1.67) = 2¢, 합계 40¢입니다. 대여마다 센트로 올림하면서 여기서는 작업당 0.33¢가 더해지고, 초 단위 합계보다 6.67¢ 많은 이유가 이것입니다. 작업이 몰려 있다면 사용자당 시간당 신규 대여 10건 제한이 있다는 점을 기억하세요. 대여 하나를 하루 종일 열어 두면 실제 경과 시간 전체, 8시간 = $3.20을 냅니다. GPUFlow는 토큰이 아니라 시간으로 청구하기 때문입니다.
과금 단위보다 중요한 것
작업이 10분 정도를 넘기면 초 단위냐 분 단위냐는 반올림 오차 수준입니다. 하지만 다음 세 가지는 그렇지 않습니다. 자세한 내용은 GPU 대여의 실제 비용에서 다룹니다.
유휴 시간
초 단위 과금을 하는 모든 플랫폼은 GPU가 일하든 안 하든 실행 중인 인스턴스에 요금을 청구합니다. Lambda 문서는 인스턴스가 “실제로 사용되고 있는지와 관계없이” 청구된다고 직접 밝힙니다. 위의 짧은 작업 예시가 규모를 보여 줍니다. 작업은 50분인데, 머신을 8시간 켜 두면 $3.20입니다. 끄는 것을 잊은 머신은 어떤 과금 단위로도 해결되지 않습니다.
준비 시간
부팅, 이미지 받기, 모델 다운로드는 모두 요금이 나가는 동안 일어납니다. Lambda는 인스턴스가 상태 검사를 통과하는 순간부터, 즉 내 코드가 아무것도 하기 전부터 청구합니다. 초 단위 과금이 이 비용을 없애 주지는 않습니다. 인스턴스를 띄울 때마다 내게 됩니다.
정지 중 스토리지
머신을 정지하면 보통 GPU 요금은 멈춥니다. 디스크 요금은 계속 나갑니다. RunPod는 정지된 포드의 볼륨 디스크에 월 GB당 $0.20을 청구하는데, 실행 중 요금의 두 배입니다. 문서에도 “정지된 포드에도 스토리지 요금은 계속 발생한다”고 경고합니다. Vast.ai도 “인스턴스를 정지해도 스토리지 비용은 피할 수 없다”고 분명히 말합니다. 정지된 RunPod 포드에 100 GB 볼륨을 남겨 두면 100 × $0.20 = 월 $20로, $0.40짜리 GPU 50시간에 해당합니다.
워크로드가 머신에서 내 코드를 돌리는 것이 아니라 모델을 호출하는 것이라면 토큰당 가격과도 비교해 보세요. 시간당 GPU인가, 토큰당 API인가에서 각각 언제 더 저렴한지 계산해 두었습니다.
GPUFlow 과금 방식: 먼저 확보하고, 남은 금액은 환불
GPUFlow가 빌려주는 것은 추론입니다. 머신이 아니라, 누군가의 GPU에서 돌아가는 모델용 OpenAI 호환 API 키를 받습니다. 셸, 디스크, 이미지가 없으니 앞 섹션의 스토리지와 준비 시간은 해당되지 않습니다. 유휴 시간은 해당됩니다. 대여는 바쁘든 아니든 시작부터 끝까지 청구됩니다.
단계는 다음과 같습니다.
- 리스팅과 시간을 정수로 고릅니다(기본 1~168시간). 제공자의 시간당 가격은 온전한 센트 단위로 변환됩니다.
- 시작할 때 예약한 금액 전체가 크레딧에서 확보됩니다. 센트 단위 요금 × 시간입니다. 전액이 먼저 잡힙니다.
- 대여가 끝나면 청구액을 한 번 계산합니다. 사용한 온전한 초(최소 60) × 센트 단위 요금 ÷ 3,600을 다음 센트로 올림하며, 확보 금액을 넘지 않습니다.
- 확보 금액에서 남은 부분은 같은 단계에서 사용 가능한 크레딧으로 돌아옵니다.
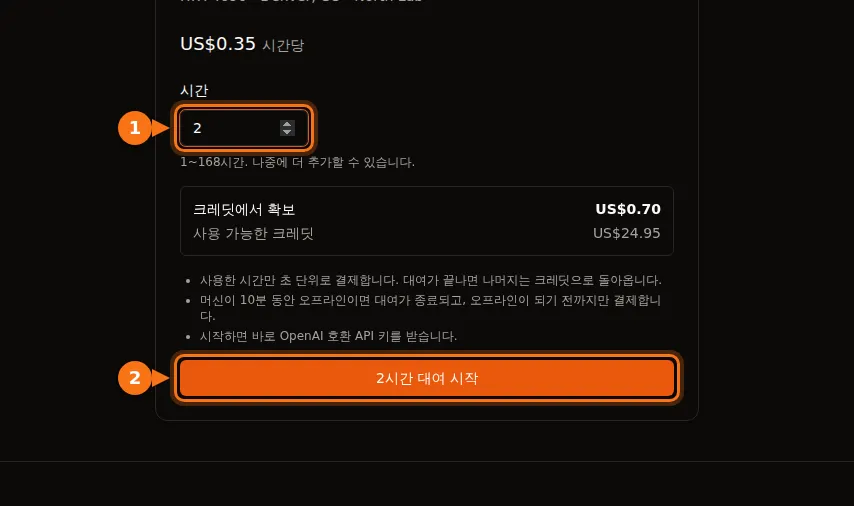
대여 양식은 시작하기 전에 확보 금액을 보여 줍니다. $0.35로 2시간이면 $0.70이 확보됩니다.
계산 예시
$0.40로 3시간을 예약합니다. 확보 금액은 40¢ × 3 = 120¢($1.20)입니다. 38분 20초, 즉 2,300초 뒤에 지금 종료를 클릭합니다.
- 청구액: ceil(2,300 × 40 / 3,600) = ceil(25.56) = 26¢.
- 크레딧으로 돌아오는 금액: 120 − 26 = 94¢.
- 플랫폼 수수료는 청구액의 12%이며, 대여마다 가장 가까운 센트로 반올림합니다. round(26 × 0.12) = round(3.12) = 3¢. 제공자는 26 − 3 = 23¢를 받습니다. 이 청구액의 정확히 88%가 아니라 88.5%입니다. 청구액이 클수록 반올림의 영향은 줄어듭니다.
내가 끝내지 않아도 대여가 끝나는 경우
예약한 시간이 다 되면 매분 실행되는 백그라운드 작업이 대여를 정산합니다. 청구액은 예약 종료 시각까지로 계산되므로, 작업이 실행되기 전의 지연 시간은 내지 않습니다. API 키는 종료 시각에 작동을 멈춥니다. 시간이 더 필요하면 시간 추가로 크레딧을 더 확보하고 같은 키를 계속 쓸 수 있습니다.
제공자의 머신이 응답을 멈춰도 대여가 끝납니다. 제공자 머신의 에이전트는 15초마다 하트비트를 보냅니다. 10분 동안 하트비트가 없으면 대여가 종료되고, 마지막 하트비트 시점까지만 청구됩니다. 시간당 $0.40로 3시간을 예약했는데 25분 만에 머신이 끊기면 ceil(1,500 × 40 / 3,600) = 17¢를 내고, 120¢ 확보 금액 중 나머지 103¢는 돌아옵니다.
시간 단위 예약과 61분 작업에는 함정이 있습니다. 1시간을 예약하고 끝나기 전에 시간 추가를 누르는 것을 잊으면, 키는 60분에 멈추고 끝나지 않은 작업에 40¢를 냅니다. 2시간을 예약하고(80¢ 확보) 61분에 끝내면 41¢를 내고 39¢를 돌려받습니다. 애매하면 길게 예약하고 일찍 끝내세요. 쓰지 않은 시간은 비용이 없습니다.
작업 형태에 맞는 과금 방식 고르기
- 10분 미만 작업이 많다면: 초 단위나 분 단위 과금을 쓰고, 최소 청구 시간을 확인하세요. 1시간 단위로 올림하는 방식은 여기에 맞지 않습니다.
- 30~90분짜리 작업이라면: 1시간 단위 올림을 피하세요(61분 작업이 2시간 요금을 냅니다). 초 단위와 분 단위의 차이는 작업당 1센트 미만입니다.
- 여러 시간 걸리는 긴 작업이라면: 과금 단위는 거의 영향이 없습니다. 대신 유휴 시간, 준비 시간, 스토리지를 보세요.
- 하루 동안 모델 하나를 간헐적으로 호출한다면: 호출이 몰릴 때마다 새 머신을 띄우면 매번 준비 시간을 내고, 머신 하나를 켜 두면 빈 시간을 냅니다. 모델을 준비된 상태로 유지하는 추론 대여는 준비 시간을 피하는 한 가지 방법이지만, 호출 사이에도 시간은 흐르므로 실제로 일하는 시간에 맞춰 예약하세요.
직접 해 보고 싶다면 GPUFlow 마켓플레이스에서 GPU별 시간당 가격을 볼 수 있고, 계정과 결제 쪽은 GPU 대여에 필요한 것에서 다룹니다.
출처
- AWS, Amazon EC2 온디맨드 가격(과금 세부 사항): aws.amazon.com/ec2/pricing/on-demand
- Google Cloud, VM 인스턴스 가격(과금 모델): cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure, Linux Virtual Machines 가격(FAQ): azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda, 과금 개요: docs.lambda.ai/public-cloud/billing
- RunPod, 포드 가격: docs.runpod.io/pods/pricing
- Vast.ai, 과금 참고 문서: docs.vast.ai/documentation/reference/billing
- GPUFlow 문서, 크레딧, 결제, 환불: docs.gpuflow.app/ko/renters/billing
모두 2026년 9월에 확인했습니다.