É razoavelmente seguro se você escolher a plataforma sabendo o que está fazendo, mas “seguro” significa coisas diferentes em plataformas diferentes. Em plataformas de contêiner como o Vast.ai, o locatário roda o próprio código na sua máquina e o tráfego dele sai pelo seu endereço IP; o isolamento o mantém longe dos seus arquivos, não da sua rede nem da sua conta de luz. Em um modelo só de API como o GPUFlow, o locatário só consegue enviar requisições de chat para os modelos que você instalou, e o risco se inverte: os prompts podem ser lidos na sua máquina, então os locatários não devem enviar nada secreto.
Este artigo trata das duas direções. As informações sobre outras plataformas foram conferidas na documentação de cada uma em setembro de 2026, e tudo o que diz respeito ao GPUFlow vem do código-fonte e da documentação dele. As fontes estão no final.
O que um locatário pode fazer em uma plataforma de contêiner
A maioria dos marketplaces de GPU aluga um contêiner. O locatário escolhe uma imagem, recebe um shell e roda o que quiser. Isso deixa você, o host, com cinco pontos para pensar.
- Código arbitrário. O código do locatário roda no seu kernel, dentro de um contêiner ou de uma VM. O isolamento é bom, mas não perfeito; fugas de contêiner são raras, e são exatamente o tipo de bug corrigido nas atualizações de kernel e de driver que você precisa instalar.
- Seu endereço IP. O tráfego de saída do contêiner sai pela sua conexão de internet. Se um locatário fizer scraping de um site, mandar spam ou varrer a internet, a denúncia de abuso vai para o seu provedor de internet, endereçada ao seu IP. Os termos do Vast.ai dizem que os usuários indenizam os provedores por reclamações decorrentes do conteúdo dos usuários, o que ajuda numa disputa com terceiros, mas não impede o seu provedor de internet de mandar um aviso para você.
- Portas abertas. O guia de hospedagem do Vast.ai diz que “os clientes precisam de portas abertas para se conectar diretamente à máquina na maioria dos trabalhos”, então você redireciona portas no seu roteador.
- Disco. Os locatários baixam imagens, modelos e datasets para os seus discos. O Vast.ai libera o espaço quando um cliente apaga um volume, mas enquanto o aluguel dura, o espaço é dele.
- Energia, calor e drivers. O Vast.ai avisa os hosts: “espere que a GPU seja usada perto da capacidade máxima durante o período do aluguel”. São horas com a placa na potência máxima, calor no cômodo e ventoinhas girando. As plataformas de contêiner também exigem uma instalação específica: o guia do Vast.ai lista instalar o Ubuntu, particionar os discos, instalar os drivers da NVIDIA e abrir portas no roteador.
Como Vast.ai, Salad e RunPod isolam os locatários
| Vast.ai | Salad | RunPod Community Cloud | |
|---|---|---|---|
| O locatário recebe | Um contêiner (ou uma VM) com SSH ou Jupyter | Um contêiner que ele mesmo implantou; SSH e um terminal web dentro dele | Um pod (contêiner) |
| Isolamento | Contêineres Docker sem privilégios | VM Linux sobre um hypervisor, com o contêiner dentro | ”Seu próprio contêiner, com separação rigorosa” |
| Portas de entrada | Necessárias na maioria dos trabalhos | Bloqueadas por padrão | Não informado |
| Novos hosts | Sim, no Ubuntu | Sim, no Windows 10/11 | Não aceita mais |
- O Vast.ai diz que “os clientes ficam isolados em contêineres Docker sem privilégios e só têm acesso aos próprios dados”, com namespaces e cgroups separados e isolamento de rede, sistema de arquivos e processos. Ele também avisa os locatários de que “a segurança dos provedores varia bastante” e indica o Secure Cloud, sua linha de data centers certificados, para trabalhos sensíveis.
- O Salad diz que “sua carga de trabalho roda dentro de um contêiner compatível com OCI em uma máquina virtual Linux, isolada do Windows e de todos os outros processos do host”, com conexões de entrada bloqueadas por padrão. Ele também protege os locatários dos hosts: se um host “tentar acessar o ambiente Linux, destruímos o ambiente automaticamente e colocamos a máquina na lista negra”. À parte disso, o Salad oferece trabalhos opcionais de compartilhamento de banda que “processam conteúdo de vídeo de plataformas de streaming premium” pela sua conexão; a página de suporte avisa que isso aumenta o seu consumo de dados e pode causar “uma restrição de conteúdo rara e temporária (normalmente de 1 a 2 dias) nessas plataformas de streaming”.
- O RunPod diz que “o Runpod não está mais aceitando novos hosts no Community Cloud”. Na capacidade que já existe, “cada Pod/worker opera no seu próprio contêiner”, e os termos “proíbem os hosts de inspecionar os dados do seu Pod/worker”.
As três isolam o locatário do seu sistema. Nenhuma delas consegue impedir que um tráfego com cara de legítimo saia pela sua conexão, e nenhuma afirma que consegue.
Como o GPUFlow é diferente
O GPUFlow aluga um modelo de IA atrás de uma API compatível com a OpenAI, não uma máquina. Isso muda o que o locatário consegue alcançar. Veja o que o código faz.
O agente. O instalador coloca um único binário Go em /usr/local/bin/gpuflow-agent e o roda como serviço do systemd. Não há Docker. A unit do serviço usa DynamicUser=yes (um usuário temporário sem privilégios), NoNewPrivileges=yes (ele não consegue ganhar permissões), ProtectSystem=strict (o sistema fica somente leitura para ele), ProtectHome=yes (as pastas pessoais ficam invisíveis) e PrivateTmp=yes. O motor de inferência é o Ollama por padrão, instalado pelo próprio instalador do Ollama como um serviço separado (o provedor pode, em vez disso, apontar o agente para o seu próprio servidor compatível com a OpenAI). O endurecimento vale para o agente, não para o Ollama.
Rede. O agente só faz conexões de saída: um WebSocket sobre TLS para wss://ws.gpuflow.app e HTTPS para gpuflow.app, para se registrar e enviar um heartbeat a cada 15 segundos. Ele não abre portas, você não redireciona nada no roteador e os locatários nunca ficam sabendo o seu endereço IP. Ele conversa com o Ollama em 127.0.0.1:11434, o endereço de loopback padrão do Ollama.
O que os locatários podem chamar. O locatário recebe uma chave de API para https://gpuflow.app/v1. O próprio GPUFlow responde ao GET /v1/models, e a única requisição que ele encaminha para a sua máquina é POST /v1/chat/completions. O agente tem uma segunda trava própria: ele só repassa quatro caminhos exatos (/v1/chat/completions, /v1/completions, /v1/embeddings e /v1/models) e recusa todo o resto, incluindo os endpoints nativos /api/* do Ollama, que serviriam para baixar, apagar ou criar modelos. O agente trata um único tipo de mensagem, uma requisição de inferência; qualquer outra coisa é ignorada.
Ou seja, o locatário não tem shell, nem SSH, nem arquivos, nem acesso de rede à sua máquina. Ele não consegue baixar um modelo de 70 GB para o seu disco nem usar a sua conexão para acessar a internet. O que ele consegue é manter a sua GPU ocupada pelas horas que reservou e usar no campo model qualquer modelo que você instalou.
O caminho dos dados, trecho por trecho
Esta é a parte que os locatários devem ler. Uma requisição de chat passa por quatro softwares, e o texto pode ser lido em mais de um deles.
- Do locatário para o gpuflow.app: HTTPS. O site fica atrás do Cloudflare.
- Da API do GPUFlow para o relay: uma conexão interna do lado do GPUFlow. A API verifica a chave, encaminha o corpo da requisição sem alterações e registra a contagem de tokens. Ela não guarda o texto das requisições nem das respostas, e a política de privacidade diz isso.
- Do relay para o agente do provedor: um WebSocket com TLS que o próprio agente abriu. O relay registra o tipo de cada mensagem, não o conteúdo.
- Do agente para o Ollama: HTTP simples no endereço de loopback, dentro do PC do provedor. O agente também não registra o corpo das requisições.
Não há criptografia de ponta a ponta até o modelo, e nem pode haver com um motor de inferência comum: o modelo precisa ler o prompt para responder.
O que o provedor consegue ver
Sem rodeios: o computador do provedor processa os seus prompts e respostas em texto puro. O Ollama roda ali, e o provedor tem acesso root à máquina (o instalador exige isso). Um provedor que quisesse poderia capturar o tráfego de loopback, trocar o motor ou apontar o agente para outro servidor.
O que impede isso é contratual. Os termos do GPUFlow dizem que os provedores “não podem registrar, ler, guardar ou compartilhar as requisições ou respostas dos locatários, nem alterar as respostas”. É uma regra com consequências para a conta, não um bloqueio técnico. A política de privacidade diz o mesmo aos locatários: as requisições e respostas passam pelo computador do provedor enquanto o aluguel dura.
Além dos prompts, o provedor vê o seu nome de usuário no GPUFlow e recebe um aviso quando um aluguel começa (id do aluguel, anúncio e horas). Os locatários não veem nada das estatísticas da máquina do provedor; temperatura da GPU, VRAM, consumo de energia e outras métricas vão só para o painel do dono.
A regra prática para locatários: não envie segredos, credenciais, dados pessoais de outras pessoas nem dados regulados (saúde, finanças, informações confidenciais de clientes) por nenhuma GPU comunitária. Isso vale para o GPUFlow e, do mesmo jeito, para um contêiner no PC de alguém, onde o host pode inspecionar a memória e o disco com o mesmo acesso root. Para trabalho sensível, rode o modelo em hardware que você controla ou use um fornecedor que assine o contrato que a sua área de compliance exige. Por que algumas empresas proíbem ferramentas públicas de IA trata do lado das políticas, e como proteger um dataset em um nó de GPU público trata do lado dos contêineres.
O que ainda tem risco no GPUFlow
Um modelo só de API reduz a superfície de ataque. Não a elimina, e prefiro listar o que sobra a fingir o contrário.
- O Ollama processa entrada não confiável. Toda requisição de locatário acaba virando um JSON entregue ao Ollama. Um bug no Ollama é o caminho de entrada mais provável, então mantenha-o atualizado. A lista de permissões do agente mantém os locatários longe dos endpoints de gerenciamento de modelos do Ollama, mas não corrige um bug no caminho do chat.
- O instalador roda como root. Você passa um script do gpuflow.app para
sudo bash, e ele também roda o script de instalação do Ollama. Leia os dois antes; isso é boa prática para qualquer software de hospedagem. - Sem atualização automática. O agente não se atualiza sozinho. Para pegar uma versão nova, rode o instalador de novo; ele confere o binário contra um arquivo SHA256SUMS quando há um publicado.
- Carga. Não há limite de requisições. Um locatário pode manter a sua GPU em carga máxima em todas as horas que reservou e pode usar qualquer modelo que você instalou, inclusive o maior.
- Calor e energia. Igual a qualquer outro lugar: hora alugada é hora com carga.
Checklist para provedores
- Use uma máquina que você possa emprestar. O ideal é uma máquina dedicada. No mínimo, não deixe arquivos de trabalho nem gerenciadores de senha no computador que você aluga, qualquer que seja a plataforma. No GPUFlow, o agente já roda como um usuário de sistema temporário e com as pastas pessoais ocultas, mas o Ollama é um serviço separado.
- Limite a potência.
sudo nvidia-smi -pl 280define o limite de potência da placa em watts (exige root, e o valor precisa ficar entre os limites mínimo e máximo da placa). A Puget Systems relata que RTX 3090 limitadas a 270-280 W mantêm cerca de 95% do desempenho e mostra como reaplicar o limite a cada boot com uma unit do systemd. - Faça a conta da energia antes. Veja o consumo em Minhas máquinas enquanto a GPU está ocupada e multiplique os quilowatts pelo seu preço por kWh. Quanto a sua GPU gamer pode render faz essa conta para placas comuns e cinco países.
- Acompanhe a temperatura. As estatísticas ao vivo mostram as temperaturas da GPU, do hotspot e da memória e a velocidade das ventoinhas. Garanta que o gabinete tenha ventilação.
- Mantenha o sistema atualizado. Instale as atualizações do Linux, do driver da GPU e do Ollama. O instalador do GPUFlow não gerencia o driver da sua GPU; o systemd reinicia o agente depois de um reboot.
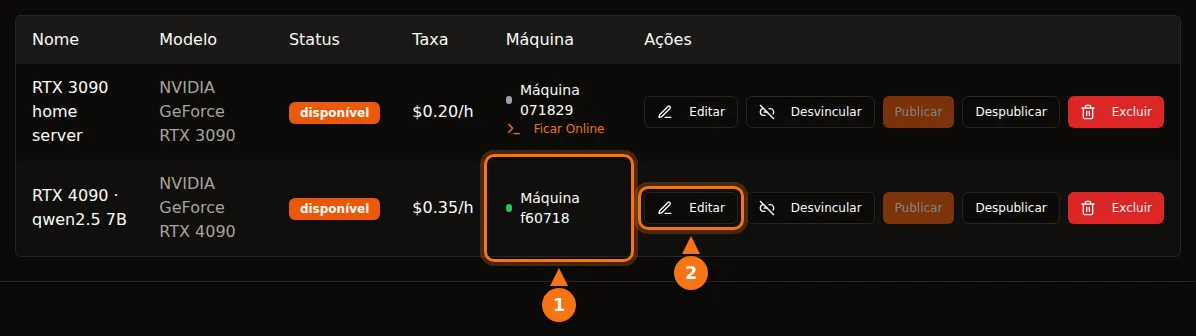
- Saiba como pausar. Despublique o anúncio em Minhas GPUs ou rode
sudo systemctl stop gpuflow-agent(starto traz de volta). Enquanto há um aluguel ativo, o painel não deixa alterar o anúncio nem a máquina, e você não consegue encerrar o aluguel do locatário por ali. Parar o agente no meio de um aluguel faz o aluguel terminar depois de 10 minutos, e você só recebe até o último heartbeat. - Saiba como desinstalar. Os passos estão na documentação de solução de problemas. O Ollama continua instalado até você removê-lo.
Em plataformas de contêiner, acrescente dois itens: decida se você quer mesmo portas abertas no seu roteador e pergunte ao seu provedor de internet o que ele faz com denúncias de abuso, porque o tráfego dos locatários vai sair com o seu endereço IP.
Checklist para locatários
- Trate toda GPU comunitária como o computador de um desconhecido. Nada de chaves de API, senhas, cadastros de clientes, dados médicos ou financeiros nos prompts.
- Tire o que não for necessário. Troque nomes e números de conta por marcadores antes de enviar.
- Proteja a sua chave. No GPUFlow, a chave para de funcionar quando o aluguel termina. Se ela vazar, Nova chave revoga a antiga na hora, e Encerrar agora para a cobrança e devolve o tempo não usado.
- Considere que as respostas podem estar erradas ou adulteradas. Os termos proíbem os provedores de alterar as respostas, mas confira qualquer coisa importante.
- Use a ferramenta certa para trabalho sensível. Hospede o modelo você mesmo ou use um fornecedor que ofereça o contrato de que você precisa. Como usar a chave nos seus apps serve para todo o resto.
Fontes
Tudo verificado em setembro de 2026.
- GPUFlow: o que os locatários conseguem acessar, primeiros passos para provedores, preço e energia, solução de problemas e desinstalação, guia rápido da API
- Vast.ai: visão geral da hospedagem, FAQ de segurança, máquinas virtuais Linux, termos de serviço, como rodar modelos de IA privados
- Salad: segurança, cargas de trabalho em contêiner e o seu PC, compartilhamento de banda, SSH e terminal, download e requisitos de sistema
- RunPod: como escolher um pod, segurança de dados e conformidade legal
- Ollama: FAQ (endereço de bind padrão)
- NVIDIA: manual do nvidia-smi
- Puget Systems: limitação de potência de RTX 3090 com systemd e nvidia-smi