El precio por hora de una oferta de GPU cubre el tiempo de GPU y nada más. En la mayoría de plataformas también pagas el espacio en disco (a menudo más con la máquina parada que en marcha), la transferencia de datos en algunos mercados, el tiempo de preparación y el tiempo ocioso, que el contador cuenta igual que el trabajo real, y la comisión de cambio de tu banco. En el ejemplo resuelto de más abajo, un mes previsto en 13,60 $ de tiempo de RTX 4090 acaba en una factura de 42,23 $.
Nada de esto se oculta a propósito. Simplemente es fácil pasarlo por alto cuando comparas plataformas por la cifra del titular. Todo lo que sigue se ha comprobado en la documentación y las páginas de precios de cada plataforma en septiembre de 2026; los enlaces están al final. Para los precios de titular, consulta la comparativa de precios de alquiler de GPU.
Los extras de cada plataforma
| Coste | Vast.ai | RunPod | Lambda | AWS EC2 | GPUFlow |
|---|---|---|---|---|---|
| Unidad de facturación | Por segundo | Por segundo | Por minuto | Por segundo, mínimo de 60 s | Por segundo, mínimo de 1 min |
| Almacenamiento con la máquina parada | Facturado a la tarifa del host | Disco de volumen a 0,20 $/GB/mes | Sistemas de archivos facturados por GiB/mes | EBS sigue facturando | Ninguno |
| Transferencia de datos | Tarifa del host, cada byte | Sin cargos | Sin cargos | Salida: 100 GB/mes gratis, luego por GB | Ninguna |
| Para empezar | Depósito mínimo de 5 $ | 1 hora de crédito; 100 $ con tarjetas prepago | Preautorización de 10 $ en la tarjeta | Un método de pago | Recarga de 10 $; contratación reservada entera |
| El saldo llega a cero | Parada y luego destruida | Parado; sin volumen de red, los datos se pierden | Facturación semanal tras el uso | n/d | No puede pasar a mitad de un alquiler |
GPUFlow puede saltarse las filas de almacenamiento y transferencia porque alquila algo distinto: una clave API compatible con OpenAI para modelos de IA que ya funcionan en la GPU de un proveedor, no una máquina en la que inicias sesión. La contrapartida es que no puedes ejecutar tu propio código, entrenar ni hacer fine-tuning. Si necesitas una máquina, las columnas que te aplican son las otras cuatro.
Almacenamiento, sobre todo con la máquina parada
En cualquier plataforma que te alquile una máquina o un contenedor, tus archivos viven en un disco, y el disco cuesta dinero mientras exista.
- RunPod cobra 0,10 $ por GB al mes por el disco del contenedor y el de volumen mientras el pod funciona. Cuando paras el pod, el disco del contenedor se borra y no cuesta nada, pero el disco de volumen sube a 0,20 $ por GB al mes. Los volúmenes de red cuestan 0,07 $ por GB al mes por debajo de 1 TB y 0,05 $ por encima, estén en marcha o no. Los planes de ahorro solo cubren el cómputo de GPU; el almacenamiento se factura a tarifa estándar.
- Vast.ai factura el almacenamiento «por cada segundo que existe tu instancia», en todos los estados salvo desconectada. Su documentación no se anda con rodeos: «Parar una instancia no evita los costes de almacenamiento». La tarifa la pone el host.
- AWS no cobra el cómputo ni la transferencia de datos de una instancia parada, pero «se generan cargos por almacenar los volúmenes de Amazon EBS», y una Elastic IP asociada a una instancia parada sigue facturando. Un volumen gp3 en us-east-1 cuesta unos 0,08 $ por GB al mes.
- Lambda factura los sistemas de archivos por GiB usado al mes, en incrementos de una hora.
Un disco de volumen de 200 GB en un pod parado de RunPod cuesta 200 × 0,20 $ = 40 $ al mes, aunque no vuelvas a arrancar el pod nunca. Eso es más que 100 horas de una RTX 4090 al precio de la Community Cloud de RunPod.
Quedarte sin crédito lo empeora. Cuando el saldo de RunPod llega a 0 $, los pods se paran, y «los pods sin volumen de red se eliminan y sus datos no se pueden recuperar». Vast.ai también para las instancias y, si no tienes una tarjeta guardada, «tus instancias y los datos almacenados se destruirán» tras un breve periodo de gracia. Así que un volumen olvidado o te sigue cobrando o desaparece con tu trabajo dentro.
Lo que hago yo: borro los volúmenes el día que termina un proyecto, guardo solo lo que aún necesito en un volumen de red pequeño y tengo una copia de todo lo importante fuera de la plataforma de GPU.
Transferencia de datos
Descargar un modelo de 15 GB y subir un conjunto de datos puede mover decenas de gigabytes por sesión.
- Vast.ai cobra «precios de ancho de banda por cada byte enviado o recibido hacia o desde la instancia, sea cual sea su estado». Cada host fija su propio precio de subida y de bajada, y la documentación advierte de que «puede afectar mucho al coste total en cargas de trabajo con mucho movimiento de datos». Míralo en la oferta antes de alquilar.
- RunPod dice que los pods no tienen «cargos por entrada ni salida de datos».
- Lambda: «No se te cobra la entrada ni la salida de datos».
- AWS: la entrada de datos es gratis. La salida a internet es gratis los primeros 100 GB al mes sumando todos los servicios y regiones, y a partir de ahí se factura por GB en tramos. Cada dirección IPv4 pública cuesta 0,005 $ la hora, se use o no, lo que son 3,60 $ en un mes de 720 horas.
Depósitos, retenciones y crédito prepago
La mayoría de las plataformas de GPU son de prepago: compras crédito y luego lo gastas. El dinero que dejas allí aparcado también es un coste, sobre todo cuando no puede volver.
- Vast.ai: depósito mínimo de 5 $, con tarjeta, BitPay o Crypto.com. El crédito no gastado comprado con tarjeta se puede reembolsar pidiéndolo por el chat del sitio; el gastado no.
- RunPod: necesitas al menos una hora de crédito para el pod que elijas, y con tarjetas prepago conviene depositar al menos 100 $ por operación. Los créditos no son reembolsables y no se pueden retirar.
- Lambda funciona al revés: factura cada semana el uso de la semana anterior y hace una preautorización de 10 $ cuando añades una tarjeta, que se devuelve en unos días. Solo acepta las principales tarjetas de crédito; las prepago y las de débito se rechazan.
- SaladCloud: recargas de 5 $ a 10.000 $, y el crédito caduca a los 12 meses de la compra.
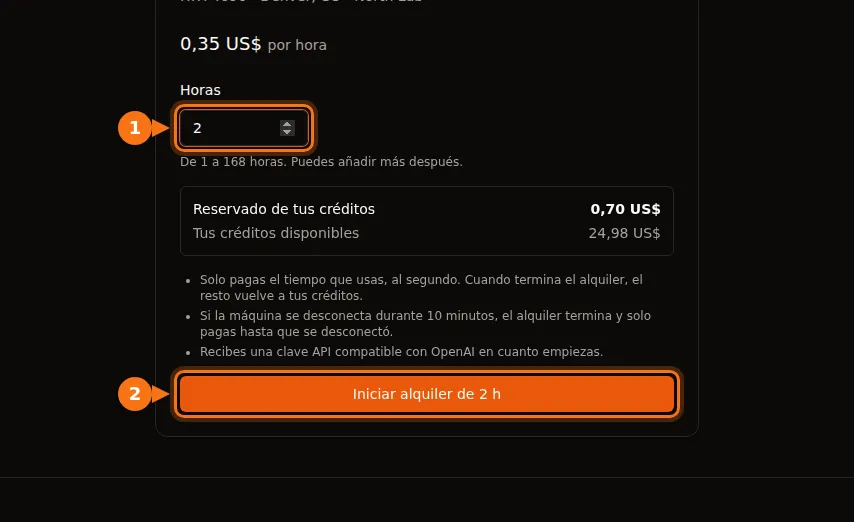
- GPUFlow: recargas de 10 $ a 500 $ con tarjeta a través de Stripe, sin comisión, y los créditos no caducan. Al empezar un alquiler se reserva de tus créditos el importe completo contratado, no un pequeño depósito. Si contratas 10 horas a 0,40 $, se reservan 4,00 $ hasta que termina el alquiler; lo que no hayas usado vuelve en ese momento. Los créditos comprados no se pueden cobrar en efectivo, y los reembolsos a la tarjeta solo se hacen por un cargo duplicado o erróneo, por créditos que nunca llegaron o por obligación legal, en un plazo de 60 días.
El crédito que caduca, o que se queda en una plataforma que ya no usas, es dinero gastado. Recarga para el trabajo que esperas hacer este mes, no para todo el año.
Preparación y tiempo ocioso
Una máquina alquilada factura tiempo, no trabajo. Hay dos tipos de tiempo que cuestan lo mismo que el trabajo real y no producen nada.
Preparación
El contador arranca con la máquina. En Lambda, «la facturación empieza en cuanto lanzas una instancia y esta supera las comprobaciones de estado». Instalar librerías, descargar una imagen de contenedor y descargar un modelo ocurren en tiempo facturado. A 0,34 $ la hora, 15 minutos de preparación son unos 0,09 $. Poca cosa una vez, pero si lo haces cada día durante un mes son unas cuantas horas de GPU.
Hay dos cosas que ayudan: partir de una plantilla o una imagen que ya tenga tu stack, y guardar los modelos en un volumen para descargarlos una sola vez (y luego compararlo con el coste de almacenamiento de arriba).
En GPUFlow no hay paso de preparación por tu parte: el proveedor ya ha instalado los modelos en la máquina y recibes la clave API justo después de empezar el alquiler.
Tiempo ocioso
Lambda lo dice claramente: «Las instancias se facturan mientras estén en marcha, tanto si se están usando como si no». Google Cloud dice lo mismo de una VM ociosa que sigue en estado RUNNING. Dejar un pod encendido por la noche para tenerlo listo por la mañana cuesta una noche de GPU.
Azure tiene una trampa adicional. Una VM que solo está «Stopped» (por ejemplo, apagada desde dentro del sistema operativo) sigue facturando sus núcleos. Tiene que quedar «Stopped (Deallocated)» desde el portal o la CLI para que termine el cargo de cómputo.
GPUFlow tampoco se libra: pagas hasta que haces clic en Terminar ahora o se acaba el tiempo contratado. Terminar antes no cuesta nada y la parte no usada de la reserva vuelve, así que la solución es simplemente terminar el alquiler cuando acabes. Cómo funciona la facturación de GPUFlow.
Incrementos y mínimos de facturación
La facturación por segundo es habitual hoy en día, pero los detalles cambian:
| Plataforma | Cómo se factura el tiempo |
|---|---|
| Vast.ai | Por segundo |
| RunPod pods | Por segundo (la página de descripción general de los pods todavía dice por minuto) |
| RunPod serverless | Por segundo, redondeando hacia arriba, incluido el arranque del worker y un tiempo de espera por inactividad (5 segundos por defecto) |
| Lambda | Incrementos de un minuto |
| AWS EC2 (Linux) | Por segundo, mínimo de 60 segundos |
| Google Cloud | Por segundo tras un mínimo de 1 minuto |
| Azure | Minutos completos |
| GPUFlow | Por segundo, mínimo de 1 minuto, redondeado al céntimo superior |
En trabajos largos estas diferencias son ruido. Importan cuando hay muchas sesiones cortas y en serverless, donde el arranque y el tiempo de espera por inactividad se facturan además de las peticiones. Si envías peticiones cortas con huecos entre ellas, eso puede costar más que las propias peticiones. Facturación por segundo o por hora hace las cuentas.
Instancias interrumpibles
La capacidad interrumpible (spot) es más barata, a veces mucho más, pero te la pueden quitar.
- Vast.ai dice que las instancias interrumpibles son «a menudo un 50 % o más baratas que las bajo demanda».
- En AWS, en septiembre de 2026, una p5.4xlarge (una H100) costaba 2,62 $ la hora en spot frente a 6,88 $ bajo demanda.
- En TensorDock, el almacenamiento se factura a la tarifa estándar además de tu puja, y lo sigues pagando mientras otra puja supera la tuya. Los hosts fijan una puja mínima, normalmente en torno al 50 % del precio bajo demanda.
El coste oculto es repetir trabajo. Si tu trabajo no puede reanudarse desde un checkpoint, una sola interrupción puede comerse el ahorro. Guarda checkpoints con la frecuencia suficiente para que perder el último intervalo no duela.
Las comisiones de tu banco
Casi todas las plataformas de GPU, GPUFlow incluida, cobran en dólares estadounidenses. Si tu tarjeta está en otra divisa, tu banco puede añadir su propia comisión:
- Las comisiones por operaciones en el extranjero suelen ir del 1 % al 3 %, y algunos bancos las cobran en compras a comercios extranjeros aunque el precio se muestre en dólares estadounidenses.
- La mayoría de las tarjetas de crédito canadienses cobran en torno al 2,5 % en compras en otra divisa.
- En Brasil, el IOF sobre compras internacionales con tarjeta es del 3,5 % desde julio de 2025.
En una recarga de 100 $ son entre 1 $ y 3,50 $ que no verás en la factura de la plataforma. Una tarjeta sin comisión por operaciones en el extranjero elimina casi todo.
Un ejemplo resuelto: 0,34 $ la hora, 42 $ al mes
Este es un mes realista con una RTX 4090 de la Community Cloud de RunPod a 0,34 $ la hora, pagando con una tarjeta de crédito canadiense:
- 40 horas de trabajo real: 40 × 0,34 $ = 13,60 $. Esta es la cifra que la gente presupuesta.
- 20 sesiones con 15 minutos de preparación cada una, 5 horas: 5 × 0,34 $ = 1,70 $.
- Dos noches con el pod encendido, 10 horas cada una: 20 × 0,34 $ = 6,80 $.
- Un disco de volumen de 100 GB conservado todo el mes. Está en marcha 65 de las 720 horas del mes y parado las otras 655: 100 × (0,10 $ × 65/720 + 0,20 $ × 655/720) = unos 19,10 $.
- Subtotal de 41,20 $, más una comisión por operación en el extranjero del 2,5 %: 1,03 $.
Total: 42,23 $, unas 3,1 veces el trabajo de GPU que habías previsto. RunPod no cobra la transferencia de datos, así que en un host de Vast.ai con precio de ancho de banda habría una línea más.
La partida más grande ni siquiera es la GPU: es un disco que estuvo parado el 91 % del mes. La solución es aburrida: borra el volumen o redúcelo, y termina el pod cuando dejes de trabajar.
Lista de comprobación antes de alquilar
- Suma el tiempo de GPU y el almacenamiento durante todo el tiempo que vayas a conservar los archivos, a la tarifa de máquina parada.
- Revisa el precio del ancho de banda en la oferta si la plataforma lo tiene, y calcula cuánto vas a descargar.
- Cuenta el tiempo de preparación como tiempo pagado.
- Ten claro cómo vas a dejar de pagar: terminar el alquiler, parar o desasignar la máquina, borrar el volumen.
- Ten claro qué pasa con tus datos si el saldo llega a cero.
- Consulta la comisión por operaciones en el extranjero de tu tarjeta.
Si lo que necesitas es un modelo de IA al que llamar desde tu código, y no una máquina para ejecutar tu propio software, un alquiler basado en API se ahorra por completo las líneas de almacenamiento, transferencia y preparación. ¿GPU por horas o API por token? lo compara con pagar por token, y GPUFlow vs Vast.ai vs RunPod vs SaladCloud explica qué plataforma encaja con cada trabajo. Para entrenar o para cualquier otra cosa que necesite una máquina completa, esta lista es la forma de mantener la factura cerca del precio por hora.
Fuentes
- RunPod: precios y almacenamiento de los pods, página de precios, descripción general de los pods, precios de serverless, información de facturación, precios de la RTX 4090
- Vast.ai: precios, facturación, guía rápida (depósito mínimo)
- Lambda: facturación, gestionar la facturación
- SaladCloud: facturación
- TensorDock: instancias spot
- AWS: precios bajo demanda de EC2, cómo funcionan la parada y el arranque, precios de VPC (IPv4 pública), precios de la p5.4xlarge vía Vantage, precio de gp3: guía de precios de EBS de CloudBurn
- Google Cloud: precios de las instancias de VM
- Azure: precios y FAQ de las VM Linux
- Comisiones de tarjeta: Experian, NerdWallet Canadá, IOF de Brasil: Wise Brasil
- GPUFlow: facturación, primeros pasos, mercado
Todas revisadas en septiembre de 2026.