Es razonablemente seguro si eliges la plataforma sabiendo lo que haces, pero «seguro» significa cosas distintas en cada plataforma. En plataformas de contenedores como Vast.ai, el inquilino ejecuta su propio código en tu máquina y su tráfico sale desde tu dirección IP; el aislamiento lo mantiene fuera de tus archivos, no fuera de tu red ni de tu factura de la luz. En un diseño solo de API como GPUFlow, el inquilino solo puede enviar peticiones de chat a los modelos que instalaste, y el riesgo se invierte: los prompts se pueden leer en tu máquina, así que los inquilinos no deberían enviar nada secreto.
Este artículo recorre las dos direcciones. Lo que afirman terceros se comprobó en la documentación de cada plataforma en septiembre de 2026, y todo lo relativo a GPUFlow sale de su código fuente y su documentación. Las fuentes están al final.
Qué puede hacer un inquilino en una plataforma de contenedores
La mayoría de los mercados de GPU alquilan un contenedor. El inquilino elige una imagen, obtiene una shell y ejecuta lo que quiera. A ti, como anfitrión, eso te deja cinco cosas en las que pensar.
- Código arbitrario. El código del inquilino se ejecuta sobre tu kernel, dentro de un contenedor o una VM. El aislamiento es bueno, pero no perfecto; las fugas de contenedor son raras, y son justo el tipo de fallo que se corrige en las actualizaciones del kernel y de los drivers que tienes que instalar.
- Tu dirección IP. El tráfico saliente del contenedor sale por tu conexión a internet. Si un inquilino hace scraping de una web, envía spam o escanea internet, la denuncia por abuso llega a tu proveedor de internet, dirigida a tu IP. Las condiciones de Vast.ai dicen que los usuarios indemnizan a los proveedores frente a reclamaciones derivadas del contenido de los usuarios, lo que ayuda en una disputa con un tercero, pero no impide que tu proveedor de internet te mande un aviso.
- Puertos abiertos. La guía para anfitriones de Vast.ai dice que «los clientes necesitan puertos abiertos para conectarse directamente a la máquina en la mayoría de los trabajos», así que redirigirás puertos en tu router.
- Disco. Los inquilinos descargan imágenes, modelos y conjuntos de datos en tus discos. Vast.ai libera el espacio cuando un cliente borra un volumen, pero mientras dura el alquiler, es suyo.
- Consumo, calor y drivers. Vast.ai avisa a los anfitriones: «cuenta con que la GPU se usará cerca de su capacidad máxima durante el alquiler». Eso son horas a plena potencia de la tarjeta, calor en la habitación y ventiladores girando. Las plataformas de contenedores también piden una instalación concreta: la guía de Vast.ai incluye instalar Ubuntu, particionar discos, instalar los drivers de NVIDIA y abrir puertos en el router.
Cómo aíslan a los inquilinos Vast.ai, Salad y RunPod
| Vast.ai | Salad | RunPod Community Cloud | |
|---|---|---|---|
| El inquilino obtiene | Un contenedor (o una VM) con SSH o Jupyter | Un contenedor que ha desplegado; SSH y un terminal web dentro de él | Un pod (contenedor) |
| Aislamiento | Contenedores Docker sin privilegios | VM Linux sobre un hipervisor, con el contenedor dentro | «Su propio contenedor con separación estricta» |
| Puertos de entrada | Necesarios para la mayoría de los trabajos | Bloqueados por defecto | No se indica |
| Nuevos anfitriones | Sí, en Ubuntu | Sí, en Windows 10/11 | Ya no se aceptan |
- Vast.ai dice que «los clientes están aislados en contenedores Docker sin privilegios y solo tienen acceso a sus propios datos», con espacios de nombres y cgroups separados y aislamiento de red, de sistema de archivos y de procesos. También advierte a los inquilinos de que «la seguridad de los proveedores varía mucho» y remite el trabajo sensible a su nivel Secure Cloud de centros de datos certificados.
- Salad dice: «tu carga se ejecuta en un contenedor compatible con OCI dentro de una máquina virtual Linux, aislada de Windows y de cualquier otro proceso del anfitrión», con las conexiones entrantes bloqueadas por defecto. También protege a los inquilinos de los anfitriones: si un anfitrión «intenta acceder al entorno Linux, destruimos automáticamente el entorno y ponemos la máquina en la lista negra». Aparte, Salad ofrece trabajos opcionales de compartir ancho de banda que «procesan contenido de vídeo de plataformas de streaming de pago» a través de tu conexión; su página de soporte avisa de que esto aumenta tu consumo de datos y puede provocar «una restricción de contenido poco frecuente y temporal (normalmente de 1 a 2 días) en esas plataformas de streaming».
- RunPod dice que «ya no acepta nuevos anfitriones en Community Cloud». Para la capacidad existente, «cada pod o worker funciona en su propio contenedor», y sus condiciones «prohíben a los anfitriones inspeccionar los datos de tu pod o worker».
Las tres aíslan al inquilino de tu sistema. Ninguna puede impedir que el tráfico de apariencia legítima de un inquilino salga por tu conexión, y ninguna dice que pueda.
En qué se diferencia el diseño de GPUFlow
GPUFlow no alquila una máquina, sino un modelo de IA detrás de una API compatible con OpenAI. Eso cambia lo que un inquilino puede tocar. Esto es lo que hace el código.
El agente. El instalador coloca un único binario de Go en /usr/local/bin/gpuflow-agent y lo ejecuta como servicio de systemd. No hay Docker. La unidad del servicio usa DynamicUser=yes (un usuario temporal sin privilegios), NoNewPrivileges=yes (no puede ganar permisos), ProtectSystem=strict (el sistema es de solo lectura para él), ProtectHome=yes (las carpetas personales son invisibles) y PrivateTmp=yes. El motor de inferencia es Ollama por defecto, instalado con el instalador del propio Ollama como servicio aparte (un proveedor puede, en su lugar, apuntar el agente a su propio servidor compatible con OpenAI). Este endurecimiento se aplica al agente, no a Ollama.
Red. El agente solo hace conexiones salientes: un WebSocket sobre TLS a wss://ws.gpuflow.app, y HTTPS a gpuflow.app para registrarse y enviar una señal de vida cada 15 segundos. No abre puertos, no rediriges nada en el router y los inquilinos nunca conocen tu dirección IP. Habla con Ollama en 127.0.0.1:11434, la dirección de loopback por defecto de Ollama.
Qué pueden llamar los inquilinos. El inquilino recibe una clave API para https://gpuflow.app/v1. GPUFlow responde él mismo a GET /v1/models, y la única petición que reenvía a tu máquina es POST /v1/chat/completions. El agente tiene además un segundo cerrojo propio: solo hace de proxy para cuatro rutas exactas (/v1/chat/completions, /v1/completions, /v1/embeddings y /v1/models) y rechaza todo lo demás, incluidos los endpoints nativos /api/* de Ollama que servirían para descargar, borrar o crear modelos. El agente gestiona un único tipo de mensaje, la petición de inferencia; cualquier otro se ignora.
Así que el inquilino no tiene shell, ni SSH, ni archivos, ni acceso de red a tu máquina. No puede descargar un modelo de 70 GB en tu disco ni usar tu conexión para salir a internet. Lo que sí puede hacer es tener tu GPU ocupada durante las horas que ha contratado y poner en el campo model cualquier modelo que tengas instalado.
El recorrido de los datos, salto a salto
Esta es la parte que deberían leer los inquilinos. Una petición de chat pasa por cuatro programas, y el texto se puede leer en más de uno.
- Del inquilino a gpuflow.app: HTTPS. La web está detrás de Cloudflare.
- De la API de GPUFlow a su relé: una conexión interna en el lado de GPUFlow. La API comprueba la clave, reenvía el cuerpo de la petición sin cambios y registra el número de tokens. No guarda el texto de las peticiones ni de las respuestas, y así lo dice su política de privacidad.
- Del relé al agente del proveedor: un WebSocket con TLS que abrió el agente. El relé registra el tipo de cada mensaje, no su contenido.
- Del agente a Ollama: HTTP sin cifrar por la dirección de loopback dentro del PC del proveedor. El agente tampoco registra el cuerpo de las peticiones.
No hay cifrado de extremo a extremo hasta el modelo, y con un motor de inferencia normal no puede haberlo: el modelo tiene que leer el prompt para responderlo.
Qué puede ver el proveedor
Dicho sin rodeos: el ordenador del proveedor maneja tus prompts y respuestas sin cifrar. Ollama se ejecuta ahí, y el proveedor tiene root en la máquina (el instalador lo exige). Un proveedor que quisiera podría capturar el tráfico de loopback, cambiar el motor o apuntar el agente a otro servidor.
Lo que lo impide es el contrato. Las condiciones de GPUFlow dicen que los proveedores no deben «grabar, leer, conservar ni compartir las peticiones o respuestas de los inquilinos, ni modificar las respuestas». Es una norma con consecuencias para la cuenta, no un bloqueo técnico. La política de privacidad dice lo mismo a los inquilinos: las peticiones y las respuestas pasan por el ordenador del proveedor mientras dura el alquiler.
Además de los prompts, el proveedor ve tu nombre de usuario de GPUFlow y recibe un aviso cuando empieza un alquiler (id del alquiler, anuncio y horas). Los inquilinos no ven nada de las estadísticas de la máquina del proveedor; la temperatura de la GPU, la VRAM, el consumo y el resto de la telemetría solo llegan al panel del dueño.
La regla práctica para inquilinos: no envíes secretos, credenciales, datos personales de otras personas ni datos regulados (sanitarios, financieros, confidenciales de clientes) a través de ninguna GPU comunitaria. Vale para GPUFlow y exactamente igual para un contenedor en el PC de casa de alguien, donde el anfitrión puede inspeccionar la memoria y el disco con el mismo acceso root. Para trabajo sensible, ejecuta el modelo en hardware que controles o usa un proveedor que firme el acuerdo que exige tu cumplimiento normativo. Por qué algunas empresas prohíben las herramientas de IA públicas trata el lado de las políticas, y cómo proteger un conjunto de datos en un nodo de GPU público el lado de los contenedores.
Lo que sigue teniendo riesgo en GPUFlow
Limitarse a una API reduce la superficie de ataque. No la elimina, y prefiero enumerar lo que queda a fingir lo contrario.
- Ollama procesa entradas no fiables. Cada petición de un inquilino acaba como JSON entregado a Ollama. Un fallo en Ollama es la vía de entrada más probable, así que mantenlo actualizado. La lista de rutas permitidas del agente aleja a los inquilinos de los endpoints de gestión de modelos de Ollama, pero no puede arreglar un fallo en la ruta de chat.
- El instalador se ejecuta como root. Pasas un script de gpuflow.app a
sudo bash, y ese script también ejecuta el instalador de Ollama. Léelos antes; es buena práctica con cualquier software de alojamiento. - Sin actualización automática. El agente no se actualiza solo. Para tener una versión nueva, vuelve a ejecutar el instalador, que comprueba el binario contra un archivo SHA256SUMS cuando se publica uno.
- Carga. No hay límite de peticiones. Un inquilino puede tener tu GPU a plena carga todas las horas que ha contratado, y puede usar cualquier modelo que tengas instalado, incluido el más grande.
- Calor y consumo. Igual que en cualquier otro sitio: horas alquiladas son horas con carga.
Lista de comprobación para proveedores
- Usa una máquina que te puedas permitir prestar. Lo ideal es un equipo dedicado. Como mínimo, no guardes archivos de trabajo ni gestores de contraseñas en el ordenador que alquilas, sea cual sea la plataforma. En GPUFlow el agente ya se ejecuta como usuario temporal del sistema con las carpetas personales ocultas, pero Ollama es un servicio aparte.
- Limita el consumo.
sudo nvidia-smi -pl 280fija el límite de potencia de la tarjeta en vatios (necesita root, y el valor tiene que estar entre los límites mínimo y máximo de la tarjeta). Puget Systems informa de que las RTX 3090 limitadas a 270-280 W conservan alrededor del 95 % de su rendimiento, y explica cómo volver a aplicar el límite en cada arranque con una unidad de systemd. - Haz antes la cuenta de la luz. Mira el consumo en Mis máquinas mientras la GPU está ocupada y multiplica los kilovatios por tu precio del kWh. Lo que puede ganar tu GPU de gaming hace la cuenta para las tarjetas más comunes y cinco países.
- Vigila la temperatura. Las estadísticas en directo muestran la temperatura de la GPU, del punto más caliente y de la memoria, y la velocidad del ventilador. Asegúrate de que a la caja le llega aire.
- Mantén el sistema actualizado. Instala las actualizaciones de Linux, del driver de la GPU y de Ollama. El instalador de GPUFlow no gestiona el driver de tu GPU; systemd vuelve a arrancar el agente después de un reinicio.
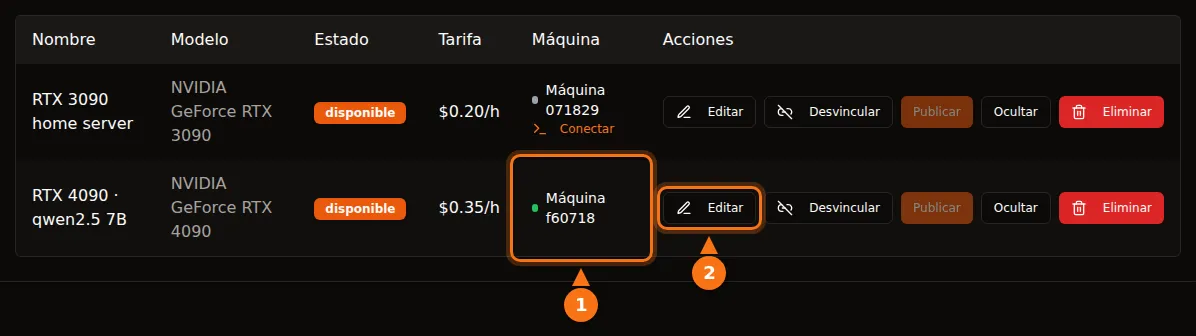
- Aprende a hacer una pausa. Oculta el anuncio en Mis GPUs o ejecuta
sudo systemctl stop gpuflow-agent(startlo vuelve a poner en marcha). Mientras hay un alquiler activo, el panel no te deja cambiar el anuncio ni la máquina, y no puedes terminar desde ahí el alquiler de un inquilino. Si detienes el agente a mitad de un alquiler, el alquiler termina a los 10 minutos y solo cobras hasta la última señal de vida. - Aprende a desinstalar. Los pasos están en la documentación de resolución de problemas. Ollama sigue instalado hasta que lo quites.
En las plataformas de contenedores, añade dos puntos: decide si de verdad quieres puertos abiertos en tu router y pregunta a tu proveedor de internet qué hace con las denuncias por abuso, porque el tráfico de los inquilinos llevará tu dirección IP.
Lista de comprobación para inquilinos
- Trata cualquier GPU comunitaria como el ordenador de un desconocido. Nada de claves API, contraseñas, datos de clientes ni datos médicos o financieros en los prompts.
- Quita lo que no necesites. Sustituye nombres y números de cuenta por marcadores antes de enviar nada.
- Protege tu clave. En GPUFlow la clave deja de funcionar cuando termina el alquiler. Si se filtra, Nueva clave revoca la antigua al instante, y Terminar ahora detiene la facturación y te devuelve el tiempo no usado.
- Da por hecho que las respuestas pueden ser incorrectas o estar alteradas. Las condiciones prohíben a los proveedores modificar las respuestas, pero comprueba cualquier cosa importante.
- Usa la herramienta adecuada para el trabajo sensible. Aloja el modelo tú mismo o usa un proveedor que ofrezca el contrato que necesitas. Cómo usar la clave en tus aplicaciones sirve para todo lo demás.
Fuentes
Todas revisadas en septiembre de 2026.
- GPUFlow: qué pueden tocar los inquilinos, primeros pasos para proveedores, precios y electricidad, resolución de problemas y desinstalación, guía rápida de la API
- Vast.ai: resumen para anfitriones, FAQ de seguridad, máquinas virtuales Linux, condiciones del servicio, ejecutar modelos de IA privados
- Salad: seguridad, cargas en contenedores y tu PC, compartir ancho de banda, SSH y terminal, descarga y requisitos del sistema
- RunPod: elegir un pod, seguridad de datos y cumplimiento legal
- Ollama: FAQ (dirección de escucha por defecto)
- NVIDIA: manual de nvidia-smi
- Puget Systems: limitar la potencia de las RTX 3090 con systemd y nvidia-smi