Con la cuantización de 4 bits que Ollama trae por defecto, un modelo de 7B u 8B necesita una tarjeta de 8 GB, los modelos de 12B a 14B necesitan 12 GB (16 GB si quieres prompts largos) y los de 27B a 32B necesitan 24 GB. Un modelo de 70B a 4 bits ocupa 43 GB, es decir, 48 GB de VRAM o más.
La versión larga importa porque el tamaño de la descarga no es toda la factura. El contexto que usas también ocupa memoria, y un modelo que parece caber puede acabar a medias en la CPU y varias veces más lento. Abajo están la fórmula que uso, qué significan las etiquetas de cuantización y una tabla de modelos abiertos actuales con sus tamaños de descarga reales en la biblioteca de Ollama. Los tamaños y las especificaciones se revisaron en septiembre de 2026; las fuentes están al final.
Respuesta rápida según la VRAM
| VRAM | Tarjetas típicas | Qué funciona entero en la GPU (4 bits) |
|---|---|---|
| 8 GB | RTX 4060, RTX 5060, RTX 3070 | Modelos de 7B a 8B: Llama 3.1 8B, Qwen3 8B, Mistral 7B |
| 12 GB | RTX 3060 12 GB, RTX 4070, RTX 5070 | Modelos de 12B a 14B con contexto corto; de 7B a 8B en Q8_0 |
| 16 GB | RTX 4060 Ti 16 GB, RTX 4080, RTX 5080 | 14B con contexto largo, gpt-oss 20B |
| 24 GB | RTX 3090, RTX 4090 | De 24B a 32B: Mistral Small 3.2, Gemma 3 27B, Qwen3 32B |
| 32 GB | RTX 5090 | 32B con contexto largo, modelos de mezcla de expertos de 35B |
| De 48 a 80 GB | L40S (48 GB), H100 (80 GB) | 70B a 4 bits, gpt-oss 120B en 80 GB |
Las memorias de las tarjetas salen de las fichas técnicas de NVIDIA. Algunas tarjetas existen en dos versiones: la RTX 3060 con 12 GB y con 8 GB, y la RTX 4060 Ti y la RTX 5060 Ti con 16 GB y con 8 GB. Comprueba cuál compras o alquilas.
Cómo estimar la VRAM que necesita un modelo
Mientras un modelo te responde, en la memoria de la GPU hay tres cosas:
- Los pesos. Parámetros × bits por peso ÷ 8 = bytes.
- La caché KV. El modelo guarda las claves y los valores de cada token de la conversación para no recalcularlos. Por token son 2 × capas × cabezas KV × tamaño de cabeza × 2 bytes (con la caché de 16 bits por defecto). Multiplícalo por la longitud de contexto.
- La sobrecarga. El contexto CUDA, los búferes temporales y el propio motor. Yo cuento con 1 GB, más o menos. Varía según el motor y la configuración, así que tómalo como una regla práctica, no como una especificación.
El número de capas y de cabezas está en el config.json de cada modelo en Hugging Face.
Ejemplo práctico: Qwen 2.5 14B en una tarjeta de 16 GB
Qwen 2.5 14B tiene 14.700 millones de parámetros, 48 capas, 8 cabezas KV y un tamaño de cabeza de 128 (5.120 de tamaño oculto ÷ 40 cabezas de atención).
- Pesos en Q4_K_M: llama.cpp da para Q4_K_M unos 4,89 bits por peso. 14.700 millones × 4,89 ÷ 8 = 8,99 GB. La descarga de
qwen2.5:14ben Ollama ocupa 9,0 GB, así que la cuenta coincide con el archivo real. - Caché KV por token: 2 × 48 × 8 × 128 × 2 bytes = 196.608 bytes, unos 0,2 MB.
- Caché KV para todo el contexto: 4.096 tokens = 0,8 GB. 16.384 tokens = 3,2 GB. 32.768 tokens = 6,4 GB.
- Total: 9,0 + 0,8 + 1 = 10,8 GB con 4K de contexto. 9,0 + 3,2 + 1 = 13,2 GB con 16K. 9,0 + 6,4 + 1 = 16,4 GB con 32K, que ya no cabe en una tarjeta de 16 GB.
De aquí salen dos cosas. La primera: el contexto que configuras puede costar tanta memoria como el modelo. Llama 3.1 8B (32 capas, 8 cabezas KV, tamaño de cabeza 128) necesita 131.072 bytes de caché KV por token, así que su contexto completo de 128K necesitaría 17,2 GB solo de caché, unas tres veces y media su descarga de 4,9 GB. La segunda: el tamaño de la caché KV por token cambia mucho de un modelo a otro. Qwen 2.5 7B tiene solo 4 cabezas KV y 28 capas, así que necesita 57.344 bytes por token, menos de la mitad que Llama 3.1 8B. Mira la configuración antes de dar nada por hecho.
Qué hace Ollama con el contexto por defecto
Ollama elige una longitud de contexto por defecto según la VRAM que encuentra: 4K tokens por debajo de 24 GiB, 32K tokens de 24 a 48 GiB y 256K a partir de 48 GiB. Puedes cambiarla con la variable de entorno OLLAMA_CONTEXT_LENGTH, y ollama ps muestra en su columna CONTEXT el contexto realmente reservado. Hay dos ajustes más que cambian la cuenta:
OLLAMA_NUM_PARALLEL(por defecto 1): la documentación de Ollama dice que las peticiones en paralelo multiplican el tamaño del contexto por el número de peticiones en paralelo. Cuatro huecos en paralelo son cuatro veces la caché KV.OLLAMA_KV_CACHE_TYPE:q8_0usa más o menos la mitad de memoria que la cachéf16por defecto, yq4_0una cuarta parte. Requiere tener activada la flash attention.
Qué significan los niveles de cuantización
Los modelos abiertos se publican con precisión de 16 bits (las configuraciones enlazadas abajo indican bfloat16): dos bytes por parámetro. La cuantización guarda los pesos en menos bits. En los archivos GGUF, el formato que usan Ollama y llama.cpp, las etiquetas significan más o menos esto:
| Etiqueta | Bits por peso | Tamaño de Llama 3.1 8B | Perplejidad en Llama 3 8B (menos es mejor) |
|---|---|---|---|
| F16 | 16,0 | 14,96 GiB | 6,233 |
| Q8_0 | 8,50 | 7,95 GiB | 6,234 |
| Q6_K | 6,56 | 6,14 GiB | 6,253 |
| Q5_K_M | 5,70 | 5,33 GiB | 6,289 |
| Q4_K_M | 4,89 | 4,58 GiB | 6,407 |
| Q3_K_M | 4,00 | 3,74 GiB | 6,888 |
| Q2_K_S / Q2_K | 2,97 | 2,78 GiB | 9,752 (Q2_K) |
Los bits por peso y los tamaños salen del README de quantize de llama.cpp (Llama 3.1 8B). La perplejidad sale del README de perplexity de llama.cpp (Llama 3 8B, Wikitext). Los tipos «K» son las k-quants de llama.cpp, que mezclan precisiones a lo largo del modelo; _S, _M y _L son mezclas pequeña, mediana y grande.
Lo que dicen los números: Q8_0 es prácticamente sin pérdidas (perplejidad de 6,234 frente a 6,233). Q4_K_M cuesta alrededor de un 3 % de perplejidad, y el mismo README indica que su token siguiente más probable coincide con el del modelo a precisión completa el 91,9 % de las veces. Q3 es claramente peor, y Q2 se desmorona.
La perplejidad no es lo mismo que la utilidad, así que viene bien que un estudio de Uygar Kurt de enero de 2026 pasara Llama 3.1 8B Instruct por benchmarks de razonamiento, conocimiento, seguimiento de instrucciones y veracidad en cada nivel de llama.cpp. La media sin ponderar fue 69,47 en F16, 69,41 en Q8_0, 69,36 en Q5_K_M y 69,15 en Q4_K_M. Por eso casi todo el mundo, Ollama incluido, usa Q4_K_M por defecto: el archivo ocupa menos de un tercio que en FP16 a cambio de una pérdida que rara vez notarás. En Ollama, la etiqueta sin más es esa versión de 4 bits: qwen3:8b y qwen3:8b-q4_K_M ocupan 5,2 GB los dos, y phi4:14b y phi4:14b-q4_K_M, 9,1 GB los dos.
Mi regla: coge el modelo más grande que quepa en Q4_K_M antes que un modelo más pequeño en Q8_0. Un 14B en Q4 suele ganar a un 7B en Q8, y los archivos ocupan más o menos lo mismo. Sube a Q5 o Q8 cuando te sobre memoria y la tarea sea sensible a errores pequeños, como el código o la extracción exacta de datos.
Las etiquetas más recientes de Ollama también incluyen formatos como qat (las versiones de Gemma entrenadas con cuantización), nvfp4 y mxfp8. gpt-oss lo publica la propia OpenAI en MXFP4, con 4,25 bits por parámetro para los pesos de mezcla de expertos.
Qué modelos caben: tamaños y niveles de VRAM
La tabla recoge modelos abiertos actuales de la biblioteca de Ollama en septiembre de 2026 con sus tamaños de descarga. La columna «4 bits» es el tamaño de la etiqueta por defecto. En la mayoría de modelos es el mismo archivo que la etiqueta q4_K_M; cuando la versión por defecto es otra, la tabla da los dos tamaños (la de Mistral Nemo ocupa 7,1 GB y su q4_K_M, 7,5 GB). «Tarjeta mínima» significa que el modelo, más 1 GB de sobrecarga y un contexto de 4K a 8K, cabe entero en la GPU. ¿Quieres contexto largo? Sube un nivel.
| Modelo | Etiqueta de Ollama | Tamaño a 4 bits | Tamaño en Q8_0 | Tarjeta mínima (4 bits / Q8_0) |
|---|---|---|---|---|
| Mistral 7B v0.3 | mistral:7b | 4,4 GB | 7,7 GB | 8 GB / 12 GB |
| Qwen 2.5 7B | qwen2.5:7b | 4,7 GB | 8,1 GB | 8 GB / 12 GB |
| DeepSeek-R1 destilado 7B (Qwen 2.5) | deepseek-r1:7b | 4,7 GB | no comprobado | 8 GB |
| Llama 3.1 8B | llama3.1:8b | 4,9 GB | 8,5 GB | 8 GB / 12 GB |
| Qwen3 8B | qwen3:8b | 5,2 GB | 8,9 GB | 8 GB / 12 GB |
| DeepSeek-R1-0528 (Qwen3 8B) | deepseek-r1:8b | 5,2 GB | no comprobado | 8 GB |
| Qwen3.5 9B | qwen3.5:9b | 6,6 GB | 11 GB | 8 GB, solo con contexto corto / 16 GB |
| Mistral Nemo 12B | mistral-nemo:12b | 7,1 GB (q4_K_M: 7,5 GB) | 13 GB | 12 GB / 16 GB |
| Gemma 4 12B | gemma4:12b | 7,6 GB | 13 GB | 12 GB / 16 GB |
| Gemma 3 12B | gemma3:12b | 8,1 GB | 13 GB | 12 GB / 16 GB |
| Qwen 2.5 14B | qwen2.5:14b | 9,0 GB | 16 GB | 12 GB / 24 GB |
| DeepSeek-R1 destilado 14B (Qwen 2.5) | deepseek-r1:14b | 9,0 GB | no comprobado | 12 GB |
| Phi-4 14B | phi4:14b | 9,1 GB | 16 GB | 12 GB / 24 GB |
| Qwen3 14B | qwen3:14b | 9,3 GB | 16 GB | 12 GB / 24 GB |
| gpt-oss 20B (MoE) | gpt-oss:20b | 14 GB (MXFP4) | n/d | 16 GB |
| Mistral Small 3.2 24B | mistral-small3.2:24b | 15 GB | 26 GB | 24 GB / 32 GB |
| Gemma 3 27B | gemma3:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.5 27B | qwen3.5:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.6 27B | qwen3.6:27b | 18 GB (q4_K_M: 17 GB) | 30 GB | 24 GB / 48 GB |
| Gemma 4 26B (MoE, 3,8B activos) | gemma4:26b | 19 GB (q4_K_M: 18 GB) | 28 GB | 24 GB / 32 GB |
| Qwen3 30B-A3B (MoE) | qwen3:30b | 19 GB | no comprobado | 24 GB |
| Gemma 4 31B | gemma4:31b | 20 GB | 34 GB | 24 GB / 48 GB |
| Qwen3 32B | qwen3:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| Qwen 2.5 32B | qwen2.5:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| DeepSeek-R1 destilado 32B (Qwen 2.5) | deepseek-r1:32b | 20 GB | no comprobado | 24 GB |
| Qwen3.6 35B-A3B (MoE) | qwen3.6:35b | 23 GB (q4_K_M: 24 GB) | 39 GB | 32 GB / 48 GB |
| Qwen3.5 35B-A3B (MoE) | qwen3.5:35b | 24 GB | 39 GB | 32 GB / 48 GB |
| Llama 3.3 70B | llama3.3:70b | 43 GB | 75 GB | 48 GB, justo / 80 GB, justo |
| Qwen 2.5 72B | qwen2.5:72b | 47 GB | no comprobado | 80 GB |
| gpt-oss 120B (MoE) | gpt-oss:120b | 65 GB (MXFP4) | n/d | 80 GB |
Para el nivel he usado el tamaño de la etiqueta por defecto, porque es lo que descarga ollama pull con el nombre corto.
Los niveles de 24 GB y 32 GB tienen trampa. El contexto por defecto de Ollama salta de 4K a 32K a partir de 24 GiB, así que a un modelo de 20 GB en una RTX 4090 le puede tocar una caché de 32K que no cabe a su lado. Si ollama ps muestra una parte en CPU, pon un contexto más pequeño. Y no juzgues un modelo por el número de su nombre: el modelo para dispositivos de Gemma 4, gemma4:e4b (4.500 millones de parámetros efectivos), es una descarga de 9,6 GB, más grande que gemma4:12b con 7,6 GB. Mira el tamaño.
Los modelos de mezcla de expertos cambian un poco las cosas
gpt-oss, Gemma 4 26B y los modelos «A3B» de Qwen son modelos de mezcla de expertos (MoE). Para cada token solo se ejecutan unos pocos expertos: Gemma 4 26B tiene 25.200 millones de parámetros, pero solo 3.800 millones activos. La regla de memoria no cambia, porque todos los pesos tienen que estar cargados en algún sitio. Lo que cambia es la velocidad cuando no caben todos. Como cada token solo toca una fracción de los pesos, un modelo MoE que se desborda a la RAM del sistema se ralentiza mucho menos que uno denso del mismo tamaño. Las mediciones de la sección siguiente muestran lo grande que es esa diferencia.
Qué pasa cuando un modelo no cabe
Ollama no se niega a cargar un modelo demasiado grande. Pone en la GPU todas las capas que caben y ejecuta el resto en la CPU desde la RAM del sistema. ollama ps te dice en qué caso estás: 100% GPU significa que todo cabe, 100% CPU que no cabe nada, y una mezcla como 48%/52% CPU/GPU significa un reparto.
Un reparto sale caro, porque generar cada token obliga a leer todos los pesos activos, y la RAM del sistema es mucho más lenta que la VRAM. Una serie de pruebas con llama.cpp en una RTX 4080 de 16 GB, publicada por Rost en DEV Community en abril de 2026, lo muestra con claridad:
| Modelo (cuantización, tamaño de archivo) | Contexto | Carga GPU / CPU | Tokens por segundo |
|---|---|---|---|
| Qwen3.5 27B denso (IQ3_XXS, 11,5 GB) | 32K | 98 % / 100 % | 45,1 |
| Qwen3.5 27B denso | 64K | 45 % / 410 % | 22,7 |
| Qwen3.5 27B denso | 128K | 16 % / 625 % | 9,6 |
| Qwen3.5 35B-A3B MoE (IQ3_S, 13,6 GB) | 64K | 88 % / 115 % | 136,8 |
| Qwen3.5 122B-A10B MoE (IQ3_XXS, 44,7 GB) | 32K | 30 % / 480 % | 21,8 |
Una cifra de CPU alta con una de GPU baja significa que la mayor parte del trabajo ha pasado a la CPU; el autor interpreta los números igual.
El mismo modelo denso perdió la mitad de su velocidad al pasar de 32K a 64K de contexto, solo porque la caché KV más grande sacó capas de la GPU, y perdió casi un 80 % con 128K. El modelo MoE de 122B, un archivo de 44,7 GB en una tarjeta de 16 GB, siguió funcionando a unos 22 tokens por segundo porque por cada token solo hay 10.000 millones de parámetros activos. En modelos densos, «en parte en CPU» equivale a «varias veces más lento». En modelos MoE puede ser un intercambio aceptable.
Si te encuentras con un reparto, estas son las soluciones, de menos a más cara: baja el contexto, cuantiza la caché KV a q8_0, elige una cuantización más pequeña del mismo modelo (Q4_K_M en lugar de Q5), elige un modelo más pequeño o pasa a una tarjeta con más memoria.
Tarjetas de 32 GB y de centro de datos
La RTX 5090 tiene 32 GB. Eso te da un modelo de 32B a 4 bits con contexto largo, o los modelos MoE 35B-A3B de 23 a 24 GB con sitio para la caché. No te llega para 70B: llama3.3:70b ocupa 43 GB incluso a 4 bits.
Para 70B necesitas 48 GB o más. Una L40S tiene 48 GB, que alojan el archivo de 43 GB con poco margen para contexto. Una H100 SXM tiene 80 GB (la H100 NVL tiene 94 GB), donde caben Llama 3.3 70B a 4 bits con contexto largo, gpt-oss 120B (65 GB; la página de Ollama dice que cabe en una sola GPU de 80 GB) o Llama 3.3 70B en Q8_0 (75 GB) con contexto corto. Qwen3.5 122B, con 81 GB, ya se pasa de una sola tarjeta de 80 GB.
Alquilar en lugar de comprar: cómo revisar un anuncio de GPUFlow
Si alquilas una GPU en GPUFlow, el proveedor sirve los modelos desde su propia máquina (con Ollama, que el instalador de GPUFlow configura por defecto) y decide qué modelos están instalados. Tú no descargas modelos: recibes una clave API compatible con OpenAI para esa GPU, no una shell. El instalador de GPUFlow usa qwen2.5:7b por defecto, y las etiquetas que aparecen en el instalador y en la documentación son qwen2.5:0.5b, deepseek-r1:1.5b, qwen2.5:7b, deepseek-r1:7b, llama3.1:8b y qwen2.5:14b. Los proveedores pueden instalar otros.
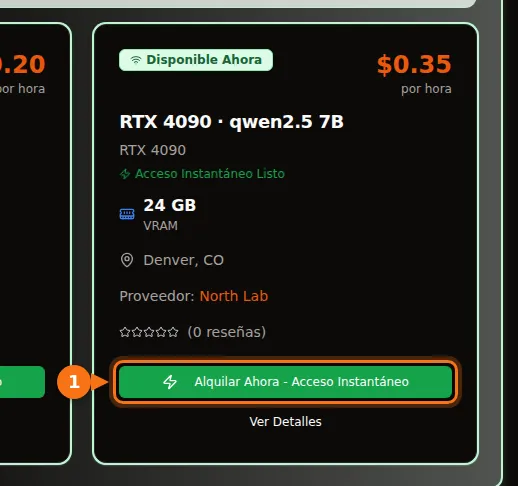
En el mercado, cada tarjeta muestra la GPU, su VRAM y el precio por hora, y la descripción del proveedor indica los modelos que sirve. La documentación de GPUFlow da una versión algo más prudente de la misma regla: un modelo de 7B funciona bien con 8 GB o más, y uno de 14B con 16 GB o más. Cuando tengas la clave, GET /v1/models devuelve un nombre de modelo; si la descripción menciona más modelos, también puedes usar esos nombres en el campo model.
Dos cosas que conviene saber. GPUFlow no fija ningún límite de contexto propio, así que se aplican los valores por defecto de Ollama en la máquina del proveedor, salvo que él los haya cambiado. Y un modelo que el proveedor no tiene instalado no está disponible para ti, así que elige el anuncio primero por el modelo que necesitas y después por la GPU. Conectar la clave a Open WebUI, Continue o LangChain funciona igual que con cualquier API de estilo OpenAI.
Artículos relacionados
- Cómo usar una clave API compatible con OpenAI en Open WebUI, Continue, LangChain y más
- ¿GPU por horas o API por token? Lo que cuesta de verdad ejecutar un modelo de 7B–8B
- Ollama vs vLLM vs TGI: benchmark de inferencia en una RTX 4090
- Comparativa de precios de alquiler de GPU en 2026
Fuentes
Todas revisadas en septiembre de 2026.
- Tamaños de descarga en la biblioteca de Ollama: mistral, qwen2.5, qwen3, qwen3.5, qwen3.6, llama3.1, llama3.3, deepseek-r1, página del modelo DeepSeek-R1 (bases de los destilados), gemma3, gemma4, página del modelo Gemma 4 (MoE y parámetros activos), mistral-nemo, mistral-small3.2, phi4, gpt-oss, página del modelo gpt-oss (MXFP4, memoria), índice de la biblioteca de Ollama
- Arquitectura de los modelos: ficha del modelo Qwen2.5-14B-Instruct, config.json de Qwen2.5-14B-Instruct, config.json de Qwen2.5-7B-Instruct, config.json de Llama-3.1-8B-Instruct (réplica de unsloth)
- Ajustes de contexto y memoria de Ollama: documentación de Ollama, Context length, FAQ de Ollama
- Tamaños de cuantización y bits por peso: README de quantize de llama.cpp
- Perplejidad por cuantización: README de perplexity de llama.cpp
- Estudio de benchmarks de cuantización: Uygar Kurt, Which Quantization Should I Use? (arXiv 2601.14277)
- Mediciones con descarga a CPU: Rost, benchmarks de LLM con 16 GB de VRAM en llama.cpp (DEV Community, abril de 2026)
- Memoria de las GPU: comparativa de la serie RTX 50 de NVIDIA, serie RTX 40, serie RTX 30, L40S, H100
- GPUFlow: Alquilar una GPU, paso a paso, guía rápida de la API, primeros pasos para proveedores