プラットフォームを理解したうえで選べば、それなりに安全です。ただ、「安全」の意味はプラットフォームによって違います。Vast.ai のようなコンテナ型のプラットフォームでは、借り手はあなたのマシンで自分のコードを実行し、その通信はあなたの IP アドレスから出ていきます。隔離によってファイルは守られますが、ネットワークや電気代までは守られません。GPUFlow のような API 専用の設計では、借り手ができるのはあなたがインストールしたモデルにチャットリクエストを送ることだけで、リスクの向きが逆になります。プロンプトはあなたのマシン上で読める状態になるので、借り手は秘密の情報を送るべきではありません。
この記事では、その両方の方向を見ていきます。他社についての記述は 2026 年 9 月に各プラットフォームのドキュメントで確認したもので、GPUFlow についての記述はすべてそのソースコードとドキュメントに基づいています。出典は最後にあります。
コンテナ型のプラットフォームで借り手ができること
GPU マーケットプレイスの多くはコンテナを貸し出します。借り手はイメージを選び、シェルを受け取り、好きなものを実行します。ホストであるあなたが考えるべきことは 5 つあります。
- 任意のコード。 借り手のコードは、コンテナや VM の中とはいえ、あなたのカーネル上で動きます。隔離は優秀ですが完璧ではありません。コンテナからの脱出はまれですが、カーネルやドライバーのアップデートで修正されるのはまさにこの種のバグであり、そのアップデートを入れるのはあなたです。
- あなたの IP アドレス。 コンテナからの外向きの通信は、あなたのインターネット回線を通って出ていきます。借り手がサイトをスクレイピングしたり、スパムを送ったり、インターネットをスキャンしたりすれば、あなたの IP アドレス宛ての苦情があなたの ISP に届きます。Vast.ai の規約では、ユーザーのコンテンツから生じた請求についてユーザーがプロバイダーを補償するとされています。第三者との紛争では役に立ちますが、ISP があなたに警告を送ってくるのを止めることはできません。
- ポートの開放。 Vast.ai のホスティングガイドには「ほとんどのジョブでは、クライアントがマシンに直接接続するためにポートの開放が必要です」とあり、ルーターでポートフォワーディングを設定することになります。
- ディスク。 借り手はイメージ、モデル、データセットをあなたのドライブにダウンロードします。Vast.ai はクライアントがボリュームを削除すると領域を解放しますが、レンタル中はその領域は借り手のものです。
- 電力、熱、ドライバー。 Vast.ai はホストに「レンタル期間中、GPU はほぼ最大の能力で使われるものと考えてください」と伝えています。何時間もボードの最大電力で動き、部屋は暑くなり、ファンは回り続けます。コンテナ型のプラットフォームでは専用のセットアップも必要です。Vast.ai のガイドには、Ubuntu のインストール、ディスクのパーティション分割、NVIDIA ドライバーのインストール、ルーターのポート開放が並んでいます。
Vast.ai、Salad、RunPod は借り手をどう隔離しているか
| Vast.ai | Salad | RunPod Community Cloud | |
|---|---|---|---|
| 借り手が受け取るもの | SSH または Jupyter で使うコンテナ(または VM) | 自分でデプロイしたコンテナ。SSH と Web ターミナルで入れる | Pod(コンテナ) |
| 隔離 | 非特権の Docker コンテナ | ハイパーバイザー上の Linux VM の中にコンテナ | 「厳格に分離された専用のコンテナ」 |
| 受信ポート | ほとんどのジョブで必要 | デフォルトでブロック | 記載なし |
| 新規ホスト | 受付中(Ubuntu) | 受付中(Windows 10/11) | 受付終了 |
- Vast.ai は「クライアントは非特権の Docker コンテナで隔離され、自分のデータにしかアクセスできません」としており、名前空間と cgroup を分け、ネットワーク、ファイルシステム、プロセスを隔離しています。一方で借り手には「プロバイダーのセキュリティには大きなばらつきがあります」と注意を促し、機密性の高い作業には認定データセンターで構成される Secure Cloud を勧めています。
- Salad は「ワークロードは Linux 仮想マシン上の OCI 互換コンテナで動作し、Windows やホスト上のほかのすべてのプロセスから隔離されます」としており、受信接続はデフォルトでブロックされます。ホストから借り手を守る仕組みもあり、ホストが「Linux 環境にアクセスしようとすると、環境を自動的に破棄し、そのマシンをブラックリストに登録します」。これとは別に、Salad には任意の帯域共有ジョブがあり、あなたの回線で「大手ストリーミングサービスの動画コンテンツを処理」します。サポートページには、データ使用量が増えること、そして「まれに、それらのストリーミングサービスで一時的な(通常 1〜2 日の)コンテンツ制限」が起きることがあると書かれています。
- RunPod は「Runpod は Community Cloud の新規ホストの受け付けを終了しました」としています。既存の環境については「各 Pod/ワーカーは専用のコンテナで動作します」とし、規約で「ホストがあなたの Pod/ワーカーのデータを調べることを禁止しています」。
3 社とも、借り手をあなたのシステムから隔離しています。ただし、正当に見える借り手の通信があなたの回線から出ていくのを止められるところはなく、止められるとうたっているところもありません。
GPUFlow の設計はどう違うか
GPUFlow が貸し出すのはマシンではなく、OpenAI 互換 API の向こうにある AI モデルです。これで借り手が触れられる範囲が変わります。コードが実際に何をしているかを見ていきます。
エージェント。 インストーラーは Go のバイナリ 1 つを /usr/local/bin/gpuflow-agent に置き、systemd のサービスとして実行します。Docker は使いません。サービスユニットでは DynamicUser=yes(一時的な非特権ユーザー)、NoNewPrivileges=yes(権限を昇格できない)、ProtectSystem=strict(システムは読み取り専用)、ProtectHome=yes(ホームフォルダーは見えない)、PrivateTmp=yes を指定しています。推論エンジンはデフォルトで Ollama で、Ollama 自身のインストーラーで独立したサービスとしてインストールされます(プロバイダーは代わりに、自分の OpenAI 互換サーバーをエージェントの接続先にすることもできます)。この強化設定はエージェントに対するもので、Ollama には適用されません。
ネットワーク。 エージェントは外向きの接続しか行いません。wss://ws.gpuflow.app への TLS 上の WebSocket と、登録と 15 秒ごとのハートビートのための gpuflow.app への HTTPS です。ポートは一切開かず、ルーターで何かをフォワードする必要もなく、借り手があなたの IP アドレスを知ることもありません。Ollama とは、Ollama のデフォルトのループバックアドレスである 127.0.0.1:11434 で通信します。
借り手が呼び出せるもの。 借り手は https://gpuflow.app/v1 用の API キーを受け取ります。GET /v1/models には GPUFlow 自身が応答し、あなたのマシンに転送されるリクエストは POST /v1/chat/completions だけです。エージェントにも独自の二重の鍵があります。プロキシするのは 4 つのパス(/v1/chat/completions、/v1/completions、/v1/embeddings、/v1/models)だけで、それ以外はすべて拒否します。モデルの pull、削除、作成ができる Ollama ネイティブの /api/* エンドポイントも拒否の対象です。エージェントが扱うメッセージの種類は推論リクエストの 1 つだけで、それ以外は無視します。
つまり、借り手にはシェルも SSH もファイルもなく、あなたのマシンへのネットワークアクセスもありません。70 GB のモデルをあなたのディスクにダウンロードすることも、あなたの回線を使ってインターネットに出ることもできません。できるのは、予約した時間だけ GPU を使い続けることと、model フィールドにあなたがインストールした任意のモデルを指定することです。
データの経路を 1 区間ずつ
借り手に読んでほしいのはこの部分です。チャットリクエストは 4 つのソフトウェアを通り、そのうち複数の地点で本文を読める状態になります。
- 借り手から gpuflow.app まで: HTTPS です。サイトは Cloudflare の背後にあります。
- GPUFlow の API からリレーまで: GPUFlow 側の内部接続です。API はキーを確認し、リクエストの本文をそのまま転送し、トークン数を記録します。リクエストや回答の本文は保存せず、プライバシーポリシーにもそう書かれています。
- リレーからプロバイダーのエージェントまで: エージェントが開いた TLS の WebSocket です。リレーが記録するのは各メッセージの種類で、中身ではありません。
- エージェントから Ollama まで: プロバイダーの PC 内のループバックアドレスでの平文の HTTP です。エージェントもリクエストの本文は記録しません。
モデルまでのエンドツーエンド暗号化はありませんし、通常の推論エンジンでは実現しようがありません。モデルはプロンプトを読まなければ答えられないからです。
プロバイダーから見えるもの
はっきり書きます。プロバイダーのコンピューターは、あなたのプロンプトと回答を平文で扱います。 Ollama はそこで動いており、プロバイダーはそのマシンの root 権限を持っています(インストーラーが root を必要とします)。その気になれば、ループバックの通信をキャプチャすることも、エンジンを差し替えることも、エージェントの接続先を別のサーバーに変えることもできます。
それを防いでいるのは契約です。GPUFlow の規約には、プロバイダーは「借り手のリクエストや回答を記録、閲覧、保持、共有してはならず、回答を改変してもならない」とあります。これはアカウントへの処分を伴うルールであって、技術的な防止策ではありません。プライバシーポリシーも借り手に同じことを伝えています。レンタル中、リクエストと回答はプロバイダーのコンピューターを通ります。
プロンプト以外では、プロバイダーにはあなたの GPUFlow のユーザー名が見え、レンタル開始時に通知(レンタル ID、出品、時間数)が届きます。借り手には、プロバイダーのマシンの統計は何も見えません。GPU の温度、VRAM、消費電力などのテレメトリーは所有者のダッシュボードにしか表示されません。
借り手にとっての実際的なルールはこうです。秘密の情報、認証情報、他人の個人データ、規制対象のデータ(医療、金融、顧客の機密情報)は、どのコミュニティ GPU にも送らないでください。 これは GPUFlow に限らず、誰かの自宅 PC 上のコンテナでも同じです。そこでもホストは同じ root 権限でメモリやディスクを調べられます。機密性の高い作業では、自分で管理するハードウェアでモデルを動かすか、コンプライアンス上必要な契約を結べるプロバイダーを使ってください。ポリシーの面は企業が公開 AI ツールを禁止する理由で、コンテナの面は公開 GPU ノードでデータセットを守る方法で扱っています。
GPUFlow でも残るリスク
API 専用にすれば攻撃対象領域は小さくなります。なくなるわけではありません。ないふりをするより、残っているものを挙げておきます。
- Ollama は信頼できない入力を解析します。 借り手のリクエストはすべて、最終的に JSON として Ollama に渡されます。侵入経路として最も可能性が高いのは Ollama のバグなので、アップデートしてください。エージェントの許可リストは借り手を Ollama のモデル管理エンドポイントから遠ざけますが、チャットの経路にあるバグまでは防げません。
- インストーラーは root で動きます。 gpuflow.app のスクリプトを
sudo bashにパイプして実行し、さらに Ollama のインストールスクリプトも実行されます。先に両方を読んでください。どんなホスティング用ソフトウェアでも、それが良い習慣です。 - 自動アップデートはありません。 エージェントは自分自身を更新しません。新しいバージョンにするにはインストーラーを再実行します。SHA256SUMS ファイルが公開されていれば、インストーラーはそれでバイナリを検証します。
- 負荷。 リクエスト数の上限はありません。借り手は予約した時間中ずっと GPU をフル稼働させることができ、あなたがインストールしたモデルなら一番大きいものでも使えます。
- 熱と電力。 ほかのプラットフォームと同じで、貸し出した時間は負荷がかかる時間です。
プロバイダー向けチェックリスト
- 貸しても困らないマシンを使う。 理想は専用のマシンです。少なくとも、どのプラットフォームであれ、貸し出すコンピューターに仕事のファイルやパスワード管理のデータを置かないでください。GPUFlow ではエージェントはすでにホームフォルダーが見えない一時的なシステムユーザーとして動いていますが、Ollama は別のサービスです。
- 電力を制限する。
sudo nvidia-smi -pl 280でボードの電力上限をワット単位で設定できます(root が必要で、値はカードの最小値と最大値の間でなければなりません)。Puget Systems の報告では、270〜280 W に制限した RTX 3090 は性能の約 95% を維持しています。起動のたびに systemd ユニットで制限をかけ直す方法も紹介されています。 - 先に電気代を計算する。 GPU が稼働している間に マイマシン で消費電力を確認し、キロワット数に 1 kWh あたりの電気料金を掛けます。ゲーミング GPU の貸し出しでいくら稼げるかで、一般的なカードと 5 か国についてこの計算をしています。
- 温度を見る。 リアルタイムの統計に、GPU、ホットスポット、メモリの温度とファンの回転数が表示されます。ケースに空気が通るようにしてください。
- システムを最新に保つ。 Linux、GPU ドライバー、Ollama のアップデートを入れてください。GPUFlow のインストーラーは GPU ドライバーを管理しません。再起動後は systemd がエージェントを再起動します。
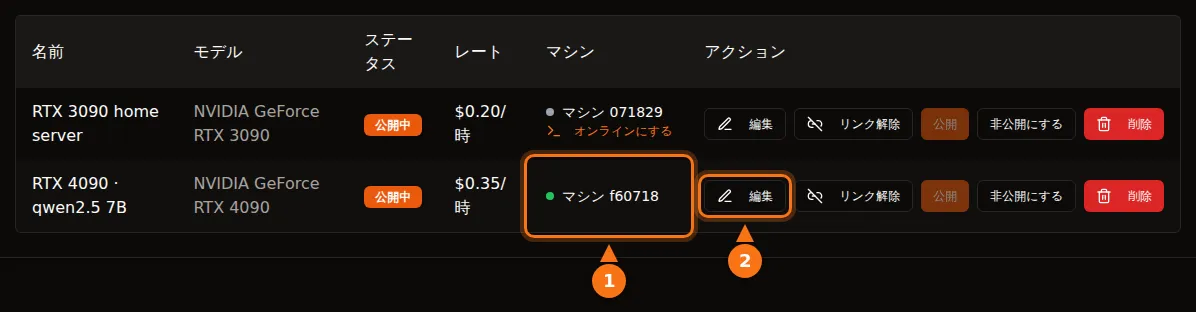
- 一時停止の方法を知っておく。 マイGPU で出品を非公開にするか、
sudo systemctl stop gpuflow-agentを実行します(startで元に戻ります)。レンタル中は、ダッシュボードから出品やマシンを変更することも、借り手のレンタルを終了させることもできません。レンタル中にエージェントを止めると、レンタルは 10 分後に終了し、報酬は最後のハートビートまでの分だけになります。 - アンインストールの方法を知っておく。 手順はトラブルシューティングのドキュメントにあります。Ollama は自分で削除するまで残ります。
コンテナ型のプラットフォームでは、項目が 2 つ増えます。ルーターのポートを本当に開放してよいかを決めること、そして ISP が苦情にどう対応するかを確認しておくことです。借り手の通信にはあなたの IP アドレスが付くからです。
借り手向けチェックリスト
- コミュニティ GPU はすべて他人のコンピューターだと考える。 API キー、パスワード、顧客の記録、医療や金融のデータをプロンプトに入れないでください。
- 不要な情報は削る。 送る前に、名前や口座番号をプレースホルダーに置き換えます。
- キーを守る。 GPUFlow では、キーはレンタルが終わると使えなくなります。漏れた場合は 新しいキー で古いキーをすぐに無効にでき、今すぐ終了 で課金を止めて未使用分の時間を返金できます。
- 回答が間違っている、または改変されている可能性を前提にする。 規約はプロバイダーによる回答の改変を禁じていますが、重要なものは確認してください。
- 機密性の高い作業には適した手段を使う。 自分でホストするか、必要な契約を結べるプロバイダーを使ってください。それ以外の用途にはアプリでキーを使う方法をどうぞ。
出典
すべて 2026 年 9 月に確認しました。
- GPUFlow:借り手が触れられる範囲、プロバイダーの始め方、価格と電気代、トラブルシューティングとアンインストール、API クイックスタート
- Vast.ai:ホスティングの概要、セキュリティ FAQ、Linux 仮想マシン、利用規約、プライベート AI モデルの実行
- Salad:セキュリティ、コンテナワークロードとあなたの PC、帯域共有、SSH とターミナル、ダウンロードとシステム要件
- RunPod:Pod の選び方、データセキュリティと法令遵守
- Ollama:FAQ(デフォルトのバインドアドレス)
- NVIDIA:nvidia-smi マニュアル
- Puget Systems:systemd と nvidia-smi による RTX 3090 の電力制限