1 時間 $0.40 の場合、90 秒のテストにかかる費用は、最低 60 秒の秒単位課金なら 1¢、分単位課金なら 1.3¢、1 時間単位の課金なら 40¢ です。短いジョブの話は、この 40 倍の差に尽きます。ジョブが数分を超えると、秒単位と分単位の差は 1 セント未満になり、請求額を左右するのはアイドル時間、セットアップ時間、ストレージになります。
以下では、各プラットフォームが公開しているルール、計算過程を示した例、実寸で描いたグラフ、そして GPUFlow の「先に確保して残りを返す」方式が実際の請求額にどうなるかを説明します。ルールと価格は 2026 年 9 月時点のもので、出典は最後にあります。
GPU の時間の数え方は 3 通り
どの GPU レンタルにも 1 時間あたりの料金があります。違うのは、使った時間を課金対象の時間に換算する方法で、その後にその料金を掛けます。
- 最低料金付きの秒単位。 秒数を数えます。合計が最低時間(通常は 60 秒)に満たなければ、最低時間分を請求します。コスト = max(60, 秒数) × 時間単価 / 3,600。
- 分単位。 分数を数えます。1 分に満たない端数の扱いはプラットフォームによって違い、切り上げるところもあれば、Azure のように切り捨てるところもあります。以下の例では、利用者にとって不利なほうの切り上げで計算します。コスト = 分数 × 時間単価 / 60。
- 1 時間単位。 始まった 1 時間はすべて丸々 1 時間です。61 分のジョブは 2 時間になります。コスト = ceil(秒数 / 3,600) × 時間単価。
最低料金は、多くの人が思う以上に効いてきます。最低 60 秒の秒単位課金と分単位課金は、1 分未満のジョブではまったく同じです。課金単位が変えるのはジョブの最後に残る端数だけなので、余分にかかるのはセッションごとに最大 1 単位分です。$0.40 の時間単位課金なら 1 セッションあたり 40¢ 弱、同じ料金の分単位課金なら 1 セッションあたり 0.7¢ 未満です(59 秒 × 40 / 3,600 = 0.66¢)。
各プラットフォームの方式
オンデマンドインスタンスについて公開されているルールを、2026 年 9 月に各社のドキュメントで確認したものです。
| プラットフォーム | 課金単位 | 最低時間 | ドキュメントの記載 |
|---|---|---|---|
| AWS EC2 オンデマンド | 秒単位 | 60 秒 | Linux、Windows、RHEL、Ubuntu Pro に適用。SUSE Linux Enterprise Server は 1 時間単位で課金。 |
| Google Cloud Compute Engine | 秒単位 | 1 分 | 「すべての vCPU、GPU、メモリ(GB)には最低 1 分の料金がかかります。」 |
| Azure Virtual Machines | 分単位 | 記載なし | 「完全な分の数」に課金。6 分 45 秒稼働した VM は 6 分として課金。 |
| Lambda(オンデマンドクラウド) | 分単位 | 記載なし | インスタンスがヘルスチェックに合格してから終了するまで、「1 分単位」で課金。 |
| RunPod Pods | 秒単位 | 記載なし | コンピューティングとストレージの両方を秒単位で課金。 |
| Vast.ai | 秒単位 | 記載なし | 稼働中のレンタルは毎秒課金。ストレージはオフライン時を除き、インスタンスが存在する間は毎秒課金。 |
| GPUFlow | 秒単位 | 60 秒 | 秒数は整数で数え、1 セント単位に切り上げ、確保された額が上限。 |
読むときの注意が 2 つあります。Azure のルールは実際には切り捨てで、FAQ には「余分な秒数には課金されません」とあります。Lambda のドキュメントは 1 分単位とだけ書いていて、端数を切り上げるか切り捨てるかは書かれていないので、どちらとも仮定していません。また「記載なし」は文字どおりの意味です。私が読んだドキュメントに最低時間の記載がないということで、最低時間がゼロと明記されているのとは違います。
上記のインスタンスタイプについて、GPU のコンピューティングを 1 時間単位に切り上げるプラットフォームはありません。それでも AWS の SUSE のように、1 時間単位の切り上げは細則に残っています。新しい環境で短いジョブを大量に回す前に、課金のページを確認してください。
1 時間 $0.40 で 5 つのジョブ
1 時間 $0.40 という 1 つの料金を、5 種類の長さのジョブに当てはめます。3,600 秒で 40¢、つまり 1 秒あたり 1/90 セントです。
90 秒のテスト。 秒単位:90 × 40 / 3,600 = 1.0¢。分単位:2 分 × 40 / 60 = 1.33¢。1 時間単位:40¢。1 時間単位の請求額は秒単位の 40 倍です。
7 分 30 秒。 秒単位:450 × 40 / 3,600 = 5.0¢。分単位:8 分 × 40 / 60 = 5.33¢。1 時間単位:40¢ で、8 倍です。
38 分 20 秒。 秒単位:2,300 × 40 / 3,600 = 25.56¢。分単位:39 分 × 40 / 60 = 26.0¢。1 時間単位:40¢ で、約 1.57 倍です。
61 分。 秒単位:3,660 × 40 / 3,600 = 40.67¢。分単位:61 × 40 / 60 = 40.67¢(ジョブがちょうど分の区切りで終わるので、両者は一致します)。1 時間単位:2 時間分で 80¢。1 分はみ出しただけで、1 時間単位の請求額はほぼ 2 倍になります。
| ジョブの長さ | 秒単位(最低 60 秒) | 分単位(切り上げ) | 1 時間単位 | GPUFlow の請求額 |
|---|---|---|---|---|
| 1 分 30 秒 | 1.00¢ | 1.33¢ | 40¢ | 1¢ |
| 7 分 30 秒 | 5.00¢ | 5.33¢ | 40¢ | 5¢ |
| 38 分 20 秒 | 25.56¢ | 26.00¢ | 40¢ | 26¢ |
| 61 分 | 40.67¢ | 40.67¢ | 80¢ | 41¢ |
| 2 分 30 秒のジョブ 20 回 | 33.33¢ | 40.00¢ | $8.00 | 40¢(レンタル 20 回) |
GPUFlow の列は、秒単位の結果をレンタルごとに 1 セント単位へ切り上げたもので、課金のコードが実際にしている計算です。最後の行については 2 つ後の節で説明します。
ジョブの長さとコスト(実寸)
1 つ目のグラフは 0〜150 分の範囲です。分単位の階段は 1 段の幅が 1 分、高さが 0.67¢ なので、この縮尺では秒単位の線とほぼ重なります。問題になる階段は 1 時間単位の線で、0 分、60 分、120 分で 40¢ ずつ跳ね上がります。
オレンジの階段と青い線の差が、1 時間単位の切り上げでジョブごとに余分にかかる金額です。各段の直後が最大で、ちょうどの時間ではゼロになります。
最初の 10 分を拡大すると、分単位課金の階段が見え、秒単位の線の始まりが平らなのは 60 秒の最低料金によるものだとわかります。1 時間単位の課金はこのグラフでは 40¢ の水平線になり、グラフの上端の 5 倍の高さです。
短いジョブを 1 日回す場合
短いジョブが 1 回で終わることはまずありません。1 日の作業で、それぞれ 2 分 30 秒のジョブを 20 回実行し、毎回新しいインスタンスを起動するとします。
- 秒単位: 20 × 150 秒 = 3,000 秒、3,000 × 40 / 3,600 = 33.33¢。
- 分単位(切り上げ): 各ジョブが 3 分なので合計 60 分、40¢。
- 1 時間単位: 各ジョブが 1 時間扱いなので、20 × 40¢ = $8.00。
GPU の作業は同じ 50 分なのに、1 時間単位の課金では 24 倍かかります。すぐに思いつく回避策は、1 台のマシンを 1 日中動かし続けることです。$0.40 で 8 時間なら $3.20 で、$8.00 よりは安いものの、ジョブの合間の時間にも支払うことになるので、秒単位の請求額の 9.6 倍です。
ただ、この例は毎回新しいインスタンスを起動する方式に甘い計算です。マシンが立ち上がった瞬間にジョブが始まる前提になっているからです。実際にはそうはなりません。たとえば、起動のたびに作業開始までに 3 分かかるとします。OS の起動、イメージの pull、モデルの読み込みです(実際の数字は環境によって違います)。すると秒単位課金でも 20 × 330 秒 = 6,600 秒、73.33¢ となり、実際の作業分 33.33¢ の 2 倍を超えます。課金単位は同じで、無駄がセットアップに移っただけです。
GPUFlow では、同じ 1 日の計算が少し違います。レンタルは 1 時間単位で予約し、課金は秒単位だからです。150 秒のレンタルを 20 回別々に開始すると、1 回あたり ceil(150 × 40 / 3,600) = ceil(1.67) = 2¢、合計 40¢ です。レンタルごとに 1 セント単位へ切り上げるため、この例ではジョブ 1 回あたり 0.33¢ が加算され、秒単位の合計より 6.67¢ 多くなります。ジョブを短時間にまとめて実行する場合、1 ユーザーあたり 1 時間に新規レンタルは 10 回までという制限に注意してください。1 つのレンタルを 1 日中開いておくと、経過時間の全体、8 時間 = $3.20 がかかります。GPUFlow は時間に課金し、トークン単位では課金しないからです。
課金単位より重要なこと
ジョブが 10 分程度を超えると、秒単位か分単位かは誤差の範囲です。次の 3 つはそうではありません。詳しくはGPU レンタルの本当のコストで扱っています。
アイドル時間
秒単位課金のプラットフォームはどこも、GPU が働いているかどうかに関係なく、稼働中のインスタンスに課金します。Lambda のドキュメントははっきりと、インスタンスは「実際に使われているかどうかにかかわらず」課金されると書いています。上の短いジョブの 1 日を見れば規模がわかります。作業は 50 分なのに、マシンを 8 時間起動しておけば $3.20 です。止め忘れたマシンは、どんな課金単位でも救えません。
セットアップ時間
起動、イメージの pull、モデルのダウンロードは、すべてメーターが回っている間に行われます。Lambda は、インスタンスがヘルスチェックに合格した時点、つまりあなたのコードがまだ何もしていないうちから課金を始めます。秒単位課金でもこのコストは消えず、起動のたびに支払うことになります。
停止中のストレージ
マシンを停止すれば、たいてい GPU の課金は止まります。ディスクの課金は続きます。RunPod は停止中の Pod のボリュームディスクに 1 GB あたり月 $0.20 を課金しており、これは稼働中の 2 倍です。ドキュメントには「停止中の Pod でもストレージ料金は発生し続けます」という注意があります。Vast.ai は「インスタンスを停止してもストレージ料金は避けられません」とはっきり書いています。停止した RunPod の Pod に 100 GB のボリュームを残しておくと、100 × $0.20 = 月 $20 で、$0.40 の GPU なら 50 時間分です。
ワークロードが自分のコードをマシンで動かすことではなくモデルの呼び出しなら、トークン単位の価格とも比べてください。どちらが安くなるかはGPU の時間貸しか、トークン課金の API かで検討しています。
GPUFlow の課金方法:先に確保し、残りを返す
GPUFlow が貸し出すのは推論です。受け取るのは、誰かの GPU で動くモデルのための OpenAI 互換 API キーで、マシンではありません。支払うべきシェル、ディスク、イメージがないので、前の節のストレージとセットアップは関係ありません。アイドル時間は関係します。レンタルは、使っていてもいなくても開始から終了まで課金されます。
手順は次のとおりです。
- 出品と時間数(整数、デフォルトでは 1〜168 時間)を選びます。プロバイダーの時間単価は整数のセントに換算されます。
- 開始時に、予約した全額がクレジットから確保されます。セント単位の料金 × 時間数です。これは全額で、最初に確保されます。
- レンタルが終了すると、請求額が 1 回だけ計算されます。使った秒数(整数、最低 60)× セント単位の料金 ÷ 3,600 を、1 セント単位に切り上げたもので、確保額を超えることはありません。
- 確保額の残りは、同じ処理の中で利用可能なクレジットに戻ります。
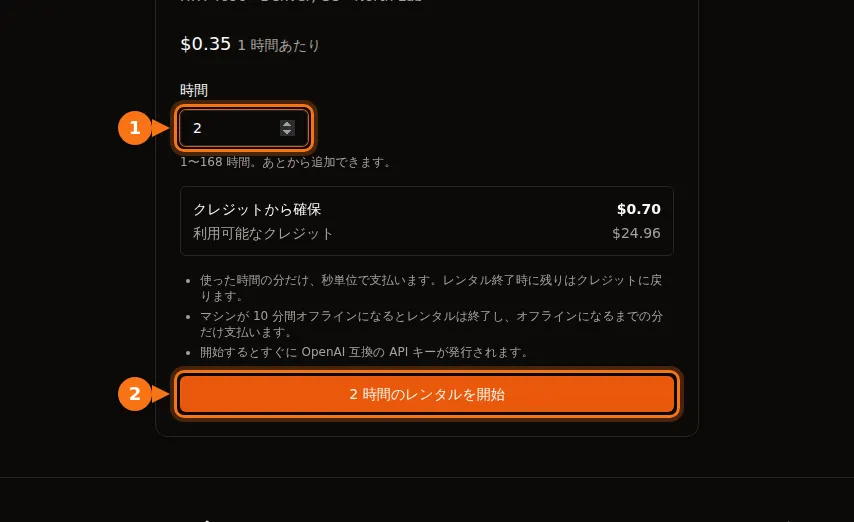
レンタル画面には、開始前に確保額が表示されます。$0.35 で 2 時間なら $0.70 が確保されます。
計算例
$0.40 で 3 時間予約します。確保額は 40¢ × 3 = 120¢($1.20)です。38 分 20 秒、つまり 2,300 秒後に 今すぐ終了 をクリックします。
- 請求額:ceil(2,300 × 40 / 3,600) = ceil(25.56) = 26¢。
- クレジットに戻る額:120 − 26 = 94¢。
- プラットフォーム手数料は請求額の 12% で、レンタルごとに 1 セント単位で四捨五入されます。round(26 × 0.12) = round(3.12) = 3¢。プロバイダーの受け取りは 26 − 3 = 23¢ で、この請求額に対しては 88% ちょうどではなく 88.5% です。請求額が大きくなれば、端数処理の影響は小さくなります。
自分で終了しなかった場合
予約した時間が切れると、1 分ごとに動くバックグラウンドジョブがレンタルを精算します。請求額は予約した終了時刻までで計算されるので、ジョブが動くまでの遅れの分を支払うことはありません。API キーは終了時刻に使えなくなります。時間を延ばしたいときは、時間を追加 でクレジットを追加で確保すれば、同じキーをそのまま使えます。
プロバイダーのマシンが応答しなくなった場合も、レンタルは終了します。プロバイダーのマシンのエージェントは 15 秒ごとにハートビートを送ります。10 分間届かないとレンタルは終了し、最後のハートビートまでの分だけが請求されます。1 時間 $0.40 で 3 時間予約し、25 分後にマシンが落ちた場合、ceil(1,500 × 40 / 3,600) = 17¢ で、120¢ の確保額のうち残りの 103¢ は戻ってきます。
1 時間単位の予約と 61 分のジョブには落とし穴があります。1 時間で予約し、切れる前に 時間を追加 をクリックし忘れると、キーは 60 分で止まり、終わっていないジョブに 40¢ を払うことになります。2 時間で予約(80¢ を確保)して 61 分で終了すれば、支払いは 41¢ で 39¢ が戻ります。迷ったら長めに予約して早めに終了してください。使わなかった時間には費用がかかりません。
ジョブの形に合わせて課金方式を選ぶ
- 10 分未満のジョブが大量にある: 秒単位か分単位の課金を選び、最低料金を確認します。1 時間単位に切り上げる方式はこの用途には向きません。
- 30〜90 分のジョブ: 1 時間単位の切り上げは避けます(61 分のジョブで 2 時間分を払うことになります)。秒単位か分単位かの差は、ジョブ 1 回あたり 1 セント未満です。
- 何時間も続く長い実行: 課金単位はほとんど影響しません。代わりにアイドル時間、セットアップ、ストレージを見てください。
- 1 日を通じて 1 つのモデルを断続的に呼び出す: 呼び出しのたびに新しいマシンを立ち上げると毎回セットアップ分を払い、1 台を起動し続けると合間の時間を払うことになります。モデルを読み込んだ状態で待機している推論レンタルはセットアップ分を避ける方法の 1 つですが、呼び出しの合間も時間は進むので、予約は実際に作業する時間に合わせてください。
試してみるなら、GPUFlow のマーケットプレイスに GPU ごとの時間単価が載っています。アカウントと支払いについてはGPU レンタルを始めるのに必要なものをご覧ください。
出典
- AWS「Amazon EC2 オンデマンド料金」(請求の詳細):aws.amazon.com/ec2/pricing/on-demand
- Google Cloud「VM インスタンスの料金」(課金モデル):cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure「Linux Virtual Machines の料金」(FAQ):azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda「Billing overview」:docs.lambda.ai/public-cloud/billing
- RunPod「Pod pricing」:docs.runpod.io/pods/pricing
- Vast.ai「Billing reference」:docs.vast.ai/documentation/reference/billing
- GPUFlow ドキュメント「クレジット、請求、返金」:docs.gpuflow.app/ja/renters/billing
すべて 2026 年 9 月に確認しました。