При $0,40 в час 90-секундный тестовый прогон стоит 1¢ при посекундной оплате с минимумом 60 секунд, 1,3¢ при поминутной и 40¢ при оплате полными часами. Для коротких задач вся история — в этой разнице в 40 раз. Как только задача длится дольше нескольких минут, посекундная и поминутная оплата расходятся меньше чем на цент, и итог счёта определяют простой, время на подготовку и хранение данных.
Ниже — опубликованные правила каждой платформы, примеры с расчётами, график в масштабе и то, как модель GPUFlow «сначала резерв, потом возврат» превращается в итоговое списание. Правила и цены актуальны на сентябрь 2026 года, источники — в конце.
Три способа считать время GPU
У любой аренды GPU есть цена за час. Разница в том, как использованное время превращается в оплачиваемое, прежде чем его умножат на эту цену.
- Посекундно с минимумом. Считаются секунды. Если в сумме их меньше минимума (обычно 60 секунд), оплачивается минимум. Стоимость = max(60, секунды) × цена за час / 3600.
- Поминутно. Считаются минуты. С неполной минутой платформы поступают по-разному: одни округляют вверх, Azure её отбрасывает. В примерах ниже я округляю вверх — это худший для вас вариант. Стоимость = минуты × цена за час / 60.
- Полными часами. Любой начатый час считается целым. Задача на 61 минуту — это два часа. Стоимость = ceil(секунды / 3600) × цена за час.
Минимум важнее, чем обычно думают. Посекундная оплата с минимумом 60 секунд и поминутная оплата для всего, что короче минуты, дают одно и то же. Шаг тарификации влияет только на остаток в конце задачи, поэтому он никогда не обойдётся вам дороже одного шага на сессию: чуть меньше 40¢ на сессию при почасовой оплате по $0,40 и меньше 0,7¢ на сессию при поминутной оплате по той же цене (59 секунд × 40 / 3600 = 0,66¢).
Как тарифицирует каждая платформа
Это опубликованные правила для инстансов по требованию, сверенные с документацией каждого поставщика в сентябре 2026 года.
| Платформа | Шаг | Минимум | Что сказано в документации |
|---|---|---|---|
| AWS EC2 On-Demand | Секунда | 60 секунд | Относится к Linux, Windows, RHEL и Ubuntu Pro. SUSE Linux Enterprise Server оплачивается полными часами. |
| Google Cloud Compute Engine | Секунда | 1 минута | «Все vCPU, GPU и ГБ памяти оплачиваются минимум за 1 минуту». |
| Azure Virtual Machines | Минута | Не указан | Оплачивается «число полных минут»; ВМ, проработавшая 6 мин 45 с, оплачивается как 6 минут. |
| Lambda (облако по требованию) | Минута | Не указан | Оплата «с шагом в одну минуту» с момента, когда инстанс проходит проверки работоспособности, и до его удаления. |
| RunPod Pods | Секунда | Не указан | И вычисления, и хранилище оплачиваются посекундно. |
| Vast.ai | Секунда | Не указан | Активная аренда оплачивается каждую секунду; хранилище — каждую секунду существования инстанса, если он не офлайн. |
| GPUFlow | Секунда | 60 секунд | Целые секунды, с округлением вверх до цента, не больше зарезервированной суммы. |
Два замечания к таблице. Azure на самом деле округляет вниз: в его FAQ сказано, что «лишние секунды не оплачиваются». В документации Lambda говорится о шаге в одну минуту, но не сказано, куда округляется неполная минута, поэтому я не стал предполагать ни то ни другое. А «не указан» означает ровно это: в прочитанной мной документации минимум не назван, что не то же самое, что задокументированный ноль.
Ни одна из этих платформ не округляет вычисления на GPU до полного часа для перечисленных типов инстансов. Но почасовое округление всё ещё встречается в мелком шрифте, как с SUSE на AWS, так что загляните на страницу тарификации, прежде чем запускать много коротких задач на новом месте.
Пять задач по $0,40 в час
Возьмём одну цену — $0,40 в час — и применим её к задачам пяти разных длин. Это 40¢ за 3600 секунд, или 1/90 цента в секунду.
90-секундный тест. Посекундно: 90 × 40 / 3600 = 1,0¢. Поминутно: 2 минуты × 40 / 60 = 1,33¢. Полными часами: 40¢. Почасовой счёт в 40 раз больше посекундного.
7 минут 30 секунд. Посекундно: 450 × 40 / 3600 = 5,0¢. Поминутно: 8 минут × 40 / 60 = 5,33¢. Полными часами: 40¢, в 8 раз больше.
38 минут 20 секунд. Посекундно: 2300 × 40 / 3600 = 25,56¢. Поминутно: 39 минут × 40 / 60 = 26,0¢. Полными часами: 40¢, примерно в 1,57 раза больше.
61 минута. Посекундно: 3660 × 40 / 3600 = 40,67¢. Поминутно: 61 × 40 / 60 = 40,67¢ (задача заканчивается ровно на целой минуте, поэтому результаты совпадают). Полными часами: два часа, 80¢. Одна лишняя минута почти удваивает почасовой счёт.
| Длительность задачи | Посекундно (мин. 60 с) | Поминутно (округление вверх) | Полными часами | Списание на GPUFlow |
|---|---|---|---|---|
| 1 мин 30 с | 1,00¢ | 1,33¢ | 40¢ | 1¢ |
| 7 мин 30 с | 5,00¢ | 5,33¢ | 40¢ | 5¢ |
| 38 мин 20 с | 25,56¢ | 26,00¢ | 40¢ | 26¢ |
| 61 мин | 40,67¢ | 40,67¢ | 80¢ | 41¢ |
| 20 задач по 2 мин 30 с | 33,33¢ | 40,00¢ | $8,00 | 40¢ (20 аренд) |
Столбец GPUFlow — это посекундный результат, округлённый вверх до целого цента для каждой аренды; именно так работает его код тарификации. Последняя строка разобрана двумя разделами ниже.
Стоимость в зависимости от длины задачи, в масштабе
Первый график охватывает от 0 до 150 минут. Поминутная лестница состоит из ступенек шириной 1 минута и высотой 0,67¢, так что в этом масштабе она лежит прямо на посекундной линии. Важна лестница почасовой оплаты: она прыгает на 40¢ на отметках 0, 60 и 120 минут.
Расстояние между оранжевой лестницей и синей линией — это то, во что обходится почасовое округление на одной задаче: больше всего сразу после каждой ступеньки и ноль на целых часах.
Если увеличить первые десять минут, у поминутной оплаты становятся видны ступеньки, а минимум 60 секунд виден как ровное начало посекундной линии. Почасовая оплата здесь была бы ровной линией на уровне 40¢ — в пять раз выше верхнего края графика.
День коротких задач
Короткие задачи редко приходят поодиночке. Допустим, за рабочий день вы запускаете 20 задач по 2 минуты 30 секунд и под каждую поднимаете новый инстанс.
- Посекундно: 20 × 150 с = 3000 с, и 3000 × 40 / 3600 = 33,33¢.
- Поминутно с округлением вверх: каждая задача — 3 минуты, итого 60 минут: 40¢.
- Полными часами: каждая задача — начатый час: 20 × 40¢ = $8,00.
Почасовая оплата обходится в 24 раза дороже за те же 50 минут работы GPU. Очевидный обходной путь — держать одну машину включённой весь день. Восемь часов по $0,40 — это $3,20: лучше, чем $8,00, но всё равно в 9,6 раза больше посекундного счёта, потому что теперь вы платите за паузы между задачами.
Впрочем, этот пример приукрашивает подход «новый инстанс на каждую задачу»: он предполагает, что работа начинается в ту же секунду, что и машина. Это не так. Для иллюстрации допустим, что каждый запуск тратит 3 минуты на загрузку системы, скачивание образа и загрузку модели, прежде чем начнётся работа (у вас цифра будет другой). Тогда посекундная оплата составит 20 × 330 с = 6600 с, то есть 73,33¢ — больше чем вдвое против 33,33¢ за саму работу. Шаг тарификации тот же; потери просто переехали в подготовку.
На GPUFlow тот же день выглядит немного иначе, потому что аренда бронируется целыми часами, а оплачивается посекундно. 20 отдельных аренд по 150 с стоят ceil(150 × 40 / 3600) = ceil(1,67) = 2¢ каждая, итого 40¢. Округление каждой аренды вверх до целого цента добавляет здесь 0,33¢ на задачу — отсюда лишние 6,67¢ сверх посекундной суммы. Если задачи идут плотно, учтите ограничение: не больше 10 новых аренд в час на пользователя. Одна аренда, открытая весь день, стоит полное календарное время, 8 часов = $3,20, потому что GPUFlow берёт плату за время, а не за токены.
Что важнее шага тарификации
Когда задачи длятся дольше примерно десяти минут, разница между посекундной и поминутной оплатой — погрешность округления. А вот следующие три вещи — нет. Подробнее о них — в статье сколько на самом деле стоит аренда GPU.
Простой
Каждая платформа с посекундной оплатой берёт деньги за запущенный инстанс, работает GPU или нет. В документации Lambda это сказано прямо: инстансы оплачиваются «независимо от того, используются ли они активно». День коротких задач выше показывает масштаб: 50 минут работы и $3,20, если машина простоит включённой 8 часов. Никакой шаг тарификации не спасёт от машины, которую вы забыли остановить.
Время на подготовку
Загрузка системы, скачивание образа и модели — всё это идёт под счётчик. Lambda начинает тарификацию, как только инстанс проходит проверки работоспособности, ещё до того, как ваш код что-то сделал. Посекундная оплата эту стоимость не убирает: вы платите её при каждом запуске.
Хранилище у остановленной машины
Остановка машины обычно прекращает оплату GPU. Диск продолжает тарифицироваться. RunPod берёт за том остановленного пода $0,20 за ГБ в месяц — вдвое больше, чем за работающий, — и в документации предупреждает, что «плата за хранилище продолжает начисляться за остановленные поды». Vast.ai прямо пишет, что «остановка инстанса не избавляет от платы за хранилище». Том на 100 ГБ, забытый на остановленном поде RunPod, стоит 100 × $0,20 = $20 в месяц — это 50 часов GPU по $0,40.
Если ваша нагрузка — это обращения к модели, а не собственный код на машине, сравните и с оплатой за токены: в статье почасовой GPU или оплата за токены разобрано, когда что дешевле.
Как тарифицирует GPUFlow: сначала резерв, потом возврат остатка
GPUFlow сдаёт в аренду инференс: вы получаете OpenAI-совместимый API-ключ к модели, работающей на чужом GPU, а не машину. Нет ни командной оболочки, ни диска, ни образа, за которые нужно платить, так что хранилище и подготовка из предыдущего раздела здесь не применимы. А вот простой — применим: аренда оплачивается от начала до конца, занят GPU или нет.
Порядок такой:
- Вы выбираете объявление и целое число часов (по умолчанию от 1 до 168). Почасовая цена провайдера переводится в целые центы.
- При старте из ваших кредитов резервируется вся забронированная сумма: ставка в центах × часы. Это полная сумма, и она списывается в резерв сразу.
- Когда аренда заканчивается, списание считается один раз: использованные целые секунды, минимум 60, умножаются на ставку в центах, делятся на 3600 и округляются вверх до цента — но не больше суммы резерва.
- Всё, что осталось от резерва, на том же шаге возвращается в доступные кредиты.
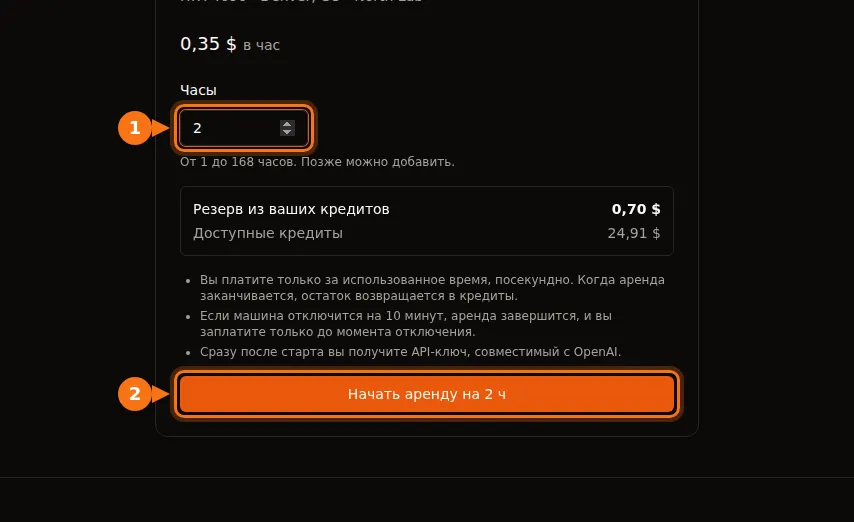
Форма аренды показывает резерв ещё до старта: 2 часа по $0,35 — это $0,70 в резерве.
Пример расчёта
Бронируем 3 часа по $0,40. Резерв — 40¢ × 3 = 120¢ ($1,20). Через 38 минут 20 секунд, то есть через 2300 секунд, вы нажимаете Завершить сейчас.
- Списание: ceil(2300 × 40 / 3600) = ceil(25,56) = 26¢.
- Возврат в кредиты: 120 − 26 = 94¢.
- Комиссия платформы — 12% от списания, округлённые до ближайшего цента для каждой аренды: round(26 × 0,12) = round(3,12) = 3¢. Провайдер получает 26 − 3 = 23¢, то есть 88,5% от этого списания, а не ровно 88%. На больших суммах округление значит меньше.
Когда аренда заканчивается без вас
Если забронированные часы истекли, аренду закрывает фоновая задача, которая запускается каждую минуту. Списание считается до забронированного времени окончания, так что за задержку до запуска задачи вы не платите. API-ключ перестаёт работать в момент окончания. Если нужно больше времени, кнопка Добавить часы резервирует дополнительные кредиты и сохраняет тот же ключ.
Аренда завершается и тогда, когда машина провайдера замолкает. Агент на машине провайдера отправляет heartbeat-сигнал каждые 15 секунд. Если его нет 10 минут, аренда завершается и оплачивается только до последнего heartbeat-сигнала. При $0,40 в час машина, которая отвалилась через 25 минут после начала трёхчасовой брони, обойдётся в ceil(1500 × 40 / 3600) = 17¢, а остальные 103¢ из резерва в 120¢ вернутся.
С бронированием целыми часами и 61-минутной задачей есть подвох. Если забронировать 1 час и забыть нажать Добавить часы, пока время не истекло, ключ перестанет работать на 60-й минуте, и вы заплатите 40¢ за незаконченную задачу. Забронируйте 2 часа (80¢ в резерве), завершите на 61-й минуте — и заплатите 41¢, а 39¢ вернутся. Если сомневаетесь, бронируйте с запасом и завершайте раньше: неиспользованное время ничего не стоит.
Как выбрать модель оплаты под свои задачи
- Много задач короче 10 минут: посекундная или поминутная оплата, и проверьте минимум. Всё, что округляет до часа, здесь не подходит.
- Задачи на 30–90 минут: избегайте округления до полного часа (задача на 61 минуту оплачивается как два часа). Разница между посекундной и поминутной оплатой — меньше цента на задачу.
- Длинные прогоны на много часов: шаг тарификации почти незаметен. Смотрите на простой, подготовку и хранилище.
- Эпизодические обращения к одной модели в течение дня: новая машина на каждую серию запросов каждый раз платит за подготовку, а одна постоянно работающая машина — за паузы. Аренда инференса, при которой модель уже загружена и готова, избавляет от затрат на подготовку, но счётчик продолжает идти между запросами, так что бронируйте время под реальный график работы.
Если хотите попробовать, в каталоге GPUFlow указаны почасовые цены для каждого GPU, а в статье что нужно для аренды GPU разобраны аккаунт и оплата.
Источники
- AWS, цены Amazon EC2 On-Demand (детали тарификации): aws.amazon.com/ec2/pricing/on-demand
- Google Cloud, цены на инстансы ВМ (модель тарификации): cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure, цены на виртуальные машины Linux (FAQ): azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda, обзор тарификации: docs.lambda.ai/public-cloud/billing
- RunPod, цены на поды: docs.runpod.io/pods/pricing
- Vast.ai, справка по тарификации: docs.vast.ai/documentation/reference/billing
- Документация GPUFlow, кредиты, оплата и возвраты: docs.gpuflow.app/ru/renters/billing
Всё проверено в сентябре 2026 года.