À 0,40 $ de l’heure, un test de 90 secondes coûte 1 ¢ si vous êtes facturé à la seconde avec un minimum de 60 secondes, 1,3 ¢ si vous êtes facturé à la minute, et 40 ¢ si vous êtes facturé à l’heure entamée. Cet écart de 1 à 40 résume tout pour les tâches courtes. Dès qu’une tâche dure plus de quelques minutes, facturation à la seconde et à la minute diffèrent de moins d’un cent, et la facture se joue sur le temps d’inactivité, le temps de mise en route et le stockage.
Au programme : les règles publiées par chaque plateforme, des exemples chiffrés avec le calcul, un graphique à l’échelle, et la façon dont le modèle de GPUFlow, réservation puis remboursement, se traduit en montant facturé. Règles et prix à jour en septembre 2026 ; les sources sont en fin d’article.
Trois façons de compter le temps GPU
Toute location de GPU a un prix à l’heure. La différence tient à la façon dont le temps utilisé est converti en temps facturable avant d’être multiplié par ce prix.
- À la seconde, avec un minimum. On compte les secondes. Si le total est inférieur au minimum (généralement 60 secondes), on facture le minimum. Coût = max(60, secondes) × tarif horaire / 3 600.
- À la minute. On compte les minutes. Les plateformes ne traitent pas toutes la minute entamée de la même façon : certaines arrondissent au-dessus, Azure l’ignore. Dans les exemples ci-dessous, j’arrondis au-dessus, ce qui est le cas le moins favorable pour vous. Coût = minutes × tarif horaire / 60.
- À l’heure entamée. Toute heure commencée est une heure entière. Une tâche de 61 minutes compte pour deux heures. Coût = ceil(secondes / 3 600) × tarif horaire.
Le minimum compte plus qu’on ne le pense. La facturation à la seconde avec un minimum de 60 secondes et la facturation à la minute sont identiques pour tout ce qui dure moins d’une minute. L’incrément ne change que la fraction restante en fin de tâche : il ne peut donc jamais vous coûter plus d’un incrément par session. Soit un peu moins de 40 ¢ par session avec la facturation à l’heure à 0,40 $, et moins de 0,7 ¢ par session avec la facturation à la minute au même tarif (59 secondes × 40 / 3 600 = 0,66 ¢).
Ce qu’utilise chaque plateforme
Voici les règles publiées pour les instances à la demande, vérifiées dans la documentation de chaque fournisseur en septembre 2026.
| Plateforme | Incrément | Minimum | Ce que dit la documentation |
|---|---|---|---|
| AWS EC2 On-Demand | À la seconde | 60 secondes | S’applique à Linux, Windows, RHEL et Ubuntu Pro. SUSE Linux Enterprise Server est facturé à l’heure entamée. |
| Google Cloud Compute Engine | À la seconde | 1 minute | « Tous les vCPU, GPU et Go de mémoire sont facturés au minimum 1 minute. » |
| Azure Virtual Machines | À la minute | Non précisé | Facture « le nombre de minutes complètes » ; une VM qui tourne 6 min 45 s est facturée 6 minutes. |
| Lambda (cloud à la demande) | À la minute | Non précisé | Facture « par incréments d’une minute », du moment où l’instance passe les contrôles de santé jusqu’à ce que vous la supprimiez. |
| RunPod Pods | À la seconde | Non précisé | Calcul et stockage facturés tous deux à la seconde. |
| Vast.ai | À la seconde | Non précisé | Location active facturée à chaque seconde ; stockage facturé à chaque seconde d’existence de l’instance, sauf si elle est hors ligne. |
| GPUFlow | À la seconde | 60 secondes | Secondes entières, arrondies au cent, plafonnées au montant réservé. |
Deux remarques pour lire ce tableau. La règle d’Azure arrondit en réalité vers le bas : sa FAQ précise que vous n’êtes « pas facturé pour les secondes supplémentaires ». La documentation de Lambda parle d’incréments d’une minute sans dire dans quel sens est arrondie une minute entamée : je n’ai donc rien supposé. Et « non précisé » veut dire exactement cela : la documentation que j’ai lue ne mentionne aucun minimum, ce qui n’est pas la même chose qu’un minimum nul documenté.
Aucune de ces plateformes n’arrondit le calcul GPU à l’heure entamée pour les types d’instances ci-dessus. L’arrondi à l’heure apparaît pourtant encore dans les petites lignes, comme pour SUSE sur AWS : lisez la page de facturation avant de lancer beaucoup de tâches courtes sur une nouvelle plateforme.
Cinq tâches à 0,40 $ de l’heure
Prenons un seul tarif, 0,40 $ de l’heure, appliqué à cinq durées de tâche. Cela fait 40 ¢ pour 3 600 secondes, soit 1/90 de cent par seconde.
Un test de 90 secondes. À la seconde : 90 × 40 / 3 600 = 1,0 ¢. À la minute : 2 minutes × 40 / 60 = 1,33 ¢. À l’heure entamée : 40 ¢. La facture à l’heure vaut 40 fois la facture à la seconde.
7 minutes 30 secondes. À la seconde : 450 × 40 / 3 600 = 5,0 ¢. À la minute : 8 minutes × 40 / 60 = 5,33 ¢. À l’heure entamée : 40 ¢, soit 8 fois plus.
38 minutes 20 secondes. À la seconde : 2 300 × 40 / 3 600 = 25,56 ¢. À la minute : 39 minutes × 40 / 60 = 26,0 ¢. À l’heure entamée : 40 ¢, environ 1,57 fois plus.
61 minutes. À la seconde : 3 660 × 40 / 3 600 = 40,67 ¢. À la minute : 61 × 40 / 60 = 40,67 ¢ (la tâche se termine sur une minute pile, les deux coïncident donc). À l’heure entamée : deux heures, 80 ¢. Une minute de plus double presque la facture à l’heure.
| Durée de la tâche | À la seconde (min. 60 s) | À la minute (arrondi au-dessus) | Heure entamée | Montant facturé par GPUFlow |
|---|---|---|---|---|
| 1 min 30 s | 1,00 ¢ | 1,33 ¢ | 40 ¢ | 1 ¢ |
| 7 min 30 s | 5,00 ¢ | 5,33 ¢ | 40 ¢ | 5 ¢ |
| 38 min 20 s | 25,56 ¢ | 26,00 ¢ | 40 ¢ | 26 ¢ |
| 61 min | 40,67 ¢ | 40,67 ¢ | 80 ¢ | 41 ¢ |
| 20 tâches de 2 min 30 s | 33,33 ¢ | 40,00 ¢ | 8,00 $ | 40 ¢ (20 locations) |
La colonne GPUFlow reprend le résultat à la seconde, arrondi au cent entier supérieur pour chaque location, ce que fait son code de facturation. La dernière ligne est expliquée deux sections plus bas.
Le coût selon la durée de la tâche, à l’échelle
Le premier graphique va de 0 à 150 minutes. L’escalier de la facturation à la minute a des marches de 1 minute de large et de 0,67 ¢ de haut : à cette échelle, il se confond avec la ligne de la facturation à la seconde. L’escalier qui compte est celui de l’heure entamée : il fait un saut de 40 ¢ à 0, 60 et 120 minutes.
L’écart entre l’escalier orange et la ligne bleue, c’est ce que coûte l’arrondi à l’heure pour chaque tâche : maximal juste après chaque marche, nul sur les heures pile.
En zoomant sur les dix premières minutes, les marches de la facturation à la minute apparaissent, et le minimum de 60 secondes se voit dans le départ à plat de la ligne à la seconde. La facturation à l’heure entamée serait une ligne plate à 40 ¢, cinq fois plus haut que le sommet de ce graphique.
Une journée de tâches courtes
Les tâches courtes viennent rarement seules. Disons que vous lancez 20 tâches dans une journée de travail, de 2 minutes 30 secondes chacune, avec une nouvelle instance pour chacune.
- À la seconde : 20 × 150 s = 3 000 s, et 3 000 × 40 / 3 600 = 33,33 ¢.
- À la minute, arrondi au-dessus : chaque tâche compte 3 minutes, soit 60 minutes au total : 40 ¢.
- À l’heure entamée : chaque tâche est une heure commencée : 20 × 40 ¢ = 8,00 $.
La facturation à l’heure coûte 24 fois plus pour les mêmes 50 minutes de travail GPU. Le réflexe évident est de garder une seule machine allumée toute la journée. Huit heures à 0,40 $ font 3,20 $, mieux que 8,00 $ mais encore 9,6 fois la facture à la seconde, parce que vous payez désormais les trous entre les tâches.
Cet exemple flatte pourtant l’approche « une instance neuve par tâche », car il suppose qu’une tâche démarre au moment même où la machine démarre. Ce n’est pas le cas. À titre d’illustration, supposons que chaque lancement passe 3 minutes à démarrer, télécharger une image et charger un modèle avant que le travail commence (votre chiffre sera différent). La facturation à la seconde compte alors 20 × 330 s = 6 600 s, soit 73,33 ¢, plus du double des 33,33 ¢ de travail réel. L’incrément n’a pas changé ; le gaspillage s’est déplacé dans la mise en route.
Sur GPUFlow, la même journée se présente un peu différemment, car une location se réserve en heures entières et se facture à la seconde. Lancer 20 locations séparées de 150 s coûte ceil(150 × 40 / 3 600) = ceil(1,67) = 2 ¢ chacune, soit 40 ¢ au total. L’arrondi de chaque location au cent entier ajoute ici 0,33 ¢ par tâche, d’où les 6,67 ¢ de plus que le total à la seconde. Si les tâches sont rapprochées, notez la limite de 10 nouvelles locations par heure et par utilisateur. Garder une seule location ouverte toute la journée coûte tout le temps écoulé, 8 heures = 3,20 $, parce que GPUFlow facture le temps et ne facture pas au token.
Ce qui compte plus que l’incrément
Dès que les tâches dépassent une dizaine de minutes, la différence entre facturation à la seconde et à la minute n’est qu’une erreur d’arrondi. Les trois points suivants, eux, pèsent vraiment. Ils sont détaillés dans ce que le prix à l’heure ne dit pas.
Le temps d’inactivité
Toutes les plateformes facturées à la seconde facturent une instance allumée, que le GPU travaille ou non. La documentation de Lambda le dit sans détour : les instances sont facturées « qu’elles soient activement utilisées ou non ». La journée de tâches courtes ci-dessus donne l’ordre de grandeur : 50 minutes de travail, 3,20 $ si la machine reste allumée 8 heures. Aucun incrément de facturation ne corrige une machine qu’on a oublié d’arrêter.
Le temps de mise en route
Démarrage, téléchargement d’image et de modèle : tout cela se fait compteur tournant. Lambda commence à facturer dès que l’instance passe les contrôles de santé, avant que votre code ait fait quoi que ce soit. La facturation à la seconde ne supprime pas ce coût ; vous le payez à chaque lancement.
Le stockage d’une machine arrêtée
Arrêter une machine arrête généralement la facturation du GPU. Le disque, lui, continue d’être facturé. RunPod facture le volume disque d’un pod arrêté 0,20 $ par Go et par mois, le double du tarif en fonctionnement, et sa documentation prévient que « les frais de stockage continuent de courir sur les pods arrêtés ». Vast.ai dit clairement qu’« arrêter une instance n’évite pas les frais de stockage ». Un volume de 100 Go laissé sur un pod RunPod arrêté coûte 100 × 0,20 $ = 20 $ par mois, soit 50 heures de GPU à 0,40 $.
Si votre usage consiste à appeler un modèle plutôt qu’à faire tourner votre propre code sur une machine, comparez aussi avec la tarification au token : GPU à l’heure ou API au token ? montre quand chacun revient moins cher.
Comment GPUFlow facture : réservation d’abord, remboursement du reste
GPUFlow loue de l’inférence : vous obtenez une clé API compatible OpenAI pour un modèle qui tourne sur le GPU de quelqu’un d’autre, pas une machine. Il n’y a ni shell, ni disque, ni image à payer : le stockage et la mise en route de la section précédente ne s’appliquent pas. Le temps d’inactivité, si : la location est facturée du début à la fin, que le GPU travaille ou non.
Les étapes :
- Vous choisissez une annonce et un nombre entier d’heures (de 1 à 168 par défaut). Le prix horaire du fournisseur est converti en cents entiers.
- Au démarrage, le montant total réservé est bloqué sur vos crédits : tarif en cents × heures. C’est le montant complet, prélevé d’avance.
- À la fin de la location, le montant facturé est calculé une seule fois : secondes entières utilisées, 60 au minimum, multipliées par le tarif en cents, divisées par 3 600, arrondies au cent supérieur, et jamais plus que le montant réservé.
- Ce qui reste du montant réservé revient dans vos crédits disponibles au cours de la même étape.
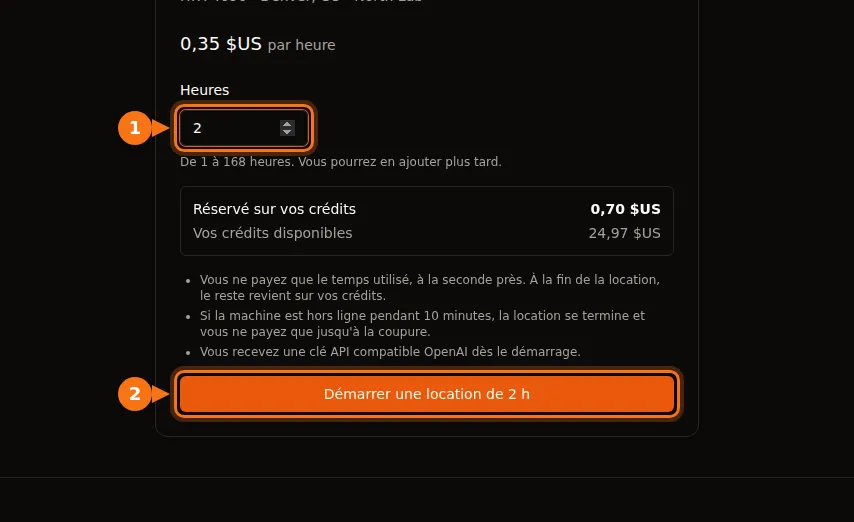
Le formulaire de location affiche le montant réservé avant le démarrage : 2 heures à 0,35 $ réservent 0,70 $.
Un exemple chiffré
Réservez 3 heures à 0,40 $. Le montant réservé est de 40 ¢ × 3 = 120 ¢ (1,20 $). Vous cliquez sur Terminer maintenant au bout de 38 minutes 20 secondes, soit 2 300 secondes.
- Montant facturé : ceil(2 300 × 40 / 3 600) = ceil(25,56) = 26 ¢.
- Rendu à vos crédits : 120 − 26 = 94 ¢.
- Les frais de la plateforme représentent 12 % du montant facturé, arrondis au cent le plus proche pour chaque location : round(26 × 0,12) = round(3,12) = 3 ¢. Le fournisseur reçoit 26 − 3 = 23 ¢, soit 88,5 % de ce montant et non exactement 88 %. Sur des montants plus élevés, l’arrondi pèse moins.
Quand une location se termine sans vous
Quand les heures réservées sont écoulées, une tâche de fond qui tourne chaque minute clôture la location. Le montant est calculé jusqu’à l’heure de fin réservée : vous ne payez pas le délai avant que la tâche passe. La clé API cesse de fonctionner à l’heure de fin. Si vous voulez plus de temps, Ajouter des heures réserve d’autres crédits et conserve la même clé.
Si la machine du fournisseur ne donne plus signe de vie, la location se termine aussi. L’agent installé sur la machine du fournisseur envoie un signal de présence (heartbeat) toutes les 15 secondes. Après 10 minutes sans signal, la location est terminée et facturée seulement jusqu’au dernier signal. À 0,40 $ de l’heure, une machine qui décroche au bout de 25 minutes sur une réservation de 3 heures coûte ceil(1 500 × 40 / 3 600) = 17 ¢, et les 103 ¢ restants des 120 ¢ réservés reviennent dans vos crédits.
La réservation en heures entières a un piège avec la tâche de 61 minutes. Si vous réservez 1 heure et oubliez de cliquer sur Ajouter des heures avant la fin, la clé s’arrête à 60 minutes et vous payez 40 ¢ pour une tâche inachevée. Réservez 2 heures (80 ¢ réservés) et terminez à 61 minutes : vous payez 41 ¢ et récupérez 39 ¢. Dans le doute, réservez large et terminez tôt ; le temps non utilisé ne coûte rien.
Choisir un mode de facturation selon le profil des tâches
- Beaucoup de tâches de moins de 10 minutes : facturation à la seconde ou à la minute, en vérifiant le minimum. Tout ce qui arrondit à l’heure est le mauvais outil ici.
- Tâches de 30 à 90 minutes : évitez l’arrondi à l’heure entamée (une tâche de 61 minutes paie deux heures). Entre la seconde et la minute, l’écart vaut moins d’un cent par tâche.
- Longues sessions de plusieurs heures : l’incrément compte à peine. Regardez plutôt le temps d’inactivité, la mise en route et le stockage.
- Appels par rafales à un même modèle tout au long de la journée : une machine neuve par rafale paie la mise en route à chaque fois, et une machine gardée allumée paie les trous. Une location d’inférence qui garde un modèle prêt est une façon d’éviter la mise en route, mais le compteur tourne entre les appels : calez la réservation sur vos vraies heures de travail.
Pour essayer, la place de marché GPUFlow affiche les prix à l’heure de chaque GPU, et ce qu’il vous faut pour louer un GPU couvre le compte et le paiement.
Sources
- AWS, tarification Amazon EC2 On-Demand (détails de facturation) : aws.amazon.com/ec2/pricing/on-demand
- Google Cloud, tarification des instances de VM (modèle de facturation) : cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure, tarification des machines virtuelles Linux (FAQ) : azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda, présentation de la facturation : docs.lambda.ai/public-cloud/billing
- RunPod, tarification des pods : docs.runpod.io/pods/pricing
- Vast.ai, référence sur la facturation : docs.vast.ai/documentation/reference/billing
- Documentation GPUFlow, crédits, facturation et remboursements : docs.gpuflow.app/fr/renters/billing
Toutes vérifiées en septembre 2026.