Ollama जिस 4-bit quantization को डिफ़ॉल्ट रूप से देता है, उस पर 7B या 8B मॉडल के लिए 8 GB का कार्ड चाहिए, 12B से 14B मॉडल के लिए 12 GB (लंबे prompt चाहिए तो 16 GB), और 27B से 32B मॉडल के लिए 24 GB। 4-bit पर 70B मॉडल 43 GB का है, यानी 48 GB या उससे ज़्यादा VRAM।
विस्तार से समझना इसलिए ज़रूरी है कि डाउनलोड साइज़ पूरा हिसाब नहीं है। आप जो context इस्तेमाल करते हैं, वह भी मेमोरी लेता है, और जो मॉडल देखने में फ़िट लगता है, वह आधा CPU पर पहुँचकर कई गुना धीमा हो सकता है। नीचे वह फ़ॉर्मूला है जो मैं इस्तेमाल करता हूँ, quantization के लेबल का मतलब, और मौजूदा open मॉडल की एक टेबल, जिसमें Ollama library से लिए गए असली डाउनलोड साइज़ हैं। साइज़ और specs सितंबर 2026 में जाँचे गए; स्रोत आख़िर में हैं।
VRAM के हिसाब से छोटा जवाब
| VRAM | आम कार्ड | GPU पर पूरी तरह क्या चलता है (4-bit) |
|---|---|---|
| 8 GB | RTX 4060, RTX 5060, RTX 3070 | 7B से 8B मॉडल: Llama 3.1 8B, Qwen3 8B, Mistral 7B |
| 12 GB | RTX 3060 12 GB, RTX 4070, RTX 5070 | छोटे context पर 12B से 14B मॉडल; Q8_0 पर 7B से 8B |
| 16 GB | RTX 4060 Ti 16 GB, RTX 4080, RTX 5080 | लंबे context के साथ 14B, gpt-oss 20B |
| 24 GB | RTX 3090, RTX 4090 | 24B से 32B: Mistral Small 3.2, Gemma 3 27B, Qwen3 32B |
| 32 GB | RTX 5090 | लंबे context के साथ 32B, 35B mixture-of-experts मॉडल |
| 48 से 80 GB | L40S (48 GB), H100 (80 GB) | 4-bit पर 70B, 80 GB पर gpt-oss 120B |
कार्ड की मेमोरी NVIDIA के spec पेजों से ली गई है। कुछ कार्ड दो वर्ज़न में आते हैं: RTX 3060 12 GB और 8 GB में मिलता है, और RTX 4060 Ti और RTX 5060 Ti 16 GB और 8 GB में। ख़रीदने या किराये पर लेने से पहले देख लें कि कौन-सा वर्ज़न है।
किसी मॉडल के लिए VRAM का अंदाज़ा कैसे लगाएँ
जब मॉडल आपको जवाब दे रहा होता है, तब GPU मेमोरी में तीन चीज़ें होती हैं:
- weights। parameters × bits per weight ÷ 8 = bytes।
- KV cache। मॉडल बातचीत के हर token के keys और values रखता है, ताकि उन्हें दोबारा न निकालना पड़े। प्रति token यह 2 × layers × KV heads × head size × 2 bytes है (डिफ़ॉल्ट 16-bit cache पर)। इसे context की लंबाई से गुणा करें।
- overhead। CUDA context, scratch buffers और ख़ुद runtime। मैं इसके लिए लगभग 1 GB रखता हूँ। यह engine और सेटिंग के हिसाब से बदलता है, इसलिए इसे अंदाज़ा मानें, spec नहीं।
layers और heads की संख्या Hugging Face पर हर मॉडल की config.json में मिलती है।
उदाहरण: 16 GB कार्ड पर Qwen 2.5 14B
Qwen 2.5 14B में 14.7 अरब parameters, 48 layers, 8 KV heads और 128 का head size है (5,120 hidden size ÷ 40 attention heads)।
- Q4_K_M पर weights: llama.cpp के मुताबिक़ Q4_K_M लगभग 4.89 bits per weight है। 14.7 अरब × 4.89 ÷ 8 = 8.99 GB। Ollama का
qwen2.5:14bडाउनलोड 9.0 GB है, यानी हिसाब असली फ़ाइल से मेल खाता है। - प्रति token KV cache: 2 × 48 × 8 × 128 × 2 bytes = 1,96,608 bytes, लगभग 0.2 MB।
- पूरे context का KV cache: 4,096 token = 0.8 GB। 16,384 token = 3.2 GB। 32,768 token = 6.4 GB।
- कुल: 4K context पर 9.0 + 0.8 + 1 = 10.8 GB। 16K पर 9.0 + 3.2 + 1 = 13.2 GB। 32K पर 9.0 + 6.4 + 1 = 16.4 GB, जो 16 GB कार्ड में नहीं आता।
इससे दो बातें निकलती हैं। पहली, आप जो context सेट करते हैं, वह मॉडल जितनी ही मेमोरी ले सकता है। Llama 3.1 8B (32 layers, 8 KV heads, head size 128) को प्रति token 1,31,072 bytes KV cache चाहिए, इसलिए इसके पूरे 128K context के लिए अकेले cache में 17.2 GB लगेंगे, जो इसके 4.9 GB डाउनलोड का लगभग साढ़े तीन गुना है। दूसरी, प्रति token KV cache का साइज़ मॉडल-दर-मॉडल बहुत बदलता है। Qwen 2.5 7B में सिर्फ़ 4 KV heads और 28 layers हैं, इसलिए इसे प्रति token 57,344 bytes चाहिए, Llama 3.1 8B के आधे से भी कम। मान लेने से पहले config देख लें।
Ollama डिफ़ॉल्ट रूप से context के साथ क्या करता है
Ollama उपलब्ध VRAM देखकर डिफ़ॉल्ट context चुनता है: 24 GiB से कम पर 4K token, 24 से 48 GiB पर 32K token, और 48 GiB या उससे ज़्यादा पर 256K। इसे OLLAMA_CONTEXT_LENGTH environment variable से बदला जा सकता है, और ollama ps अपने CONTEXT कॉलम में असल में दिया गया context दिखाता है। दो और सेटिंग हिसाब बदल देती हैं:
OLLAMA_NUM_PARALLEL(डिफ़ॉल्ट 1): Ollama के docs कहते हैं कि parallel अनुरोध context का साइज़ उतने गुना बढ़ा देते हैं जितने parallel अनुरोध हों। चार parallel slot मतलब चार गुना KV cache।OLLAMA_KV_CACHE_TYPE:q8_0डिफ़ॉल्टf16cache की लगभग आधी मेमोरी लेता है,q4_0लगभग एक-चौथाई। इसके लिए flash attention चालू होना चाहिए।
quantization के स्तरों का मतलब
open मॉडल 16-bit precision में प्रकाशित होते हैं (नीचे लिंक की गई configs में bfloat16 लिखा है): प्रति parameter दो bytes। quantization weights को कम bits में रखता है। GGUF फ़ाइलों में, जो format Ollama और llama.cpp इस्तेमाल करते हैं, लेबल का मोटा मतलब यह है:
| लेबल | bits per weight | Llama 3.1 8B का साइज़ | Llama 3 8B पर perplexity (कम बेहतर) |
|---|---|---|---|
| F16 | 16.0 | 14.96 GiB | 6.233 |
| Q8_0 | 8.50 | 7.95 GiB | 6.234 |
| Q6_K | 6.56 | 6.14 GiB | 6.253 |
| Q5_K_M | 5.70 | 5.33 GiB | 6.289 |
| Q4_K_M | 4.89 | 4.58 GiB | 6.407 |
| Q3_K_M | 4.00 | 3.74 GiB | 6.888 |
| Q2_K_S / Q2_K | 2.97 | 2.78 GiB | 9.752 (Q2_K) |
bits per weight और साइज़ llama.cpp के quantize README (Llama 3.1 8B) से हैं। perplexity llama.cpp के perplexity README (Llama 3 8B, Wikitext) से है। “K” वाले type llama.cpp के k-quants हैं, जो मॉडल के अलग-अलग हिस्सों में अलग precision रखते हैं; _S, _M और _L छोटे, मध्यम और बड़े मिश्रण हैं।
आँकड़े क्या कहते हैं: Q8_0 व्यवहार में बिना नुकसान के है (perplexity 6.234, जबकि F16 पर 6.233)। Q4_K_M से perplexity लगभग 3% बढ़ती है, और उसी README के मुताबिक़ इसका सबसे संभावित अगला token 91.9% बार full-precision मॉडल से मेल खाता है। Q3 साफ़ तौर पर ख़राब है, और Q2 पर मॉडल बिखर जाता है।
perplexity और उपयोगिता एक चीज़ नहीं हैं, इसलिए Uygar Kurt की जनवरी 2026 की स्टडी काम की है। उन्होंने Llama 3.1 8B Instruct को हर llama.cpp स्तर पर reasoning, knowledge, instruction-following और truthfulness benchmarks से गुज़ारा। बिना वेटेज वाला औसत F16 पर 69.47, Q8_0 पर 69.41, Q5_K_M पर 69.36 और Q4_K_M पर 69.15 रहा। यही वजह है कि लगभग सभी, Ollama समेत, डिफ़ॉल्ट रूप से Q4_K_M रखते हैं: फ़ाइल FP16 के एक-तिहाई से भी छोटी होती है, और नुकसान ऐसा जो शायद ही कभी दिखे। Ollama पर सादा tag यही 4-bit build है: qwen3:8b और qwen3:8b-q4_K_M दोनों 5.2 GB के हैं, phi4:14b और phi4:14b-q4_K_M दोनों 9.1 GB के।
मेरा नियम: Q8_0 पर छोटा मॉडल लेने से पहले Q4_K_M पर सबसे बड़ा फ़िट होने वाला मॉडल लें। Q4 पर 14B आमतौर पर Q8 पर 7B से बेहतर रहता है, और फ़ाइलें लगभग एक जितनी बड़ी होती हैं। Q5 या Q8 पर तब जाएँ जब मेमोरी बच रही हो और काम छोटी गलतियों के प्रति संवेदनशील हो, जैसे code या सटीक extraction।
नए Ollama tags में qat (Gemma के quantization-aware trained build), nvfp4 और mxfp8 जैसे format भी हैं। gpt-oss ख़ुद OpenAI की तरफ़ से MXFP4 में आता है, mixture-of-experts weights के लिए 4.25 bits per parameter पर।
कौन-से मॉडल फ़िट होते हैं: साइज़ और VRAM स्तर
टेबल में सितंबर 2026 तक Ollama library के मौजूदा open मॉडल और उनके डाउनलोड साइज़ हैं। “4-bit” कॉलम डिफ़ॉल्ट tag का साइज़ है। ज़्यादातर मॉडल में यह वही फ़ाइल है जो q4_K_M tag की है; जहाँ डिफ़ॉल्ट कोई अलग build है, वहाँ टेबल दोनों साइज़ देती है (Mistral Nemo का डिफ़ॉल्ट 7.1 GB है, उसका q4_K_M 7.5 GB)। “सबसे छोटा कार्ड” का मतलब है कि मॉडल, लगभग 1 GB overhead और 4K से 8K context पूरी तरह GPU पर आ जाते हैं। लंबा context चाहिए? एक स्तर ऊपर जाएँ।
| मॉडल | Ollama tag | 4-bit साइज़ | Q8_0 साइज़ | सबसे छोटा कार्ड (4-bit / Q8_0) |
|---|---|---|---|---|
| Mistral 7B v0.3 | mistral:7b | 4.4 GB | 7.7 GB | 8 GB / 12 GB |
| Qwen 2.5 7B | qwen2.5:7b | 4.7 GB | 8.1 GB | 8 GB / 12 GB |
| DeepSeek-R1 distill 7B (Qwen 2.5) | deepseek-r1:7b | 4.7 GB | जाँचा नहीं | 8 GB |
| Llama 3.1 8B | llama3.1:8b | 4.9 GB | 8.5 GB | 8 GB / 12 GB |
| Qwen3 8B | qwen3:8b | 5.2 GB | 8.9 GB | 8 GB / 12 GB |
| DeepSeek-R1-0528 (Qwen3 8B) | deepseek-r1:8b | 5.2 GB | जाँचा नहीं | 8 GB |
| Qwen3.5 9B | qwen3.5:9b | 6.6 GB | 11 GB | 8 GB, सिर्फ़ छोटा context / 16 GB |
| Mistral Nemo 12B | mistral-nemo:12b | 7.1 GB (q4_K_M: 7.5 GB) | 13 GB | 12 GB / 16 GB |
| Gemma 4 12B | gemma4:12b | 7.6 GB | 13 GB | 12 GB / 16 GB |
| Gemma 3 12B | gemma3:12b | 8.1 GB | 13 GB | 12 GB / 16 GB |
| Qwen 2.5 14B | qwen2.5:14b | 9.0 GB | 16 GB | 12 GB / 24 GB |
| DeepSeek-R1 distill 14B (Qwen 2.5) | deepseek-r1:14b | 9.0 GB | जाँचा नहीं | 12 GB |
| Phi-4 14B | phi4:14b | 9.1 GB | 16 GB | 12 GB / 24 GB |
| Qwen3 14B | qwen3:14b | 9.3 GB | 16 GB | 12 GB / 24 GB |
| gpt-oss 20B (MoE) | gpt-oss:20b | 14 GB (MXFP4) | लागू नहीं | 16 GB |
| Mistral Small 3.2 24B | mistral-small3.2:24b | 15 GB | 26 GB | 24 GB / 32 GB |
| Gemma 3 27B | gemma3:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.5 27B | qwen3.5:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.6 27B | qwen3.6:27b | 18 GB (q4_K_M: 17 GB) | 30 GB | 24 GB / 48 GB |
| Gemma 4 26B (MoE, 3.8B active) | gemma4:26b | 19 GB (q4_K_M: 18 GB) | 28 GB | 24 GB / 32 GB |
| Qwen3 30B-A3B (MoE) | qwen3:30b | 19 GB | जाँचा नहीं | 24 GB |
| Gemma 4 31B | gemma4:31b | 20 GB | 34 GB | 24 GB / 48 GB |
| Qwen3 32B | qwen3:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| Qwen 2.5 32B | qwen2.5:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| DeepSeek-R1 distill 32B (Qwen 2.5) | deepseek-r1:32b | 20 GB | जाँचा नहीं | 24 GB |
| Qwen3.6 35B-A3B (MoE) | qwen3.6:35b | 23 GB (q4_K_M: 24 GB) | 39 GB | 32 GB / 48 GB |
| Qwen3.5 35B-A3B (MoE) | qwen3.5:35b | 24 GB | 39 GB | 32 GB / 48 GB |
| Llama 3.3 70B | llama3.3:70b | 43 GB | 75 GB | 48 GB, मुश्किल से / 80 GB, मुश्किल से |
| Qwen 2.5 72B | qwen2.5:72b | 47 GB | जाँचा नहीं | 80 GB |
| gpt-oss 120B (MoE) | gpt-oss:120b | 65 GB (MXFP4) | लागू नहीं | 80 GB |
स्तर तय करने के लिए मैंने डिफ़ॉल्ट tag का साइज़ लिया है, क्योंकि छोटे नाम से ollama pull करने पर वही डाउनलोड होता है।
24 GB और 32 GB कार्ड वाले स्तरों में एक पेच है। 24 GiB पर Ollama का डिफ़ॉल्ट context 4K से सीधे 32K हो जाता है, इसलिए RTX 4090 पर 20 GB के मॉडल को 32K का cache मिल सकता है, जो उसके साथ मेमोरी में नहीं आता। अगर ollama ps में CPU का हिस्सा दिखे, तो context छोटा करें। और मॉडल को उसके नाम में लिखे नंबर से न आँकें: Gemma 4 का edge मॉडल gemma4:e4b (4.5B effective parameters) 9.6 GB का डाउनलोड है, जो 7.6 GB वाले gemma4:12b से बड़ा है। साइज़ देखें।
mixture-of-experts मॉडल से तस्वीर थोड़ी बदलती है
gpt-oss, Gemma 4 26B और Qwen के “A3B” मॉडल mixture-of-experts (MoE) मॉडल हैं। हर token के लिए सिर्फ़ कुछ experts चलते हैं: Gemma 4 26B में 25.2B parameters हैं, पर active सिर्फ़ 3.8B। मेमोरी का नियम नहीं बदलता, क्योंकि सारे weights कहीं न कहीं load करने ही पड़ते हैं। बदलती है स्पीड, जब सब कुछ VRAM में न आए। हर token weights के सिर्फ़ एक हिस्से को छूता है, इसलिए system RAM में फैलने वाला MoE मॉडल उसी साइज़ के dense मॉडल से कहीं कम धीमा होता है। अगले हिस्से के माप दिखाते हैं कि यह फ़र्क़ कितना बड़ा है।
जब मॉडल फ़िट नहीं होता तो क्या होता है
Ollama बहुत बड़े मॉडल को load करने से मना नहीं करता। जितनी layers GPU पर आ सकती हैं उतनी वहाँ रखता है, और बाक़ी को system RAM से CPU पर चलाता है। ollama ps बताता है कि आप किस स्थिति में हैं: 100% GPU मतलब सब कुछ फ़िट है, 100% CPU मतलब कुछ भी नहीं, और 48%/52% CPU/GPU जैसा मिश्रण मतलब बँटवारा।
बँटवारा महँगा पड़ता है, क्योंकि हर token बनाने के लिए हर active weight पढ़ना पड़ता है, और system RAM VRAM से बहुत धीमी है। अप्रैल 2026 में DEV Community पर Rost के प्रकाशित llama.cpp रन, 16 GB RTX 4080 पर, इसे साफ़ दिखाते हैं:
| मॉडल (quant, फ़ाइल साइज़) | context | GPU / CPU load | token प्रति सेकंड |
|---|---|---|---|
| Qwen3.5 27B dense (IQ3_XXS, 11.5 GB) | 32K | 98% / 100% | 45.1 |
| Qwen3.5 27B dense | 64K | 45% / 410% | 22.7 |
| Qwen3.5 27B dense | 128K | 16% / 625% | 9.6 |
| Qwen3.5 35B-A3B MoE (IQ3_S, 13.6 GB) | 64K | 88% / 115% | 136.8 |
| Qwen3.5 122B-A10B MoE (IQ3_XXS, 44.7 GB) | 32K | 30% / 480% | 21.8 |
CPU का आँकड़ा ऊँचा और GPU का नीचा हो, तो इसका मतलब है कि ज़्यादातर काम CPU पर चला गया; लेखक भी आँकड़ों को इसी तरह पढ़ते हैं।
वही dense मॉडल 32K से 64K context पर जाते ही अपनी आधी स्पीड खो बैठा, सिर्फ़ इसलिए कि बड़े KV cache ने layers को GPU से बाहर धकेल दिया, और 128K पर लगभग 80% स्पीड चली गई। 122B MoE मॉडल, 16 GB कार्ड पर 44.7 GB की फ़ाइल, फिर भी लगभग 22 token प्रति सेकंड पर चला, क्योंकि प्रति token सिर्फ़ 10B parameters active होते हैं। dense मॉडल के लिए “कुछ हिस्सा CPU पर” को “कई गुना धीमा” समझें। MoE मॉडल के लिए यह एक ठीक-ठाक सौदा हो सकता है।
अगर बँटवारा हो रहा है, तो लागत के क्रम में उपाय ये हैं: context कम करें, KV cache को q8_0 पर quantize करें, उसी मॉडल का छोटा quantization लें (Q5 की जगह Q4_K_M), छोटा मॉडल लें, या ज़्यादा मेमोरी वाले कार्ड पर जाएँ।
32 GB और datacenter कार्ड
RTX 5090 में 32 GB है। इसमें 4-bit पर 32B मॉडल लंबे context के साथ चल जाता है, या 23 से 24 GB वाले 35B-A3B MoE मॉडल cache की जगह के साथ। 70B तक यह नहीं पहुँचता: llama3.3:70b 4-bit पर भी 43 GB का है।
70B के लिए 48 GB या उससे ज़्यादा चाहिए। L40S में 48 GB है, जिसमें 43 GB की फ़ाइल आ जाती है, पर context के लिए थोड़ी ही जगह बचती है। H100 SXM में 80 GB है (H100 NVL में 94 GB), जिसमें 4-bit पर Llama 3.3 70B लंबे context के साथ, gpt-oss 120B (65 GB, और Ollama का पेज कहता है कि यह एक 80 GB GPU पर आ जाता है), या छोटे context के साथ Q8_0 पर Llama 3.3 70B (75 GB) आ जाता है। 81 GB वाला Qwen3.5 122B एक 80 GB कार्ड की सीमा पहले ही पार कर चुका है।
ख़रीदने की जगह किराये पर: GPUFlow लिस्टिंग कैसे जाँचें
अगर आप GPUFlow पर GPU किराये पर लेते हैं, तो provider अपनी मशीन से मॉडल चलाता है (Ollama के साथ, जिसे GPUFlow installer डिफ़ॉल्ट रूप से सेट करता है) और वही तय करता है कि कौन-से मॉडल इंस्टॉल हों। मॉडल आप ख़ुद pull नहीं करते: आपको उस GPU के लिए OpenAI-compatible API key मिलती है, shell नहीं। GPUFlow installer डिफ़ॉल्ट रूप से qwen2.5:7b इस्तेमाल करता है, और installer और docs में जिन tags का ज़िक्र है वे हैं qwen2.5:0.5b, deepseek-r1:1.5b, qwen2.5:7b, deepseek-r1:7b, llama3.1:8b और qwen2.5:14b। provider दूसरे मॉडल भी इंस्टॉल कर सकते हैं।
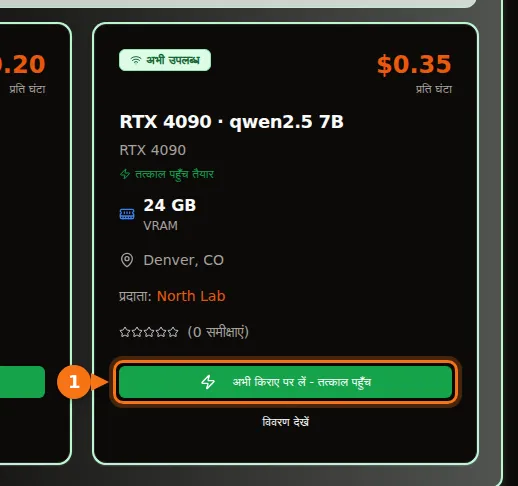
मार्केटप्लेस में हर कार्ड GPU, उसका VRAM और प्रति घंटा कीमत दिखाता है, और provider के विवरण में वे मॉडल लिखे होते हैं जो वह चलाता है। GPUFlow के docs यही नियम थोड़ा ज़्यादा सावधानी से बताते हैं: 7B मॉडल 8 GB या उससे ज़्यादा पर अच्छा चलता है, 14B मॉडल 16 GB या उससे ज़्यादा पर। key मिलने के बाद GET /v1/models एक मॉडल का नाम लौटाता है; अगर विवरण में और मॉडल लिखे हैं, तो आप वे नाम भी model field में इस्तेमाल कर सकते हैं।
दो बातें जान लें। GPUFlow अपनी तरफ़ से कोई context सीमा तय नहीं करता, इसलिए provider की मशीन पर Ollama के डिफ़ॉल्ट लागू होते हैं, जब तक provider ने उन्हें बदला न हो। और जो मॉडल provider ने इंस्टॉल नहीं किया, वह आपको नहीं मिलेगा, इसलिए लिस्टिंग पहले अपने ज़रूरी मॉडल के हिसाब से चुनें और GPU के हिसाब से बाद में। Open WebUI, Continue या LangChain से key जोड़ना किसी भी OpenAI-style API की तरह ही होता है।
संबंधित लेख
- Open WebUI, Continue, LangChain और दूसरे टूल में OpenAI-compatible API key कैसे इस्तेमाल करें
- घंटे के हिसाब से GPU या प्रति token API? 7B–8B मॉडल चलाने की असली लागत
- Ollama vs vLLM vs TGI: RTX 4090 inference benchmark
- GPU किराये की कीमतों की तुलना 2026
स्रोत
सभी की जाँच सितंबर 2026 में की गई।
- Ollama library के डाउनलोड साइज़: mistral, qwen2.5, qwen3, qwen3.5, qwen3.6, llama3.1, llama3.3, deepseek-r1, DeepSeek-R1 मॉडल पेज (distill के base मॉडल), gemma3, gemma4, Gemma 4 मॉडल पेज (MoE और active parameters), mistral-nemo, mistral-small3.2, phi4, gpt-oss, gpt-oss मॉडल पेज (MXFP4, मेमोरी), Ollama library की सूची
- मॉडल की बनावट: Qwen2.5-14B-Instruct model card, Qwen2.5-14B-Instruct config.json, Qwen2.5-7B-Instruct config.json, Llama-3.1-8B-Instruct config.json (unsloth mirror)
- Ollama की context और मेमोरी सेटिंग: Ollama docs, Context length, Ollama FAQ
- quantization साइज़ और bits per weight: llama.cpp quantize README
- quantization perplexity: llama.cpp perplexity README
- quantization benchmark स्टडी: Uygar Kurt, Which Quantization Should I Use? (arXiv 2601.14277)
- CPU offload के माप: Rost, llama.cpp के साथ 16 GB VRAM LLM benchmarks (DEV Community, अप्रैल 2026)
- GPU मेमोरी साइज़: NVIDIA RTX 50 series तुलना, RTX 40 series, RTX 30 series, L40S, H100
- GPUFlow: GPU किराये पर लें, क़दम-दर-क़दम, API quickstart, provider के लिए शुरुआत