Bei 0,40 $ pro Stunde kostet ein Testlauf von 90 Sekunden 1 Cent, wenn sekundengenau mit 60 Sekunden Mindestdauer abgerechnet wird, 1,3 Cent bei minutengenauer Abrechnung und 40 Cent bei Abrechnung nach vollen Stunden. Dieser Faktor 40 ist bei kurzen Jobs die ganze Geschichte. Sobald ein Job länger als ein paar Minuten läuft, liegen sekunden- und minutengenaue Abrechnung weniger als einen Cent auseinander, und über die Rechnung entscheiden Leerlauf, Einrichtungszeit und Speicher.
Unten finden Sie die veröffentlichten Regeln jeder Plattform, Rechenbeispiele mit der Rechnung, ein maßstabsgetreues Diagramm und wie bei GPUFlow aus Reservierung und Erstattung eine Abbuchung wird. Regeln und Preise sind auf dem Stand von September 2026; die Quellen stehen am Ende.
Drei Arten, GPU-Zeit zu zählen
Jede GPU-Miete hat einen Stundenpreis. Der Unterschied liegt darin, wie die genutzte Zeit in abrechenbare Zeit umgerechnet wird, bevor sie mit diesem Preis multipliziert wird.
- Pro Sekunde mit Mindestdauer. Die Sekunden werden gezählt. Liegt die Summe unter der Mindestdauer (meist 60 Sekunden), wird die Mindestdauer berechnet. Kosten = max(60, Sekunden) × Stundenpreis / 3.600.
- Pro Minute. Die Minuten werden gezählt. Was mit einer angebrochenen Minute passiert, handhaben die Plattformen unterschiedlich: Manche runden auf, Azure lässt sie weg. In den Beispielen unten runde ich auf, das ist für Sie der ungünstigere Fall. Kosten = Minuten × Stundenpreis / 60.
- Volle Stunde. Jede angefangene Stunde zählt ganz. Ein Job von 61 Minuten kostet zwei Stunden. Kosten = ceil(Sekunden / 3.600) × Stundenpreis.
Die Mindestdauer ist wichtiger, als man denkt. Sekundengenaue Abrechnung mit 60 Sekunden Mindestdauer und minutengenaue Abrechnung sind für alles unter einer Minute identisch. Der Takt ändert nur den Rest am Ende eines Jobs und kann Sie deshalb nie mehr als einen Takt pro Sitzung kosten: knapp 40 Cent pro Sitzung bei stundenweiser Abrechnung zu 0,40 $ und unter 0,7 Cent pro Sitzung bei minutengenauer Abrechnung zum selben Preis (59 Sekunden × 40 / 3.600 = 0,66 ¢).
Was jede Plattform verwendet
Das sind die veröffentlichten Regeln für On-Demand-Instanzen, im September 2026 in der Dokumentation des jeweiligen Anbieters geprüft.
| Plattform | Takt | Mindestdauer | Hinweis aus der Doku |
|---|---|---|---|
| AWS EC2 On-Demand | Pro Sekunde | 60 Sekunden | Gilt für Linux, Windows, RHEL und Ubuntu Pro. SUSE Linux Enterprise Server wird nach vollen Stunden abgerechnet. |
| Google Cloud Compute Engine | Pro Sekunde | 1 Minute | „Alle vCPUs, GPUs und GB Arbeitsspeicher werden für mindestens 1 Minute berechnet.“ |
| Azure Virtual Machines | Pro Minute | Keine Angabe | Berechnet „die Zahl der vollen Minuten“; eine VM, die 6 Min. 45 s läuft, wird mit 6 Minuten berechnet. |
| Lambda (On-Demand-Cloud) | Pro Minute | Keine Angabe | Berechnet „in Schritten von einer Minute“, ab dem Moment, in dem die Instanz die Health Checks besteht, bis Sie sie beenden. |
| RunPod Pods | Pro Sekunde | Keine Angabe | Rechenleistung und Speicher werden beide sekundengenau berechnet. |
| Vast.ai | Pro Sekunde | Keine Angabe | Eine aktive Miete wird jede Sekunde berechnet; Speicher jede Sekunde, die die Instanz existiert, außer sie ist offline. |
| GPUFlow | Pro Sekunde | 60 Sekunden | Volle Sekunden, auf den Cent aufgerundet, gedeckelt auf den reservierten Betrag. |
Zwei Hinweise zum Lesen der Tabelle. Die Regel von Azure rundet tatsächlich ab: Laut FAQ werden Ihnen „keine zusätzlichen Sekunden berechnet“. Die Doku von Lambda spricht von Schritten zu einer Minute, sagt aber nicht, in welche Richtung eine angebrochene Minute gerundet wird; ich habe daher keines von beiden angenommen. Und „keine Angabe“ heißt genau das: Die Doku, die ich gelesen habe, nennt keine Mindestdauer. Das ist etwas anderes als eine dokumentierte Mindestdauer von null.
Keine dieser Plattformen rundet GPU-Rechenzeit für die genannten Instanztypen auf volle Stunden. Stundenweises Runden taucht aber im Kleingedruckten noch auf, wie bei SUSE auf AWS. Prüfen Sie also die Abrechnungsseite, bevor Sie irgendwo neu viele kurze Jobs laufen lassen.
Fünf Jobs zu 0,40 $ pro Stunde
Hier ist ein einziger Preis, 0,40 $ pro Stunde, angewendet auf fünf Joblängen. Das sind 40 Cent pro 3.600 Sekunden oder 1/90 Cent pro Sekunde.
Ein Test von 90 Sekunden. Pro Sekunde: 90 × 40 / 3.600 = 1,0 ¢. Pro Minute: 2 Minuten × 40 / 60 = 1,33 ¢. Volle Stunde: 40 ¢. Die stundenweise Rechnung ist 40-mal so hoch wie die sekundengenaue.
7 Minuten 30 Sekunden. Pro Sekunde: 450 × 40 / 3.600 = 5,0 ¢. Pro Minute: 8 Minuten × 40 / 60 = 5,33 ¢. Volle Stunde: 40 ¢, 8-mal so viel.
38 Minuten 20 Sekunden. Pro Sekunde: 2.300 × 40 / 3.600 = 25,56 ¢. Pro Minute: 39 Minuten × 40 / 60 = 26,0 ¢. Volle Stunde: 40 ¢, etwa 1,57-mal so viel.
61 Minuten. Pro Sekunde: 3.660 × 40 / 3.600 = 40,67 ¢. Pro Minute: 61 × 40 / 60 = 40,67 ¢ (der Job endet auf einer vollen Minute, also stimmen beide überein). Volle Stunde: zwei Stunden, 80 ¢. Eine Minute mehr verdoppelt die stundenweise Rechnung fast.
| Joblänge | Pro Sekunde (60 s Minimum) | Pro Minute (aufgerundet) | Volle Stunde | GPUFlow-Abbuchung |
|---|---|---|---|---|
| 1 Min. 30 s | 1,00 ¢ | 1,33 ¢ | 40 ¢ | 1 ¢ |
| 7 Min. 30 s | 5,00 ¢ | 5,33 ¢ | 40 ¢ | 5 ¢ |
| 38 Min. 20 s | 25,56 ¢ | 26,00 ¢ | 40 ¢ | 26 ¢ |
| 61 Min. | 40,67 ¢ | 40,67 ¢ | 80 ¢ | 41 ¢ |
| 20 Jobs à 2 Min. 30 s | 33,33 ¢ | 40,00 ¢ | 8,00 $ | 40 ¢ (20 Mieten) |
Die GPUFlow-Spalte ist das sekundengenaue Ergebnis, pro Miete auf einen vollen Cent aufgerundet, so wie es der Abrechnungscode macht. Die letzte Zeile erklären wir zwei Abschnitte weiter unten.
Kosten nach Joblänge, maßstabsgetreu
Das erste Diagramm reicht von 0 bis 150 Minuten. Die Treppe der minutengenauen Abrechnung hat Stufen von 1 Minute Breite und 0,67 Cent Höhe; in diesem Maßstab liegt sie deshalb auf der sekundengenauen Linie. Die Treppe, auf die es ankommt, ist die der vollen Stunden: Sie springt bei 0, 60 und 120 Minuten um 40 Cent.
Der Abstand zwischen der orangefarbenen Treppe und der blauen Linie ist das, was das Runden auf volle Stunden pro Job kostet: am größten direkt nach jeder Stufe, null bei vollen Stunden.
Vergrößert auf die ersten zehn Minuten zeigt die minutengenaue Abrechnung ihre Stufen, und die Mindestdauer von 60 Sekunden erscheint als flacher Anfang der sekundengenauen Linie. Die Abrechnung nach vollen Stunden wäre eine flache Linie bei 40 Cent, fünfmal höher als der obere Rand dieses Diagramms.
Ein Tag voller kurzer Jobs
Kurze Jobs kommen selten allein. Angenommen, Sie lassen an einem Arbeitstag 20 Jobs von je 2 Minuten 30 Sekunden laufen und starten für jeden eine neue Instanz.
- Pro Sekunde: 20 × 150 s = 3.000 s, und 3.000 × 40 / 3.600 = 33,33 ¢.
- Pro Minute, aufgerundet: Jeder Job zählt 3 Minuten, insgesamt also 60 Minuten: 40 ¢.
- Volle Stunde: Jeder Job ist eine angefangene Stunde: 20 × 40 ¢ = 8,00 $.
Stundenweise Abrechnung kostet für dieselben 50 Minuten GPU-Arbeit das 24-Fache. Der naheliegende Ausweg: eine Maschine den ganzen Tag laufen lassen. Acht Stunden zu 0,40 $ sind 3,20 $. Das schlägt 8,00 $, ist aber immer noch das 9,6-Fache der sekundengenauen Rechnung, weil Sie jetzt die Pausen zwischen den Jobs bezahlen.
Dieses Beispiel schönt allerdings den Ansatz mit neuen Instanzen, denn es geht davon aus, dass ein Job in dem Moment startet, in dem die Maschine startet. Das tut er nicht. Nehmen wir zur Veranschaulichung an, dass jeder Start 3 Minuten mit Booten, dem Laden eines Images und eines Modells verbringt, bevor die Arbeit beginnt (Ihr Wert wird anders sein). Sekundengenaue Abrechnung berechnet dann 20 × 330 s = 6.600 s, also 73,33 ¢, mehr als das Doppelte der 33,33 ¢ für die eigentliche Arbeit. Der Takt ist derselbe; die Verschwendung ist in die Einrichtung gewandert.
Bei GPUFlow sieht derselbe Tag etwas anders aus, denn eine Miete wird in vollen Stunden gebucht und sekundengenau abgerechnet. 20 einzelne Mieten von je 150 s kosten ceil(150 × 40 / 3.600) = ceil(1,67) = 2 ¢ pro Miete, insgesamt also 40 ¢. Das Aufrunden jeder Miete auf einen vollen Cent macht hier 0,33 ¢ pro Job aus; daher kommen die 6,67 ¢ mehr gegenüber der sekundengenauen Summe. Wenn die Jobs dicht aufeinander folgen, beachten Sie das Limit von 10 neuen Mieten pro Stunde und Nutzer. Eine einzige Miete den ganzen Tag offen zu halten, kostet die volle Uhrzeit, 8 Stunden = 3,20 $, denn GPUFlow rechnet nach Zeit ab, nicht nach Tokens.
Was wichtiger ist als der Takt
Sobald Jobs länger als etwa zehn Minuten laufen, ist die Frage pro Sekunde oder pro Minute ein Rundungsfehler. Diese drei Dinge sind es nicht. Ausführlicher behandelt sie GPU mieten: Was der Stundenpreis verschweigt und was Sie wirklich zahlen.
Leerlauf
Jede Plattform mit sekundengenauer Abrechnung berechnet eine laufende Instanz, ob die GPU arbeitet oder nicht. Die Doku von Lambda sagt es direkt: Instanzen werden berechnet, „egal ob sie aktiv genutzt werden“. Der Tag mit kurzen Jobs oben zeigt die Größenordnung: 50 Minuten Arbeit, 3,20 $, wenn die Maschine 8 Stunden läuft. Kein Abrechnungstakt hilft gegen eine Maschine, die Sie vergessen haben anzuhalten.
Einrichtungszeit
Booten, Laden von Images und Herunterladen von Modellen laufen alle auf die Uhr. Lambda beginnt mit der Abrechnung, sobald die Instanz die Health Checks besteht, bevor Ihr Code irgendetwas getan hat. Sekundengenaue Abrechnung beseitigt diese Kosten nicht; Sie zahlen sie bei jedem Start.
Speicher im gestoppten Zustand
Wer eine Maschine stoppt, stoppt meist die GPU-Kosten. Die Festplatte wird weiter berechnet. RunPod berechnet das Volume eines gestoppten Pods mit 0,20 $ pro GB und Monat, doppelt so viel wie im laufenden Betrieb, und warnt in der Doku, dass „für gestoppte Pods weiterhin Speicherkosten anfallen“. Vast.ai sagt klar, dass „das Stoppen einer Instanz keine Speicherkosten vermeidet“. Ein Volume mit 100 GB an einem gestoppten RunPod-Pod kostet 100 × 0,20 $ = 20 $ im Monat, das sind 50 Stunden GPU-Zeit zu 0,40 $.
Wenn Ihre Arbeit aus Aufrufen eines Modells besteht und nicht aus eigenem Code auf einer Maschine, vergleichen Sie auch mit Preisen pro Token: GPU pro Stunde oder API pro Token? rechnet durch, wann was günstiger ist.
Wie GPUFlow abrechnet: erst reservieren, dann den Rest erstatten
GPUFlow vermietet Inferenz: Sie bekommen einen OpenAI-kompatiblen API-Schlüssel für ein Modell, das auf der GPU eines anderen läuft, keine Maschine. Es gibt keine Shell, keine Festplatte und kein Image, für die Sie zahlen müssten; Speicher und Einrichtung aus dem vorigen Abschnitt fallen also weg. Leerlauf nicht: Die Miete wird vom Start bis zum Ende berechnet, ob die GPU arbeitet oder nicht.
Die Schritte:
- Sie wählen ein Angebot und eine ganze Zahl von Stunden (standardmäßig 1 bis 168). Der Stundenpreis des Anbieters wird in ganze Cent umgerechnet.
- Beim Start wird der volle gebuchte Betrag von Ihren Credits reserviert: Preis in Cent × Stunden. Das ist der ganze Betrag, und er wird im Voraus reserviert.
- Wenn die Miete endet, wird die Abbuchung einmal berechnet: genutzte volle Sekunden, mindestens 60, mal Preis in Cent, geteilt durch 3.600, aufgerundet auf den nächsten Cent und nie mehr als die Reservierung.
- Was von der Reservierung übrig bleibt, geht im selben Schritt zurück an Ihre verfügbaren Credits.
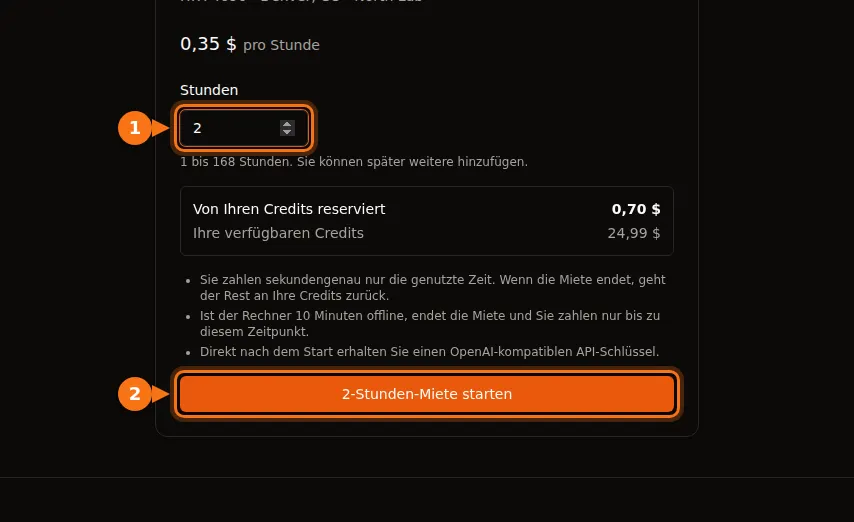
Das Mietformular zeigt die Reservierung, bevor Sie starten: 2 Stunden zu 0,35 $ reservieren 0,70 $.
Ein Rechenbeispiel
Sie buchen 3 Stunden zu 0,40 $. Die Reservierung beträgt 40 ¢ × 3 = 120 ¢ (1,20 $). Nach 38 Minuten 20 Sekunden, also 2.300 Sekunden, klicken Sie auf Jetzt beenden.
- Abbuchung: ceil(2.300 × 40 / 3.600) = ceil(25,56) = 26 ¢.
- Zurück an Ihre Credits: 120 − 26 = 94 ¢.
- Die Plattformgebühr beträgt 12 % der Abbuchung, pro Miete auf den nächsten Cent gerundet: round(26 × 0,12) = round(3,12) = 3 ¢. Der Anbieter bekommt 26 − 3 = 23 ¢, also 88,5 % dieser Abbuchung statt genau 88 %. Bei größeren Beträgen spielt die Rundung eine kleinere Rolle.
Wenn eine Miete ohne Sie endet
Sind die gebuchten Stunden abgelaufen, schließt ein Hintergrundjob, der jede Minute läuft, die Miete ab. Die Abbuchung wird bis zum gebuchten Endzeitpunkt berechnet; eine Verzögerung, bis der Job läuft, zahlen Sie also nicht. Der API-Schlüssel funktioniert ab dem Endzeitpunkt nicht mehr. Wenn Sie mehr Zeit brauchen, reserviert Stunden hinzufügen weitere Credits, und der Schlüssel bleibt derselbe.
Auch wenn der Rechner des Anbieters verstummt, endet die Miete. Der Agent auf dem Rechner des Anbieters sendet alle 15 Sekunden einen Heartbeat. Kommt 10 Minuten lang keiner, wird die Miete beendet und nur bis zum letzten Heartbeat berechnet. Bei 0,40 $ pro Stunde kostet ein Rechner, der 25 Minuten nach Beginn einer 3-Stunden-Buchung ausfällt, ceil(1.500 × 40 / 3.600) = 17 ¢, und die übrigen 103 ¢ der Reservierung von 120 ¢ kommen zurück.
Beim Buchen in vollen Stunden gibt es mit dem 61-Minuten-Job einen Haken. Wenn Sie 1 Stunde buchen und vergessen, vor dem Ablauf auf Stunden hinzufügen zu klicken, funktioniert der Schlüssel nach 60 Minuten nicht mehr, und Sie zahlen 40 ¢ für einen unfertigen Job. Buchen Sie 2 Stunden (80 ¢ reserviert) und beenden Sie nach 61 Minuten, zahlen Sie 41 ¢ und bekommen 39 ¢ zurück. Im Zweifel: lang buchen und früh beenden; ungenutzte Zeit kostet nichts.
Das Abrechnungsmodell nach Art der Jobs wählen
- Viele Jobs unter 10 Minuten: sekunden- oder minutengenaue Abrechnung, und prüfen Sie die Mindestdauer. Alles, was auf volle Stunden rundet, ist hier das falsche Werkzeug.
- Jobs von 30 bis 90 Minuten: Meiden Sie das Runden auf volle Stunden (ein Job von 61 Minuten zahlt zwei Stunden). Pro Sekunde oder pro Minute macht weniger als einen Cent pro Job aus.
- Lange Läufe über viele Stunden: Der Takt fällt kaum ins Gewicht. Achten Sie stattdessen auf Leerlauf, Einrichtung und Speicher.
- Aufrufe eines Modells in Schüben über den Tag: Eine neue Maschine pro Schub zahlt jedes Mal die Einrichtung, eine durchgehend laufende Maschine zahlt die Pausen. Eine Inferenz-Miete, bei der ein Modell bereitsteht, ist ein Weg, die Einrichtung zu vermeiden, aber die Uhr läuft auch zwischen den Aufrufen weiter. Legen Sie die Buchung also auf die Zeiten, in denen Sie tatsächlich arbeiten.
Wenn Sie es ausprobieren wollen: Der GPUFlow-Marktplatz zeigt die Stundenpreise pro GPU, und was Sie zum Mieten einer GPU brauchen behandelt Konto und Zahlung.
Quellen
- AWS, Preise für Amazon EC2 On-Demand (Abrechnungsdetails): aws.amazon.com/ec2/pricing/on-demand
- Google Cloud, Preise für VM-Instanzen (Abrechnungsmodell): cloud.google.com/compute/vm-instance-pricing
- Microsoft Azure, Preise für Linux Virtual Machines (FAQ): azure.microsoft.com/pricing/details/virtual-machines/linux
- Lambda, Überblick zur Abrechnung: docs.lambda.ai/public-cloud/billing
- RunPod, Preise für Pods: docs.runpod.io/pods/pricing
- Vast.ai, Referenz zur Abrechnung: docs.vast.ai/documentation/reference/billing
- GPUFlow-Doku, Credits, Abrechnung und Erstattungen: docs.gpuflow.app/de/renters/billing
Alle geprüft im September 2026.