Mit der 4-Bit-Quantisierung, die Ollama standardmäßig ausliefert, braucht ein 7B- oder 8B-Modell eine 8-GB-Karte, 12B- bis 14B-Modelle brauchen 12 GB (16 GB, wenn Sie lange Prompts wollen), und 27B- bis 32B-Modelle brauchen 24 GB. Ein 70B-Modell ist in 4 Bit 43 GB groß, also brauchen Sie 48 GB VRAM oder mehr.
Die ausführliche Antwort ist wichtig, weil die Download-Größe nicht die ganze Rechnung ist. Auch der Kontext belegt Speicher, und ein Modell, das scheinbar passt, kann am Ende zur Hälfte auf der CPU laufen und um ein Vielfaches langsamer sein. Unten finden Sie die Formel, mit der ich rechne, was die Quantisierungsbezeichnungen bedeuten, und eine Tabelle aktueller offener Modelle mit ihren echten Download-Größen aus der Ollama-Bibliothek. Größen und technische Daten wurden im September 2026 geprüft; die Quellen stehen am Ende.
Die kurze Antwort nach VRAM-Größe
| VRAM | Typische Karten | Was komplett auf der GPU läuft (4 Bit) |
|---|---|---|
| 8 GB | RTX 4060, RTX 5060, RTX 3070 | Modelle mit 7B bis 8B: Llama 3.1 8B, Qwen3 8B, Mistral 7B |
| 12 GB | RTX 3060 12 GB, RTX 4070, RTX 5070 | 12B- bis 14B-Modelle bei kurzem Kontext; 7B bis 8B in Q8_0 |
| 16 GB | RTX 4060 Ti 16 GB, RTX 4080, RTX 5080 | 14B mit langem Kontext, gpt-oss 20B |
| 24 GB | RTX 3090, RTX 4090 | 24B bis 32B: Mistral Small 3.2, Gemma 3 27B, Qwen3 32B |
| 32 GB | RTX 5090 | 32B mit langem Kontext, 35B-Mixture-of-Experts-Modelle |
| 48 bis 80 GB | L40S (48 GB), H100 (80 GB) | 70B in 4 Bit, gpt-oss 120B auf 80 GB |
Die Speichergrößen der Karten stammen aus den Datenblättern von NVIDIA. Manche Karten gibt es in zwei Versionen: die RTX 3060 mit 12 GB und mit 8 GB, die RTX 4060 Ti und die RTX 5060 Ti mit 16 GB und mit 8 GB. Prüfen Sie, welche Sie kaufen oder mieten.
So schätzen Sie den VRAM-Bedarf eines Modells
Während ein Modell antwortet, liegen drei Dinge im GPU-Speicher:
- Die Gewichte. Parameter × Bits pro Gewicht ÷ 8 = Bytes.
- Der KV-Cache. Das Modell hält die Keys und Values jedes Tokens im Gespräch vor, damit es sie nicht neu berechnen muss. Pro Token sind das 2 × Schichten × KV-Heads × Head-Größe × 2 Bytes (beim standardmäßigen 16-Bit-Cache). Das multiplizieren Sie mit der Kontextlänge.
- Overhead. Der CUDA-Kontext, Arbeitspuffer und die Laufzeitumgebung selbst. Ich plane etwa 1 GB ein. Der Wert schwankt je nach Engine und Einstellungen; nehmen Sie ihn als Faustregel, nicht als Spezifikation.
Die Zahl der Schichten und Heads steht in der config.json jedes Modells auf Hugging Face.
Rechenbeispiel: Qwen 2.5 14B auf einer 16-GB-Karte
Qwen 2.5 14B hat 14,7 Milliarden Parameter, 48 Schichten, 8 KV-Heads und eine Head-Größe von 128 (5.120 Hidden Size ÷ 40 Attention-Heads).
- Gewichte in Q4_K_M: llama.cpp gibt für Q4_K_M etwa 4,89 Bits pro Gewicht an. 14,7 Milliarden × 4,89 ÷ 8 = 8,99 GB. Der Download von
qwen2.5:14bbei Ollama ist 9,0 GB groß; die Rechnung stimmt also mit der echten Datei überein. - KV-Cache pro Token: 2 × 48 × 8 × 128 × 2 Bytes = 196.608 Bytes, etwa 0,2 MB.
- KV-Cache für den ganzen Kontext: 4.096 Tokens = 0,8 GB. 16.384 Tokens = 3,2 GB. 32.768 Tokens = 6,4 GB.
- Summe: 9,0 + 0,8 + 1 = 10,8 GB bei 4K Kontext. 9,0 + 3,2 + 1 = 13,2 GB bei 16K. 9,0 + 6,4 + 1 = 16,4 GB bei 32K, und das passt nicht mehr auf eine 16-GB-Karte.
Daraus folgen zwei Dinge. Erstens kann der eingestellte Kontext so viel Speicher kosten wie das Modell selbst. Llama 3.1 8B (32 Schichten, 8 KV-Heads, Head-Größe 128) braucht 131.072 Bytes KV-Cache pro Token. Der volle Kontext von 128K bräuchte also allein 17,2 GB Cache, etwa dreieinhalbmal so viel wie der Download mit 4,9 GB. Zweitens unterscheidet sich die KV-Cache-Größe pro Token stark zwischen Modellen. Qwen 2.5 7B hat nur 4 KV-Heads und 28 Schichten und braucht deshalb 57.344 Bytes pro Token, weniger als die Hälfte von Llama 3.1 8B. Sehen Sie in die Config, bevor Sie etwas annehmen.
Was Ollama standardmäßig mit dem Kontext macht
Ollama wählt die Standard-Kontextlänge nach dem VRAM, den es vorfindet: 4K Tokens unter 24 GiB, 32K Tokens von 24 bis 48 GiB und 256K ab 48 GiB. Ändern können Sie das mit der Umgebungsvariable OLLAMA_CONTEXT_LENGTH, und ollama ps zeigt in der Spalte CONTEXT den tatsächlich reservierten Kontext. Zwei weitere Einstellungen ändern die Rechnung:
OLLAMA_NUM_PARALLEL(Standard 1): Laut der Ollama-Doku vergrößern parallele Anfragen den Kontext um die Zahl der parallelen Anfragen. Vier parallele Slots bedeuten den vierfachen KV-Cache.OLLAMA_KV_CACHE_TYPE:q8_0braucht etwa halb so viel Speicher wie der Standard-Cachef16,q4_0etwa ein Viertel. Dafür muss Flash Attention aktiviert sein.
Was die Quantisierungsstufen bedeuten
Offene Modelle werden in 16-Bit-Genauigkeit veröffentlicht (die unten verlinkten Configs nennen bfloat16): zwei Bytes pro Parameter. Quantisierung speichert die Gewichte mit weniger Bits. In GGUF-Dateien, dem Format von Ollama und llama.cpp, bedeuten die Bezeichnungen ungefähr Folgendes:
| Bezeichnung | Bits pro Gewicht | Größe Llama 3.1 8B | Perplexity bei Llama 3 8B (niedriger ist besser) |
|---|---|---|---|
| F16 | 16,0 | 14,96 GiB | 6,233 |
| Q8_0 | 8,50 | 7,95 GiB | 6,234 |
| Q6_K | 6,56 | 6,14 GiB | 6,253 |
| Q5_K_M | 5,70 | 5,33 GiB | 6,289 |
| Q4_K_M | 4,89 | 4,58 GiB | 6,407 |
| Q3_K_M | 4,00 | 3,74 GiB | 6,888 |
| Q2_K_S / Q2_K | 2,97 | 2,78 GiB | 9,752 (Q2_K) |
Bits pro Gewicht und Größen stammen aus der README zu quantize von llama.cpp (Llama 3.1 8B), die Perplexity aus der README zu perplexity von llama.cpp (Llama 3 8B, Wikitext). Die „K“-Typen sind die K-Quants von llama.cpp, die unterschiedliche Genauigkeiten im Modell mischen; _S, _M und _L stehen für kleine, mittlere und große Mischungen.
Was die Zahlen zeigen: Q8_0 ist praktisch verlustfrei (Perplexity 6,234 gegenüber 6,233). Q4_K_M kostet etwa 3 % Perplexity, und laut derselben README stimmt das wahrscheinlichste nächste Token in 91,9 % der Fälle mit dem Modell in voller Genauigkeit überein. Q3 ist spürbar schlechter, und Q2 bricht ein.
Perplexity ist nicht dasselbe wie Nützlichkeit. Deshalb hilft eine Studie von Uygar Kurt aus dem Januar 2026: Sie hat Llama 3.1 8B Instruct auf jeder llama.cpp-Stufe durch Benchmarks für Reasoning, Wissen, Befolgen von Anweisungen und Wahrhaftigkeit geschickt. Der ungewichtete Durchschnitt lag bei 69,47 in F16, 69,41 in Q8_0, 69,36 in Q5_K_M und 69,15 in Q4_K_M. Das ist der Grund, warum fast alle, Ollama eingeschlossen, standardmäßig Q4_K_M verwenden: Die Datei ist kleiner als ein Drittel von FP16, und den Verlust bemerken Sie selten. Bei Ollama ist der einfache Tag genau dieser 4-Bit-Build: qwen3:8b und qwen3:8b-q4_K_M sind beide 5,2 GB groß, phi4:14b und phi4:14b-q4_K_M beide 9,1 GB.
Meine Regel: Nehmen Sie lieber das größte Modell, das in Q4_K_M passt, als ein kleineres in Q8_0. Ein 14B in Q4 schlägt meist ein 7B in Q8, und die Dateien sind ungefähr gleich groß. Zu Q5 oder Q8 greifen Sie, wenn Speicher übrig ist und die Aufgabe empfindlich auf kleine Fehler reagiert, etwa bei Code oder exakter Extraktion.
Neuere Ollama-Tags enthalten außerdem Formate wie qat (die quantisierungsbewusst trainierten Builds von Gemma), nvfp4 und mxfp8. gpt-oss liefert OpenAI selbst in MXFP4 aus, mit 4,25 Bits pro Parameter für die Mixture-of-Experts-Gewichte.
Welche Modelle passen: Größen und VRAM-Stufen
Die Tabelle zeigt aktuelle offene Modelle aus der Ollama-Bibliothek, Stand September 2026, mit ihren Download-Größen. Die Spalte „4 Bit“ gibt die Größe des Standard-Tags an. Bei den meisten Modellen ist das dieselbe Datei wie beim Tag q4_K_M; wo der Standard ein anderer Build ist, stehen beide Größen in der Tabelle (bei Mistral Nemo ist der Standard 7,1 GB groß, q4_K_M 7,5 GB). „Kleinste Karte“ heißt: Das Modell plus etwa 1 GB Overhead plus 4K bis 8K Kontext passt komplett auf die GPU. Sie wollen langen Kontext? Gehen Sie eine Stufe höher.
| Modell | Ollama-Tag | Größe 4 Bit | Größe Q8_0 | Kleinste Karte (4 Bit / Q8_0) |
|---|---|---|---|---|
| Mistral 7B v0.3 | mistral:7b | 4,4 GB | 7,7 GB | 8 GB / 12 GB |
| Qwen 2.5 7B | qwen2.5:7b | 4,7 GB | 8,1 GB | 8 GB / 12 GB |
| DeepSeek-R1 Distill 7B (Qwen 2.5) | deepseek-r1:7b | 4,7 GB | nicht geprüft | 8 GB |
| Llama 3.1 8B | llama3.1:8b | 4,9 GB | 8,5 GB | 8 GB / 12 GB |
| Qwen3 8B | qwen3:8b | 5,2 GB | 8,9 GB | 8 GB / 12 GB |
| DeepSeek-R1-0528 (Qwen3 8B) | deepseek-r1:8b | 5,2 GB | nicht geprüft | 8 GB |
| Qwen3.5 9B | qwen3.5:9b | 6,6 GB | 11 GB | 8 GB, nur kurzer Kontext / 16 GB |
| Mistral Nemo 12B | mistral-nemo:12b | 7,1 GB (q4_K_M: 7,5 GB) | 13 GB | 12 GB / 16 GB |
| Gemma 4 12B | gemma4:12b | 7,6 GB | 13 GB | 12 GB / 16 GB |
| Gemma 3 12B | gemma3:12b | 8,1 GB | 13 GB | 12 GB / 16 GB |
| Qwen 2.5 14B | qwen2.5:14b | 9,0 GB | 16 GB | 12 GB / 24 GB |
| DeepSeek-R1 Distill 14B (Qwen 2.5) | deepseek-r1:14b | 9,0 GB | nicht geprüft | 12 GB |
| Phi-4 14B | phi4:14b | 9,1 GB | 16 GB | 12 GB / 24 GB |
| Qwen3 14B | qwen3:14b | 9,3 GB | 16 GB | 12 GB / 24 GB |
| gpt-oss 20B (MoE) | gpt-oss:20b | 14 GB (MXFP4) | entfällt | 16 GB |
| Mistral Small 3.2 24B | mistral-small3.2:24b | 15 GB | 26 GB | 24 GB / 32 GB |
| Gemma 3 27B | gemma3:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.5 27B | qwen3.5:27b | 17 GB | 30 GB | 24 GB / 48 GB |
| Qwen3.6 27B | qwen3.6:27b | 18 GB (q4_K_M: 17 GB) | 30 GB | 24 GB / 48 GB |
| Gemma 4 26B (MoE, 3,8B aktiv) | gemma4:26b | 19 GB (q4_K_M: 18 GB) | 28 GB | 24 GB / 32 GB |
| Qwen3 30B-A3B (MoE) | qwen3:30b | 19 GB | nicht geprüft | 24 GB |
| Gemma 4 31B | gemma4:31b | 20 GB | 34 GB | 24 GB / 48 GB |
| Qwen3 32B | qwen3:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| Qwen 2.5 32B | qwen2.5:32b | 20 GB | 35 GB | 24 GB / 48 GB |
| DeepSeek-R1 Distill 32B (Qwen 2.5) | deepseek-r1:32b | 20 GB | nicht geprüft | 24 GB |
| Qwen3.6 35B-A3B (MoE) | qwen3.6:35b | 23 GB (q4_K_M: 24 GB) | 39 GB | 32 GB / 48 GB |
| Qwen3.5 35B-A3B (MoE) | qwen3.5:35b | 24 GB | 39 GB | 32 GB / 48 GB |
| Llama 3.3 70B | llama3.3:70b | 43 GB | 75 GB | 48 GB, knapp / 80 GB, knapp |
| Qwen 2.5 72B | qwen2.5:72b | 47 GB | nicht geprüft | 80 GB |
| gpt-oss 120B (MoE) | gpt-oss:120b | 65 GB (MXFP4) | entfällt | 80 GB |
Für die Stufe habe ich die Größe des Standard-Tags genommen, denn den lädt ollama pull mit dem kurzen Namen herunter.
Die Stufen für Karten mit 24 GB und 32 GB haben einen Haken. Der Standard-Kontext von Ollama springt bei 24 GiB von 4K auf 32K. Ein 20-GB-Modell auf einer RTX 4090 bekommt also womöglich einen 32K-Cache, der nicht mehr daneben passt. Zeigt ollama ps einen CPU-Anteil, stellen Sie einen kleineren Kontext ein. Und beurteilen Sie ein Modell nicht nach der Zahl im Namen: Das Edge-Modell von Gemma 4, gemma4:e4b (4,5B effektive Parameter), ist ein Download von 9,6 GB und damit größer als gemma4:12b mit 7,6 GB. Prüfen Sie die Größe.
Mixture-of-Experts-Modelle ändern das Bild ein wenig
gpt-oss, Gemma 4 26B und die „A3B“-Modelle von Qwen sind Mixture-of-Experts-Modelle (MoE). Pro Token laufen nur wenige Experten: Gemma 4 26B hat 25,2B Parameter, aber nur 3,8B davon sind aktiv. An der Speicherregel ändert das nichts, denn alle Gewichte müssen trotzdem irgendwo geladen sein. Was sich ändert, ist die Geschwindigkeit, wenn nicht alles passt. Weil jedes Token nur einen Bruchteil der Gewichte berührt, wird ein MoE-Modell, das in den Arbeitsspeicher überläuft, weit weniger langsam als ein dichtes Modell gleicher Größe. Wie groß der Unterschied ist, zeigen die Messungen im nächsten Abschnitt.
Was passiert, wenn ein Modell nicht passt
Ollama weigert sich nicht, ein zu großes Modell zu laden. Es legt so viele Schichten auf die GPU, wie hineinpassen, und führt den Rest auf der CPU aus dem Arbeitsspeicher aus. ollama ps zeigt, welcher Fall vorliegt: 100% GPU heißt, alles passt, 100% CPU heißt, nichts passt, und eine Mischung wie 48%/52% CPU/GPU bedeutet eine Aufteilung.
Eine Aufteilung ist teuer, denn für jedes erzeugte Token muss jedes aktive Gewicht gelesen werden, und der Arbeitsspeicher ist viel langsamer als VRAM. Eine Reihe von llama.cpp-Läufen auf einer RTX 4080 mit 16 GB, die Rost im April 2026 auf DEV Community veröffentlicht hat, zeigt das deutlich:
| Modell (Quantisierung, Dateigröße) | Kontext | Last GPU / CPU | Tokens pro Sekunde |
|---|---|---|---|
| Qwen3.5 27B dicht (IQ3_XXS, 11,5 GB) | 32K | 98 % / 100 % | 45,1 |
| Qwen3.5 27B dicht | 64K | 45 % / 410 % | 22,7 |
| Qwen3.5 27B dicht | 128K | 16 % / 625 % | 9,6 |
| Qwen3.5 35B-A3B MoE (IQ3_S, 13,6 GB) | 64K | 88 % / 115 % | 136,8 |
| Qwen3.5 122B-A10B MoE (IQ3_XXS, 44,7 GB) | 32K | 30 % / 480 % | 21,8 |
Ein hoher CPU-Wert bei niedrigem GPU-Wert heißt, dass der Großteil der Arbeit auf die CPU gewandert ist; der Autor liest die Zahlen genauso.
Dasselbe dichte Modell verlor beim Schritt von 32K auf 64K Kontext die Hälfte seiner Geschwindigkeit, nur weil der größere KV-Cache Schichten von der GPU verdrängte, und bei 128K fast 80 %. Das 122B-MoE-Modell, eine Datei mit 44,7 GB auf einer 16-GB-Karte, lief immer noch mit etwa 22 Tokens pro Sekunde, weil pro Token nur 10B Parameter aktiv sind. Bei dichten Modellen heißt „teilweise auf der CPU“ so viel wie „um ein Vielfaches langsamer“. Bei MoE-Modellen kann es ein akzeptabler Kompromiss sein.
Wenn Sie auf eine Aufteilung stoßen, sind das die Abhilfen, von billig nach teuer: Kontext verkleinern, den KV-Cache auf q8_0 quantisieren, eine kleinere Quantisierung desselben Modells wählen (Q4_K_M statt Q5), ein kleineres Modell nehmen oder auf eine Karte mit mehr Speicher wechseln.
32 GB und Rechenzentrumskarten
Die RTX 5090 hat 32 GB. Damit bekommen Sie ein 32B-Modell in 4 Bit mit langem Kontext unter oder die 35B-A3B-MoE-Modelle mit 23 bis 24 GB samt Platz für den Cache. Für 70B reicht es nicht: llama3.3:70b ist selbst in 4 Bit 43 GB groß.
Für 70B brauchen Sie 48 GB oder mehr. Eine L40S hat 48 GB; darauf passt die 43-GB-Datei, aber mit wenig Platz für Kontext. Eine H100 SXM hat 80 GB (die H100 NVL 94 GB). Darauf passen Llama 3.3 70B in 4 Bit mit langem Kontext, gpt-oss 120B (65 GB; laut der Ollama-Seite passt es auf eine einzelne GPU mit 80 GB) oder Llama 3.3 70B in Q8_0 (75 GB) mit kurzem Kontext. Qwen3.5 122B ist mit 81 GB schon zu groß für eine einzelne Karte mit 80 GB.
Mieten statt kaufen: ein GPUFlow-Angebot prüfen
Wenn Sie bei GPUFlow eine GPU mieten, stellt der Anbieter die Modelle von seinem eigenen Rechner bereit (mit Ollama, das der GPUFlow-Installer standardmäßig einrichtet) und entscheidet, welche Modelle installiert sind. Sie laden selbst keine Modelle herunter: Sie bekommen einen OpenAI-kompatiblen API-Schlüssel für diese GPU, keine Shell. Der GPUFlow-Installer verwendet standardmäßig qwen2.5:7b, und die im Installer und in der Doku genannten Tags sind qwen2.5:0.5b, deepseek-r1:1.5b, qwen2.5:7b, deepseek-r1:7b, llama3.1:8b und qwen2.5:14b. Anbieter können weitere installieren.
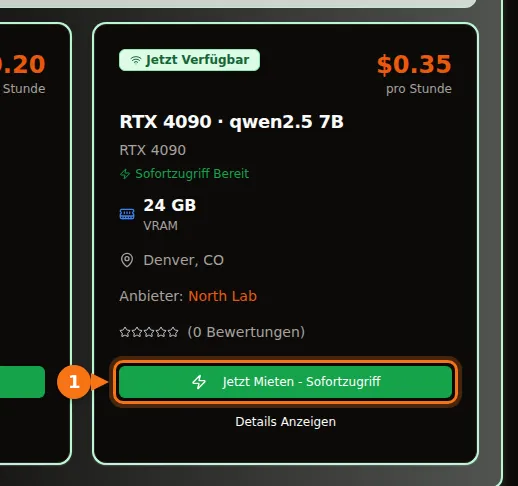
Auf dem Marktplatz zeigt jede Karte die GPU, ihren VRAM und den Preis pro Stunde, und in der Beschreibung nennt der Anbieter die Modelle, die er bereitstellt. Die GPUFlow-Doku formuliert dieselbe Regel etwas vorsichtiger: Ein 7B-Modell läuft gut ab 8 GB, ein 14B-Modell ab 16 GB. Sobald Sie einen Schlüssel haben, liefert GET /v1/models einen Modellnamen zurück; nennt die Beschreibung weitere Modelle, können Sie auch deren Namen im Feld model verwenden.
Zwei Dinge sollten Sie wissen. GPUFlow setzt kein eigenes Kontextlimit, es gelten also die Standardwerte von Ollama auf dem Rechner des Anbieters, sofern er sie nicht geändert hat. Und ein Modell, das der Anbieter nicht installiert hat, steht Ihnen nicht zur Verfügung. Wählen Sie das Angebot also zuerst nach dem Modell, das Sie brauchen, und erst dann nach der GPU. Den Schlüssel mit Open WebUI, Continue oder LangChain verbinden funktioniert wie mit jeder API im OpenAI-Stil.
Verwandte Artikel
- OpenAI-kompatiblen API-Schlüssel in Open WebUI, Continue, LangChain und anderen Tools nutzen
- GPU pro Stunde oder API pro Token? Was ein 7B–8B-Modell wirklich kostet
- Ollama vs. vLLM vs. TGI: Inference-Benchmark auf der RTX 4090
- GPU mieten: Preisvergleich 2026
Quellen
Alle geprüft im September 2026.
- Download-Größen aus der Ollama-Bibliothek: mistral, qwen2.5, qwen3, qwen3.5, qwen3.6, llama3.1, llama3.3, deepseek-r1, Modellseite DeepSeek-R1 (Basismodelle der Distills), gemma3, gemma4, Modellseite Gemma 4 (MoE und aktive Parameter), mistral-nemo, mistral-small3.2, phi4, gpt-oss, Modellseite gpt-oss (MXFP4, Speicher), Übersicht der Ollama-Bibliothek
- Modellarchitektur: Modellkarte Qwen2.5-14B-Instruct, config.json von Qwen2.5-14B-Instruct, config.json von Qwen2.5-7B-Instruct, config.json von Llama-3.1-8B-Instruct (Spiegel von unsloth)
- Kontext- und Speichereinstellungen von Ollama: Ollama-Doku, Context length, Ollama-FAQ
- Quantisierungsgrößen und Bits pro Gewicht: README zu quantize in llama.cpp
- Perplexity nach Quantisierung: README zu perplexity in llama.cpp
- Benchmark-Studie zur Quantisierung: Uygar Kurt, Which Quantization Should I Use? (arXiv 2601.14277)
- Messungen zum CPU-Offload: Rost, 16 GB VRAM LLM benchmarks with llama.cpp (DEV Community, April 2026)
- Speichergrößen der GPUs: NVIDIA-Vergleich RTX 50 Serie, RTX 40 Serie, RTX 30 Serie, L40S, H100
- GPUFlow: Eine GPU mieten, Schritt für Schritt, API-Schnellstart, Erste Schritte für Anbieter